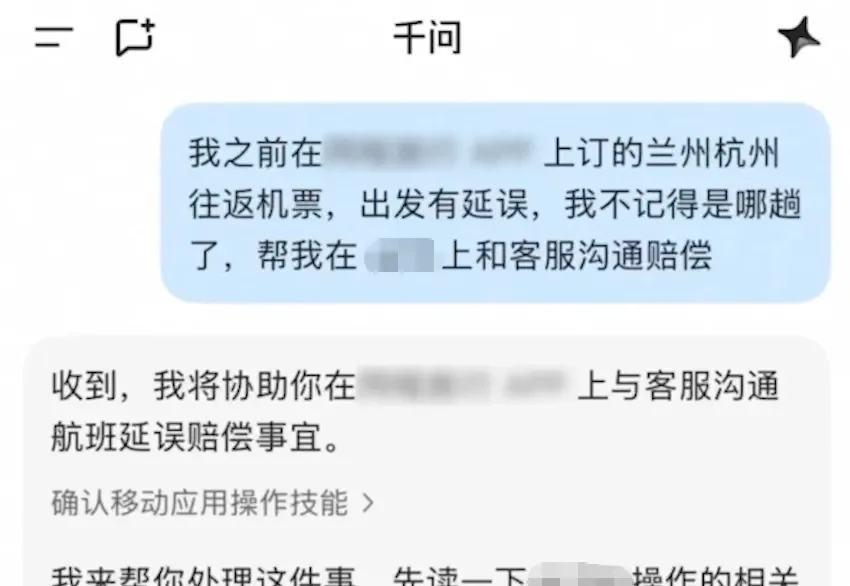
退差价、约保养、订球场、跟客服磨赔偿,千问Go什么都想管
退差价、约保养、订球场、跟客服磨赔偿,千问Go什么都想管今天千问搞了个大事情。
来自主题:
AI资讯
6419 点击 2026-10-13 14:08

 搜索
今天千问搞了个大事情。
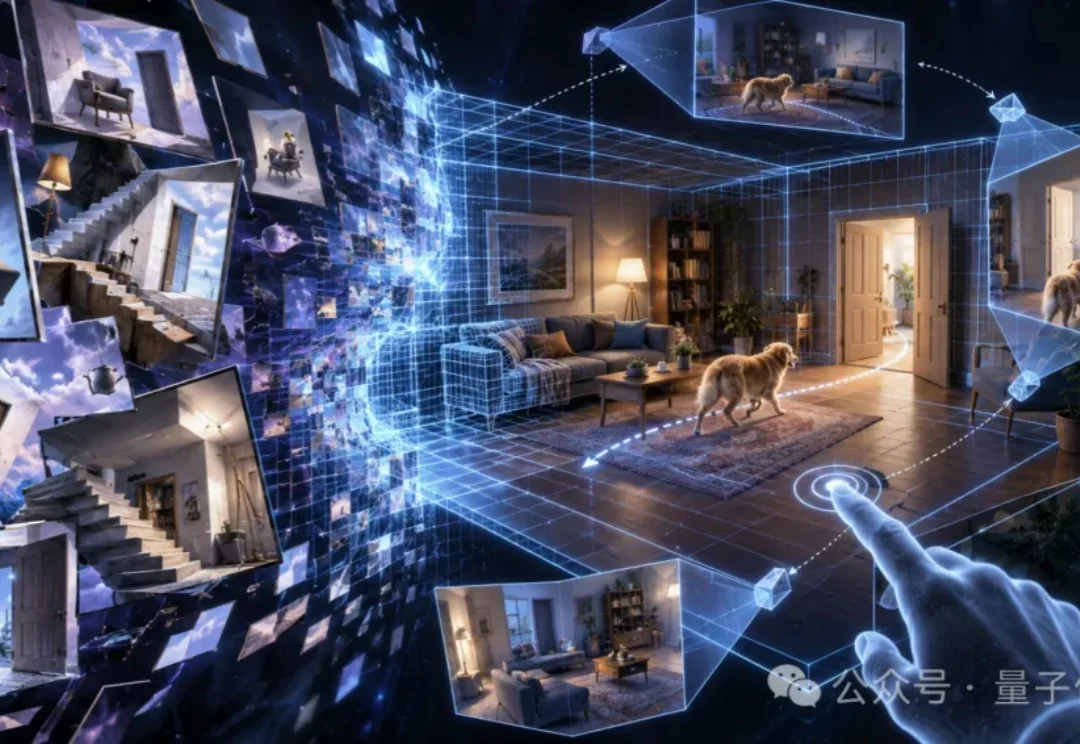
好家伙,字节这回直接把AI生成玩成开放世界了?!
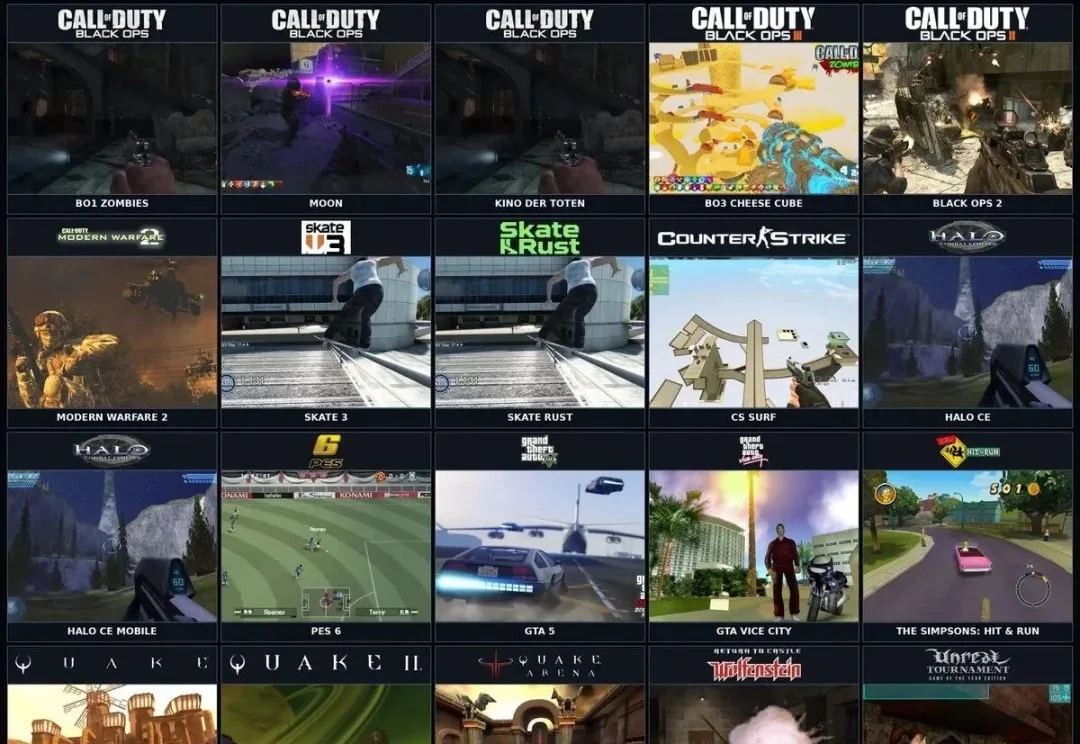
打开浏览器,输入网址,直接开打《使命召唤》、《GTA》?
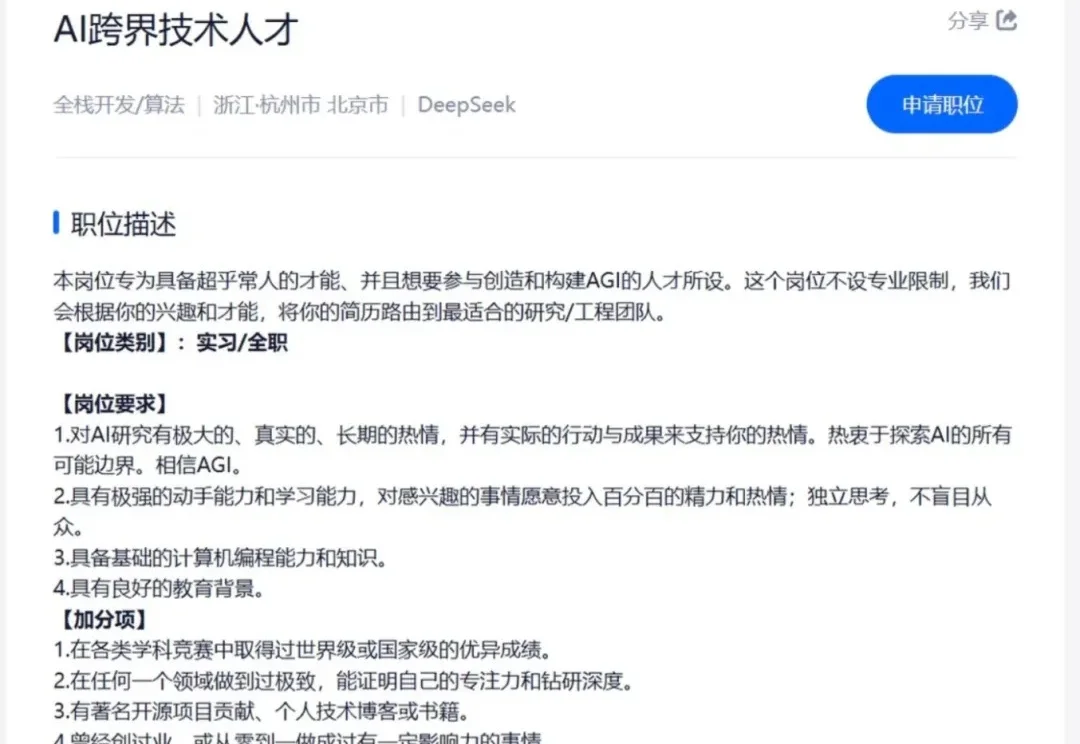
DeepSeek啊……你这岗位到底想招啥嘞?
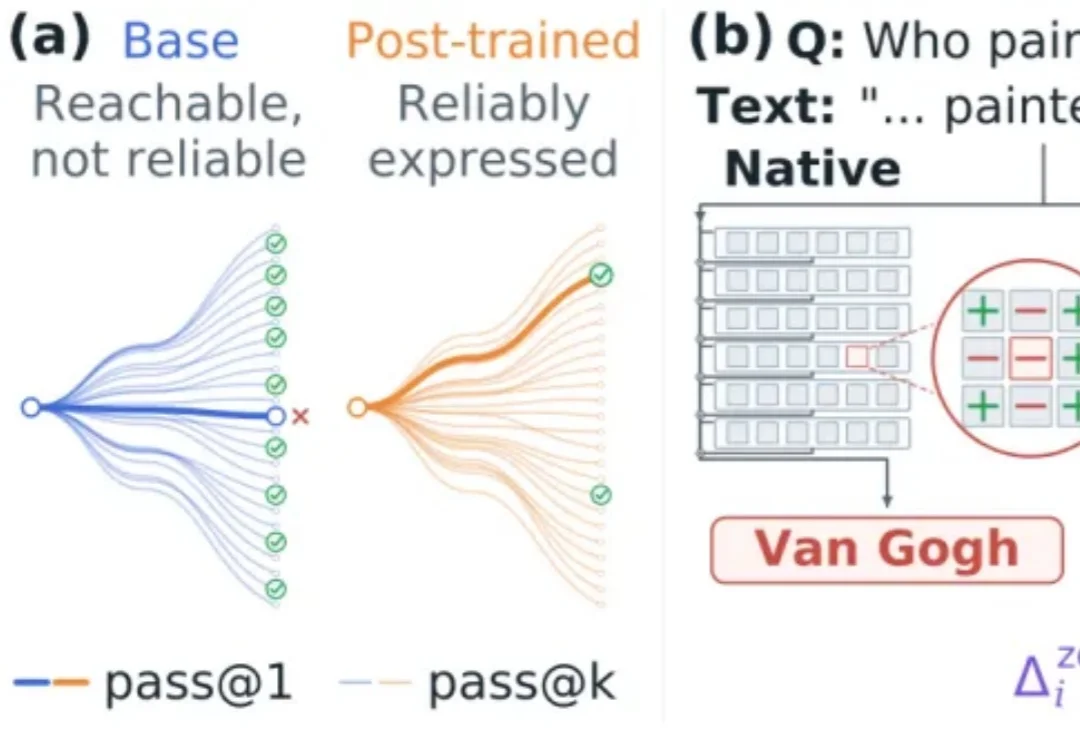
让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
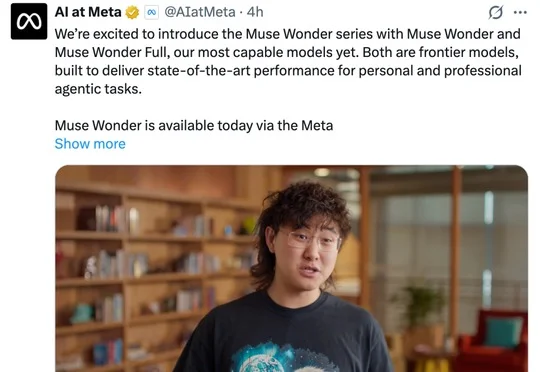
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
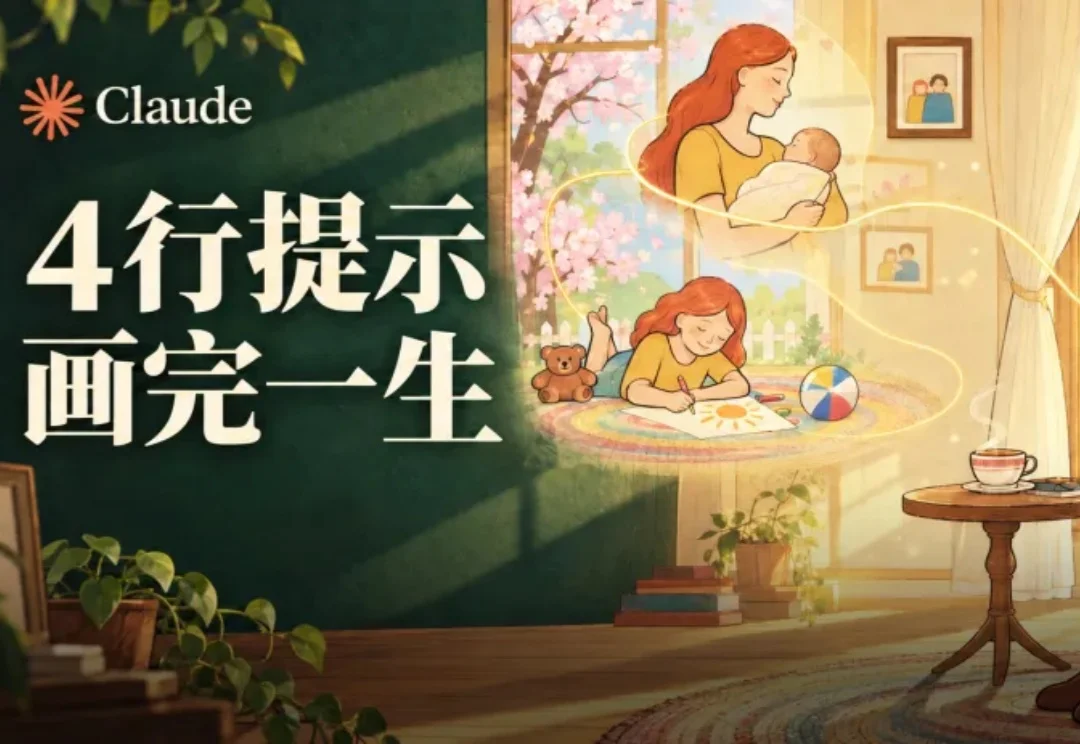
Anthropic,怕是又憋了个大的!
Z Potentials 独家获悉,上海半图科技(SemiGraph)已完成单轮超过千万美元融资,由联想创投等多家国内及海外一线资本领投,老股东IDG资本持续加码。本轮融资将主要用于人类行为模型研发、数据体系建设、团队扩充,以及AI原生3D互动场景的产品化落地。
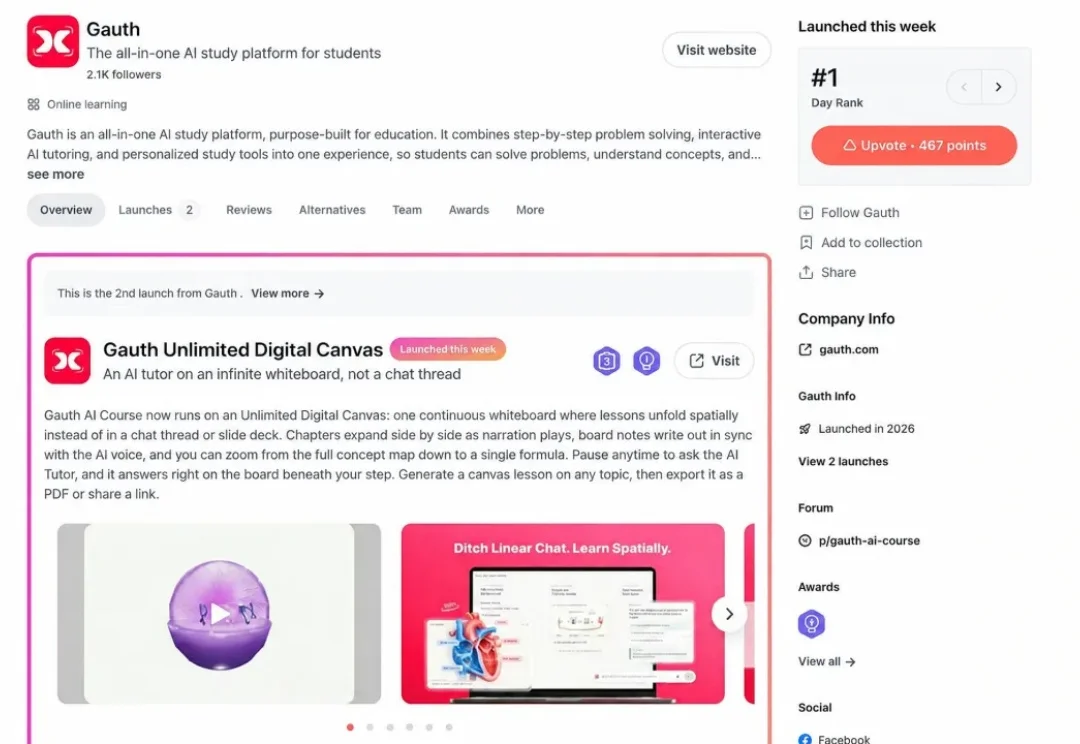
国庆前,海外各家大厂的Personal Agent产品下饺子一样出现。
A2A 商业马拉松,刚开跑。
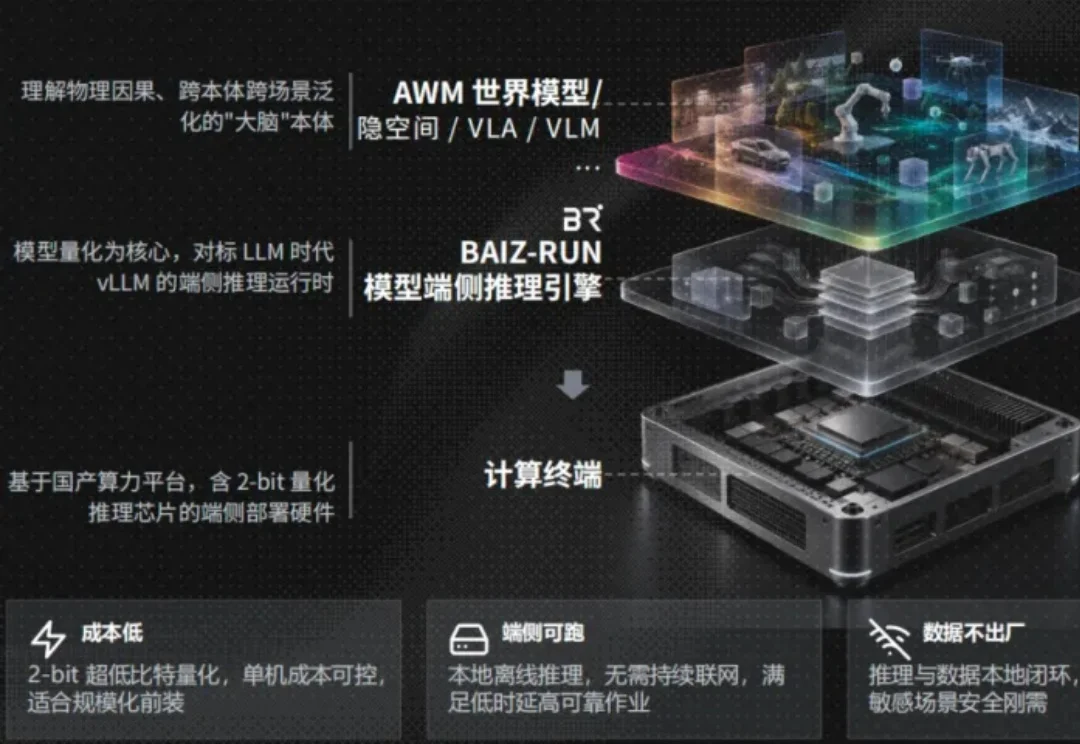
想象你站在一条产线旁边。
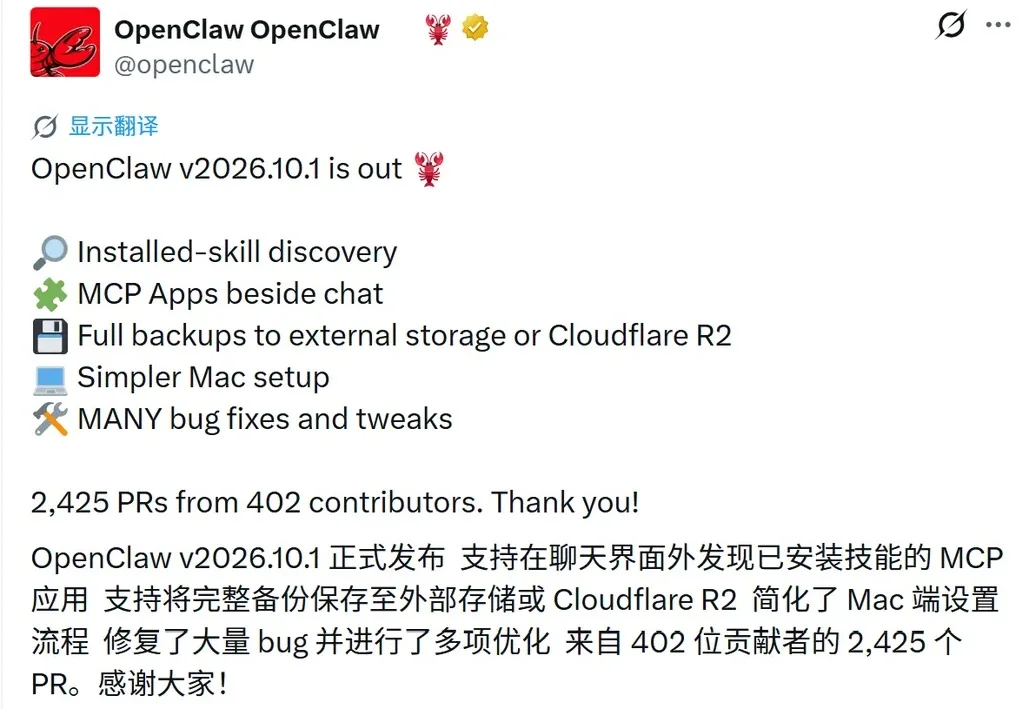
在无人在意的角落,OpenClaw 又更新了。
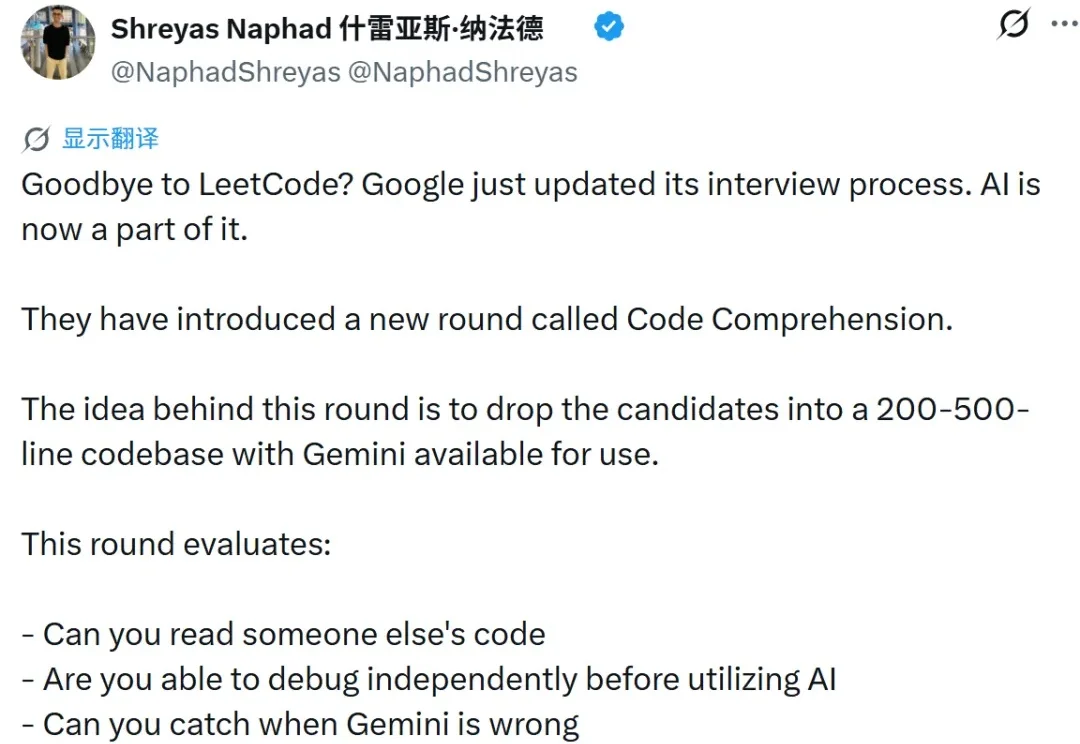
程序员面试的时候,终于可以光明正大地打开 AI 了。
大厂林立,独立AI Infra厂商凭何能冲出重围?
修 Bug、操作计算机、规划实验室操作、优化化学反应,甚至研究复杂的免疫系统。
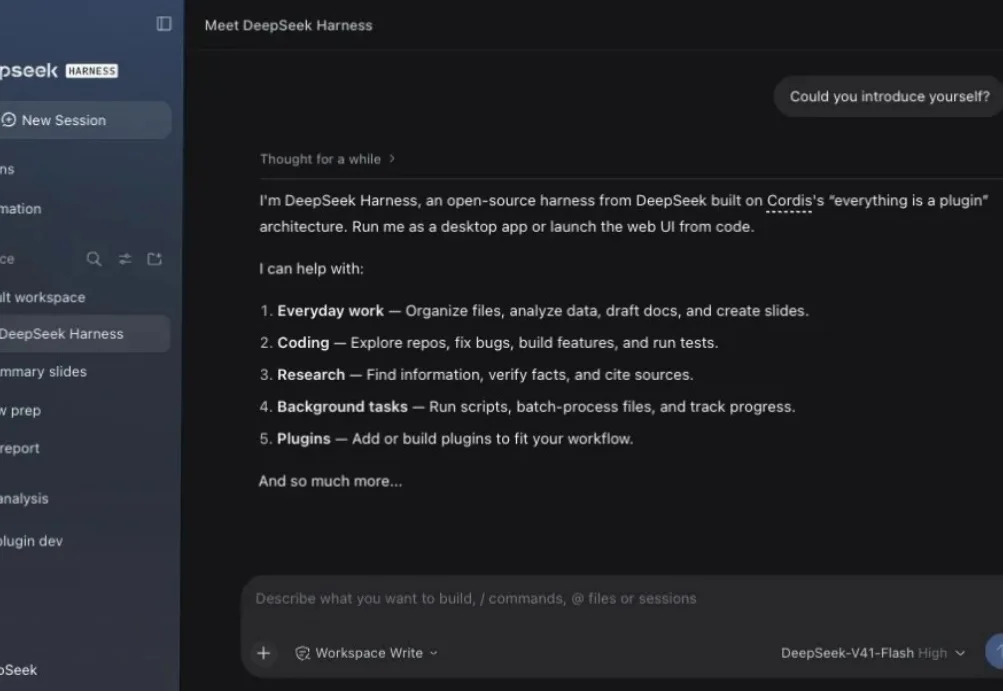
AI 兴盛以来,有许多路线争论,比如是垂类 AI vs 大而全,比如套壳vs模型,也比如 CLI(命令行) vs GUI(图形界面)、
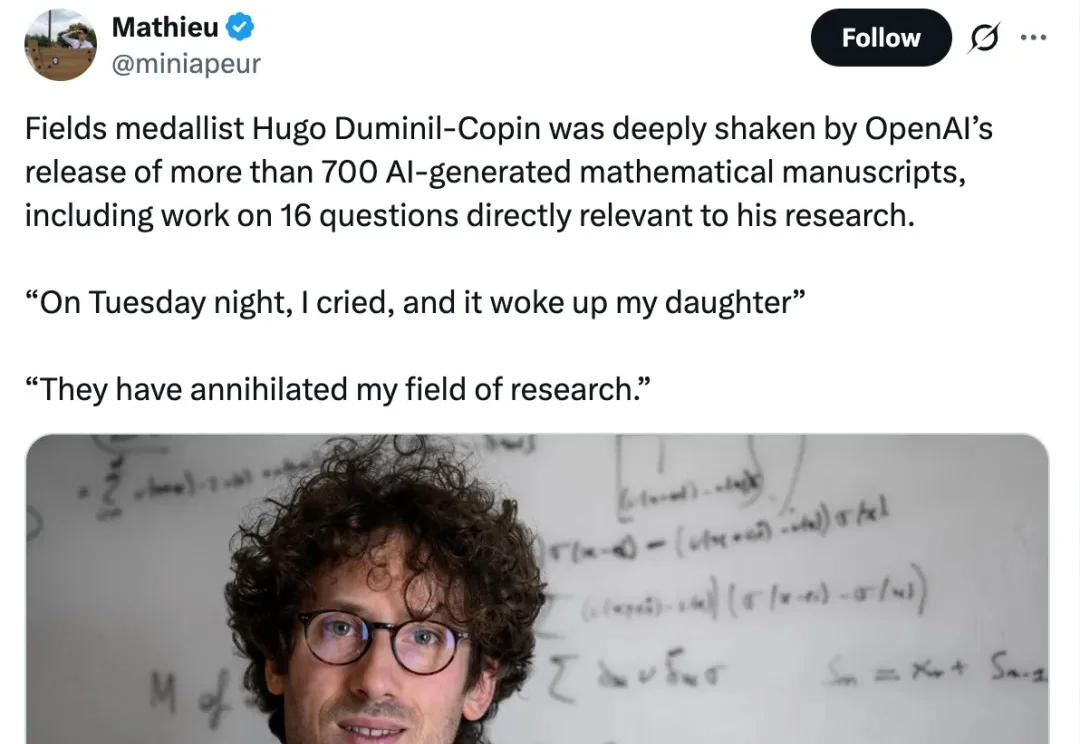
「他们彻底摧毁了我的研究领域。」
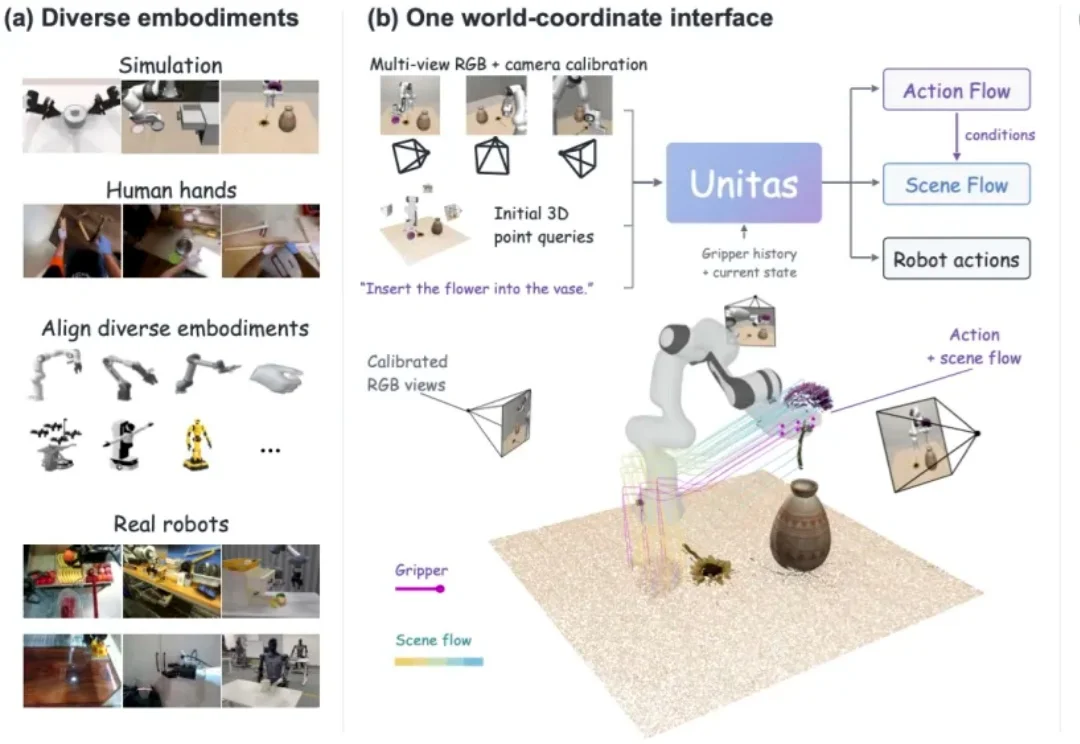
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?
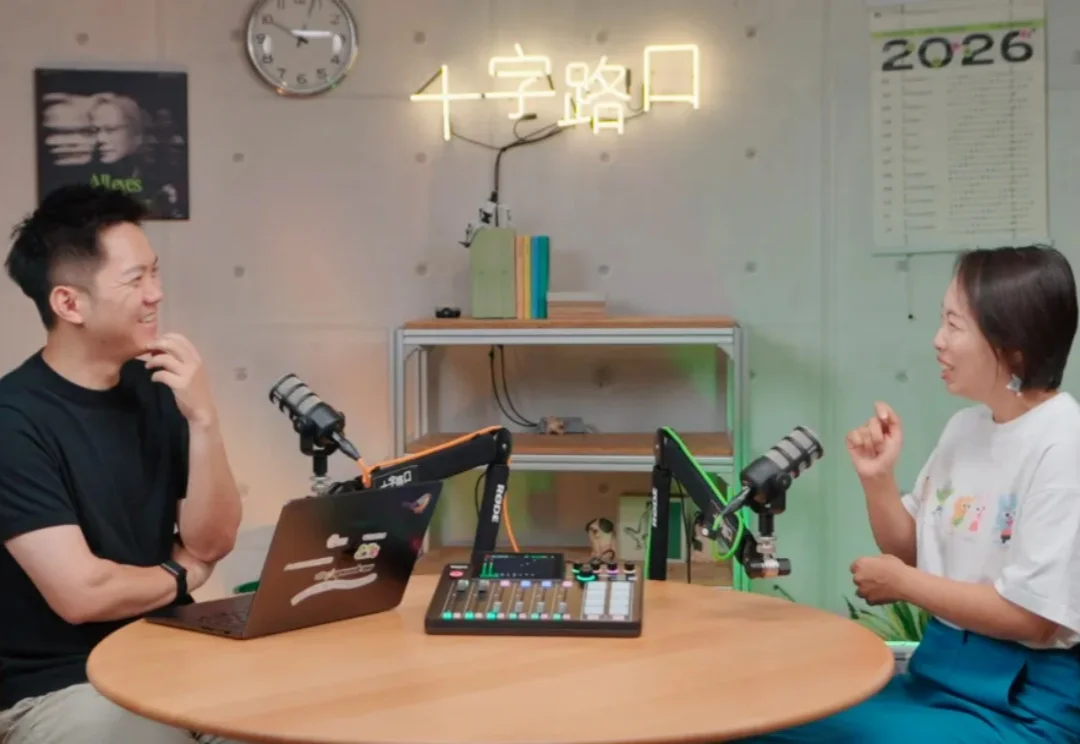
两年前,我原本和于红约好录一期播客聊 AI 投资。那时,她是美团龙珠合伙人,正带领团队 All in AI。
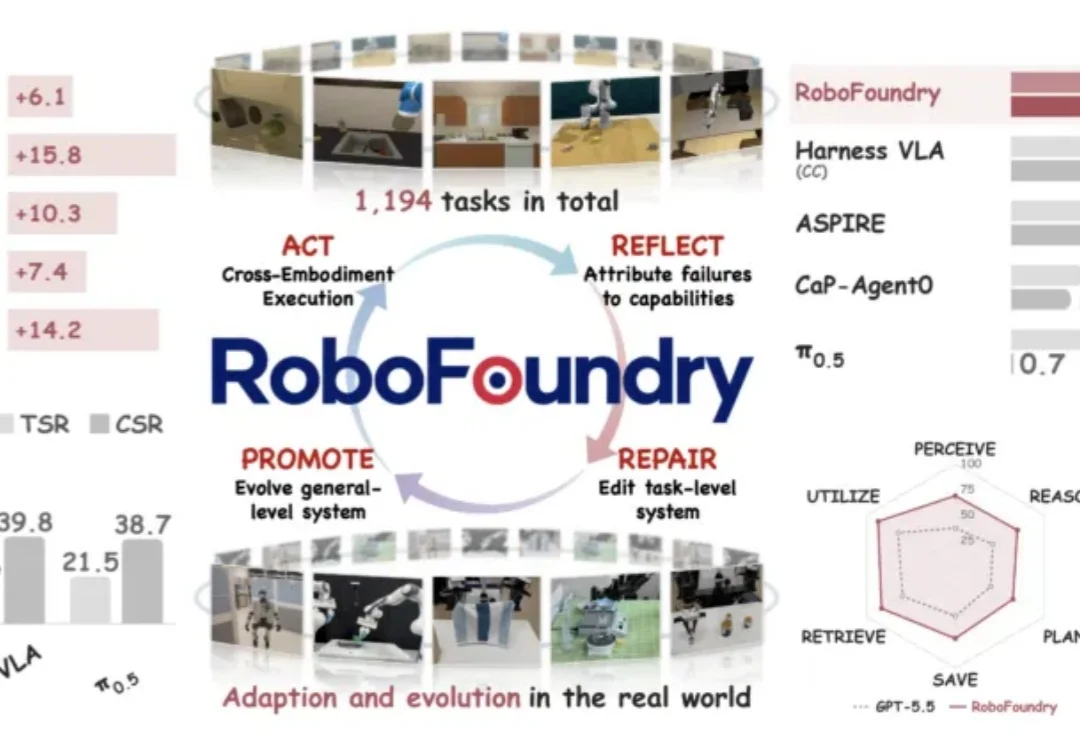
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
最近,全世界的数学圈都被AI核爆了。
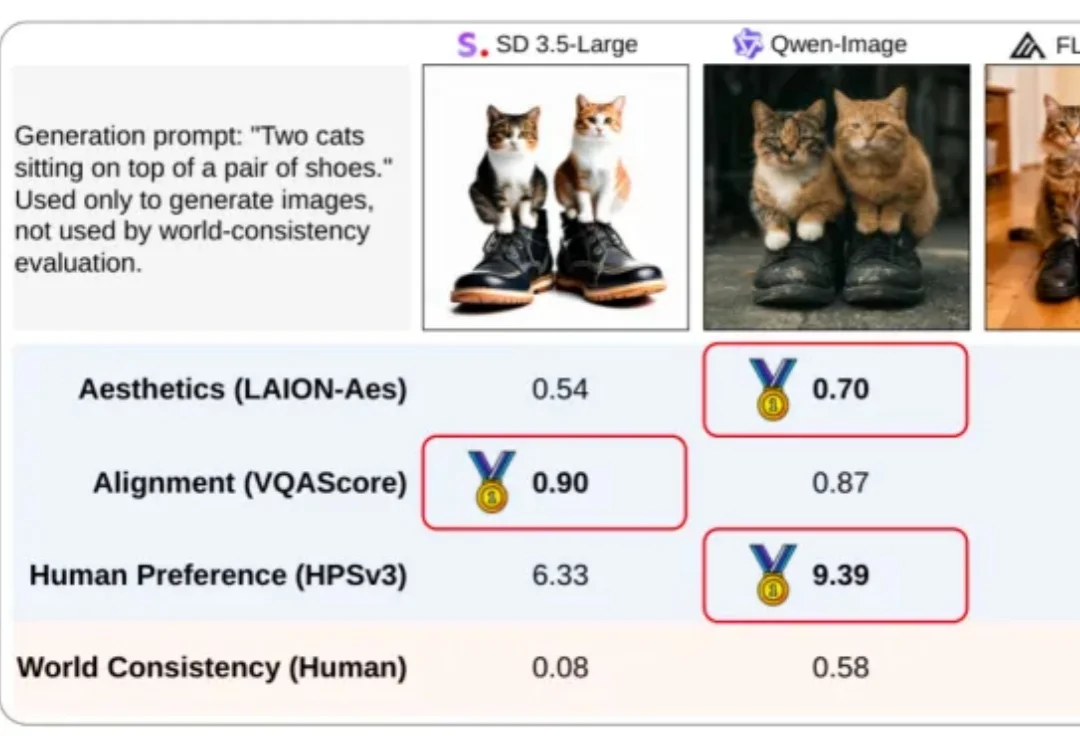
一张 AI 生成的图,可以在美学、提示词对齐和人类偏好指标上拿到高分,画面里却藏着扭曲的肢体、相互穿透的物体,或不合理的物理现象。这些错误,并不总能从现有分数中看出来。
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。
未来数字世界会是什么样?
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。
亚马逊正洽购AI公司Decart,潜在估值约70亿美元;Anthropic曾在约60亿美元交易谈判后放弃推进,Decart的DOS可适配多厂商芯片并提升AI训练与推理效率。
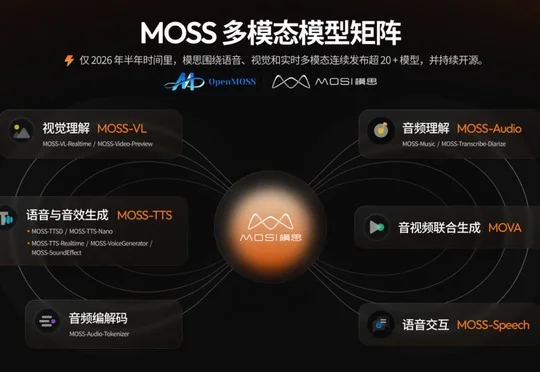
模思智能(MOSI)宣布完成超10亿元Pre-A轮融资,由华控基金领投,资金将用于全模态实时交互智能研发、能力建设及全球商业化落地。
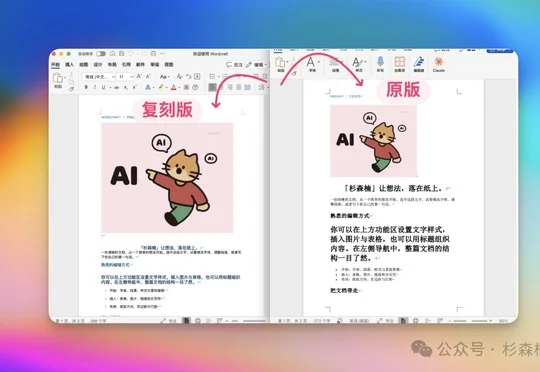
作者借助 GitHub 项目 REA 和 Codex GPT-6 Astra,在没有源代码的情况下迭代复刻 Microsoft Word,核心功能与界面高度还原,显示 AI 正显著降低成熟软件复刻门槛。
阿里国际站总裁张阔表示,模型榜单成绩提升未同步转化为电商任务体验,他将Agent竞争力概括为Model×Harness×Context,Accio Work基于107项开源电商任务的评测显示,前沿模型无人干预通过率仅约61%。
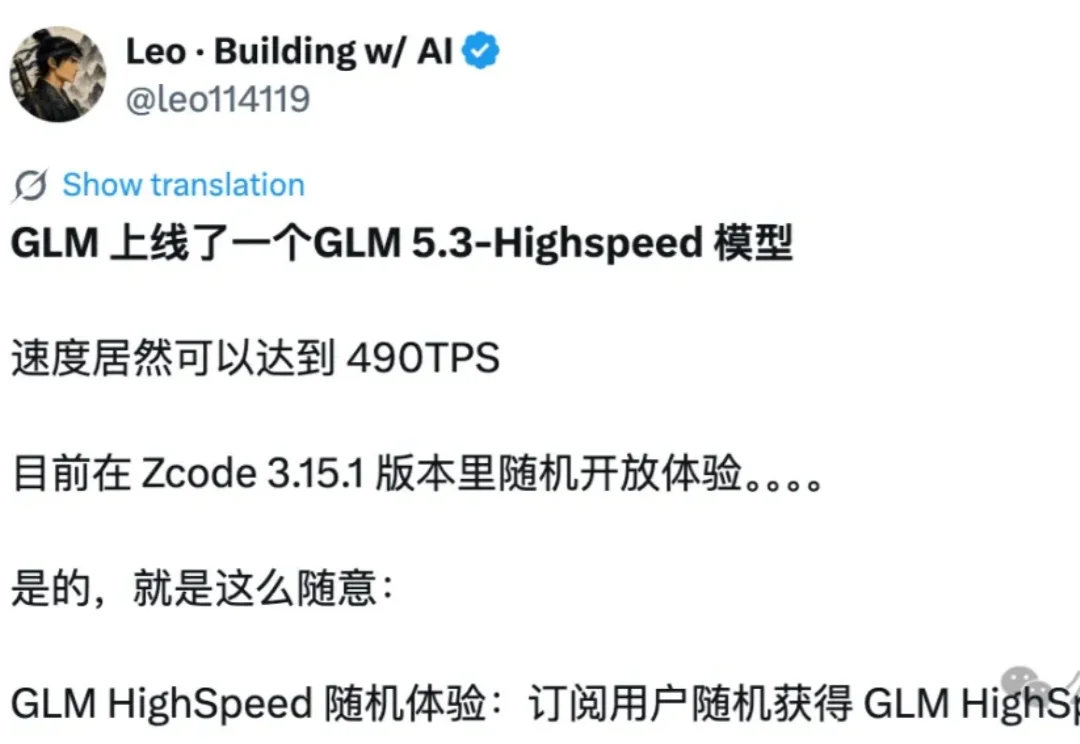
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。