
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
Agent 开始连续执行任务,对于模型的需求有了新变化。
随着任务链条的拉长,模型每一步的计算开销、长文本能力,都会影响最终的使用体验与成本,这让 Flash 档模型的重要性越来越强:它们更注重在能力、速度与成本之间找到平衡,承接那些高频和持续运行的工作。
11 月 5 日,百度文心系列正式发布新一代基座模型文心 5.5 Flash Base(ERNIE 5.5 Flash Base),并开放了权重。
这次发布的是一个稀疏 MoE 语言模型,总参数量 280B,每 token 激活 14B,其在 33.5T tokens 上从零完成预训练,最长的训练上下文为 128K,微调与推理阶段外扩到 1M tokens 的长上下文。
该模型已开放权重,并已联合 vLLM、SGLang 等社区提供开源生态支持。
此次文心发布的是一个「Base」模型,该模型已经具备了完整的通用能力,可作为后续所有训练的起点,人们可以在此基础之上进行领域适配、指令微调、强化学习,乃至面向 Agent 的行为塑造。这意味着开发者们可以自行决定模型下一阶段的方向。
更让人关注的是模型的性能与架构。这一次,百度在有限的激活参数与缓存预算下做出更强的基础能力。
同级别 SOTA 表现
当前,AI 应用即将进入「Super Agent」时代,在 token 消耗大幅膨胀、Agent 需要高频次、长时间自主运转的背景下,Flash 级模型会成为真正被大量使用的档位。对于模型本身而言,Agent 需要频繁读取海量环境事件,最大的瓶颈在于长上下文 Pre-fill(前缀预填充)和 KV Cache 内存占用,这方面的优化也是贯穿文心 5.5 Flash Base 设计的主线。
百度的目标是让所有激活参数、每字节 KV cache 都发挥出更大作用。基于这种思路,其团队在注意力、MoE、未来预测等具体组件上进行了大量技术创新。
该模型共有 43 层 Transformer,Hidden Size 4096,64 个注意力头。除第一层外,各层前馈网络都被替换为 MoE 块。其预训练采用 Muon 优化器与 FP8 混合精度,上下文在训练中逐步扩展至 128K,推理与微调阶段再外扩到 1M。
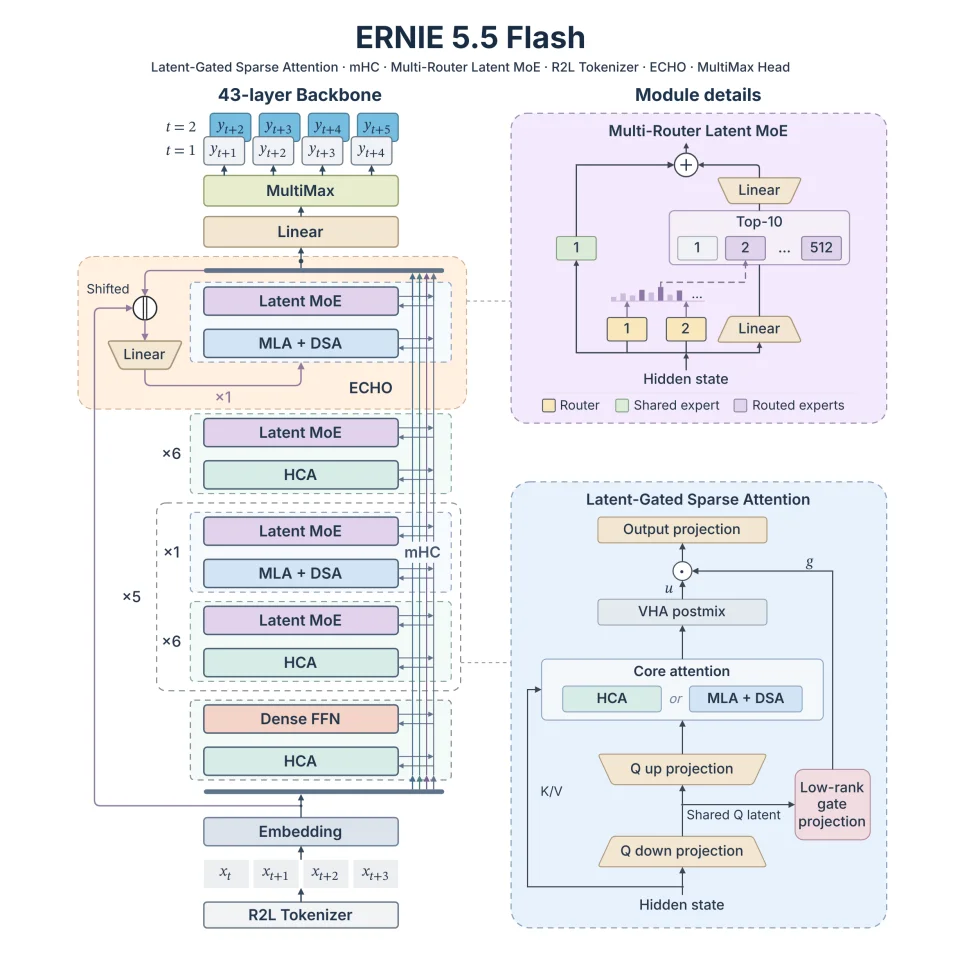
在官方给出的同级别模型对比中,文心 5.5 Flash Base 在知识、推理、数学、代码、多语言和长上下文等基准上整体领先,对手包括 DeepSeek-V4-Flash Base、Hy3-preview-Base 和 MiMo-V2.5-Base。
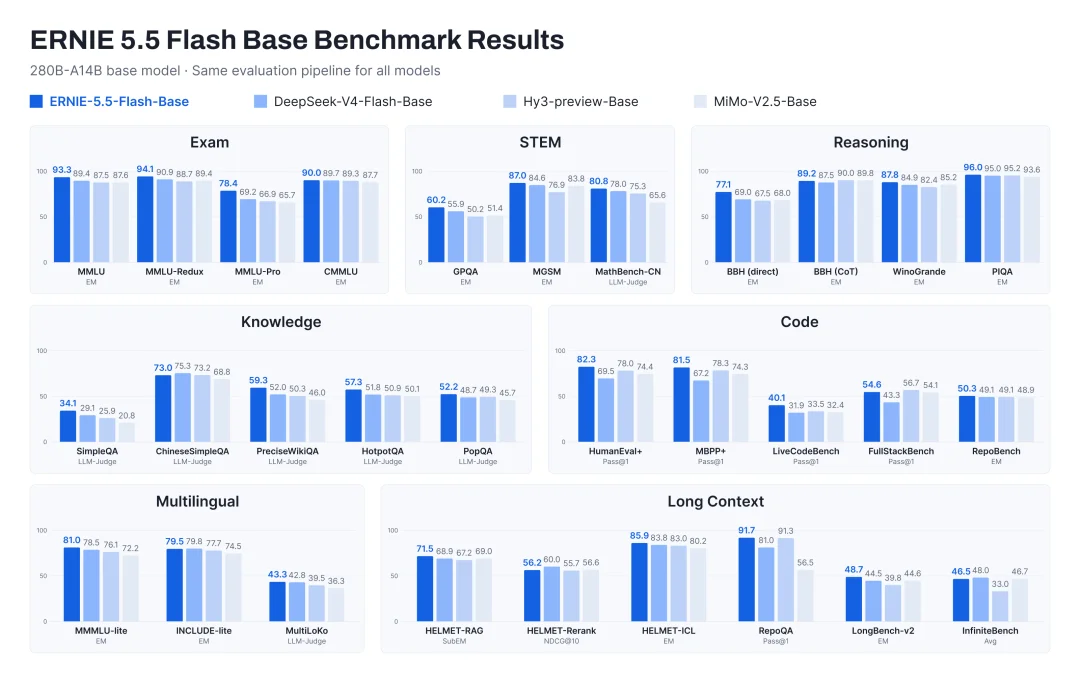
从与 DeepSeek-V4-Flash-Base(284B 参数、13B 激活)的逐项对比来看,文心新模型在学科与推理方面优势明显,代码能力是领先最大的板块:HumanEval + 为 82.3 对 69.5,LiveCodeBench 为 40.1 对 31.9,FullStackBench 为 54.6 对 43.3。不过,文心 5.5 Flash Base 在 ChineseSimpleQA 等少量评测上略有差距。
长上下文评测的成绩还验证了架构效率,文心 5.5 Flash Base 在六项长上下文基准整体稳健,「少数全量层加多数压缩层」的设计并未牺牲模型的长文本能力。
在这份成绩单背后,是文心团队对于模型架构的大量改进与创新。
混合稀疏注意力,1/7 全上下文访问
架构效率上,文心 5.5 Flash Base 使用混合稀疏注意力降低了推理成本。
Transformer 在处理长文本时每一层都要为全部历史 token 保存 KV cache,开销会随着上下文长度线性增长,这是推理成本的主要来源。百度对此的洞察是:并不是每一层都需要同样清晰地看清历史细节。
文心 5.5 Flash Base 采用 MLA 与 HCA 混合方案:每七层中只有一层保留对全上下文的 token 级访问,采用多头潜在注意力(MLA),其余六层采用重度压缩注意力(HCA),每 128 个 token 压缩为一条缓存条目,注意力只在压缩条目加上最近一小段未压缩窗口上计算。该模型 43 层中有 37 层是 HCA,仅 6 层是 MLA。
在长上下文推理时,MLA 层负责逐页精读,保留对每个原始 token 的访问,HCA 层则只关注章节摘要,对全部历史保持粗粒度视野,需要细节时再经由少数几层回溯。由于 HCA 层只需全上下文层 KV cache 的一小部分,整条模型的缓存开销被大幅压低。
六层 MLA 是逐 token 访问远距离历史的唯一通路,若在这些层做稠密注意力,长文本下它们会吞掉大部分计算。百度于是在 MLA 层引入稀疏注意力(DSA),通过轻量 indexer 为每个 query 对历史位置打分,让核心注意力只在得分最高的 top-k 位置计算,单 query 开销不再随上下文增长,而预训练 loss 与稠密注意力持平。
KV cache 预算有限时,已有的 CSA + HCA 做法是大量使用压缩稀疏注意力(CSA),先将历史压缩 4 倍再稀疏选取,百度在文心 5.5 Flash Base 上则是把预算集中给少数保留全部 token 的 MLA 层。预算相当的预训练对比显示,HCA 搭配 MLA 优于搭配 CSA,足以支撑细粒度检索。
在注意力层内,文心 5.5 Flash Base 也有两项改进。低秩门控注意力改用层内本就生成的低秩 query latent 计算输出门,因 latent 维度只有隐状态的四分之一,门投影参数量减少 75%,消融效果反而提升。另外,虚拟头注意力(VHA)以带恒等跳连的轻量跨头低秩混合增强信息融合,推理时可融合进算子,开销极小。
VHA 的相关论文《Virtual Head Attention》已被 NeurIPS 2026 接收。
多路由器 MoE, 同样成本选的更准
注意力决定了每个 token 以什么方式读取历史,而读取之后交给谁处理则是 MoE 层的职责。
MoE(混合专家模型)架构的目标是追求智能的密度,文心 5.5 Flash Base 对于 MoE 层进行深度设计,解决了做选择「武断」的问题。
传统 MoE 的工作流程是每个 token 进入 MoE 层,只用一个路由器打分,再通过一次硬 top-k 选专家。这个机制的问题在于打分与专家实际效用仅弱相关,在中深层尤其明显,另外因为落选专家拿不到该 token 的梯度,一旦选错很难纠正,错误会自我强化。
Multi-Router 让多个独立初始化的 sigmoid 路由器同时打分,把「一个路由器说了算」变成「多个路由器综合评定」。这些路由器的偏好各不相同,专家只要被某一个路由器强烈看好,或被几个同时看好,就可入选,单次误判不再决定结果,而激活专家数、FLOPs 与通信量与单路由器完全相同,在推理时没有额外的成本。官方称,路由打分与专家效用的相关性明显提升,原本最弱的中深层改善最大。
配置上,每个 MoE 块含 512 个路由专家、每次选 10 个,外加 1 个共享专家,负载均衡用无辅助损失的 bias 修正;token 先从 4096 维投影到 2048 维隐空间,专家在隐空间内计算后再映射回原空间,通信量与专家 FLOPs 约减半。Stable LatentMoE 设计(RMSNorm 加 SiTU-GLU 激活)让专家输出在 43 层中保持稳定尺度,每个专家的路由权重还乘以自己的可学习标量。
ECHO,连 MTP 模块都省了
文心 5.5 Flash Base 的第三项创新则换了个方向,指向一个更根本的问题:模型该用什么目标来学习。
多 token 预测(MTP)这一思路由 Meta 在 2024 年系统提出,在 DeepSeek V3 采用后被业界广泛使用,它让模型在训练时同时学习预测后面的多个 token,以更密集的监督信号训练模型的规划能力。它还可以兼任推理时投机解码的 draft 模型,一次先猜多个 token,验证后批量接受从而加速生成。
但常规 MTP 的问题在于,它在主干 Transformer 之外挂接一套专职模块来预测更远的 token,多步损失主要监督这些外挂,主干各层仍然只为下一个 token 服务。换句话说,长远规划的能力并没有被直接训练。
ECHO 没有单独增加 MTP Transformer 层,而选择让主干自身的最后一层同时承担未来 token 预测,多步损失因此直接作用于生成当前 token 的参数。让这些参数预测更远的 token,会迫使主干提前规划序列的后续展开。模型以单步 ECHO 完成预训练,在数学、推理与代码任务上取得明显收益。
这种设计额外带来了一个推理阶段的优势:承担未来预测的主干最后一层可以直接充当投机解码的内置 draft 模型,几乎不增加额外参数。值得关注的是,这一层还表现出涌现的外推能力:预训练时它只学了多预测 1 个 token,作为 draft 模型时却能连续向后起草多个 token,接受率高于用同样方式训练的外挂 MTP 模块。
从三项主要改进可以看出,百度这次的发力点具有前瞻性,当 Agent 开始高频、长时地自主运转,模型竞争的胜负手正在更关注效率,这正是文心 5.5 Flash Base 一上来就确定的主线。
更多结构改进、数据与基建
还有几项组件级更新。在残差连接上,流形约束超连接(mHC)替代标准残差结构,每层通过受约束混合矩阵读写 4 条并行残差流,以近零成本拓宽层间残差带宽,与近年业界的超连接思路一脉相承。
输出头上,MultiMax 针对单一 softmax 温度只能在稀疏性与多峰性间二选一的问题引入可学习分段温度,既压制不合理 token 的长尾,又保留合理候选的多样性,训练开销可忽略且不增加显存。
分词器方面,全新 BPE 词表约 200K,数字采用从右到左、三位一组切分,如 1,234,567 被切为 1、234、567,使数位对齐,对算术和数字密集文本更友好。
在数据一侧,百度重点建设三个方向。网页数据结合多语言抓取、高保真抽取与模型驱动的质量过滤;代码数据在静态代码之外,补充 commit、issue、pull request、代码评审、自动测试与经 CI 验证的修复等软件演化数据,指向仓库级推理与 Agent 软件工程,与 Base 定位呼应;长文数据则包括天然长文档、干扰文本拼接的长序列,以及合成的检索与多跳问答数据。
基建一侧,百度让分布式 Muon 优化器在数千卡规模下保持高效。Muon 采用逐张量正交化更新,改变了通信模式。百度把 Dense 参数从跨机大环通信改走同号卡路径,并与 MoE 通信融合为单次集合通信,同时以节点间均衡切分把优化器状态摊开,避免少数节点显存压力过高。
另外,百度提出了面向大 head dim 的算子 FlashMask-4,基于 CuTe-DSL 实现支持 SM90 与 SM100 架构,可支持 qk 头 576 维、v 头 512 维。SM100 上其前向性能最高提升 175%,反向最高提升 74%。该算子已在 PaddlePaddle 的 GitHub 仓库开源。
这些模型背后的基建能力,是百度在深度学习框架与大规模训练上持续投入多年的成果。
综上可知,在文心 5.5 Flash Base 上,百度用一次完整的大规模预训练验证了众多技术改进在同一架构下的增益效果。真实部署将是检验这套范式的下一步。
Base 只是起点
把一个 Base 模型开放出来,也意味着把后续发展的空间更多地交给开发者,某种程度上来说,开放 Base 比开放 Chat 版更需要底气。预训练终点的权重相当于直接展示能力成色。愿意把这样的 checkpoint 交给社区检验是对于预训练能力的一种自信。
基于开放的 Base 权重,基础模型可以被纳入开发者的二次训练流水线,生长出更丰富的生态。一个可以直接复用的高质量基座,意味着企业级开发者不必从零起步就能训练服务本地语言、文化与产业场景的模型。
在文心 5.5 Flash Base 模型上,从长文本注意力读取,到 MoE 路由专家调用,再到 ECHO 尝试让主干更直接地学习预测未来,围绕实际使用的设计也给更有价值的任务提供了支撑。未来在同样的计算资源条件下,AI 有机会支持更长的任务链条、更多轮的尝试与反馈,进而实现前所未有的应用方式。
文心 5.5 Flash 正式版预计很快也会发布。在这条有着众多玩家的赛道上,权重开放只是入场券,能不能在牌桌上坐稳,还要看正式版能否兑现基座的潜力。对于用户们而言,文心的到来意味着又多了一个选择,未来 Flash 档的竞争还会更加激烈,还会有更加便宜且强大的模型。
接下来,就等正式版登场了。
文章来自于微信公众号 “机器之心”,作者 “机器之心”

【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
