GitHub Copilot 加入基于 AI 的代码密码扫描功能
GitHub Copilot 加入基于 AI 的代码密码扫描功能GitHub 在其 Copilot 功能中引入了一项基于 AI 的密码扫描功能,该功能已经整合到 GitHub Secret Protection 中。
来自主题: AI技术研报
9223 点击 2025-04-13 13:36

 搜索
GitHub 在其 Copilot 功能中引入了一项基于 AI 的密码扫描功能,该功能已经整合到 GitHub Secret Protection 中。
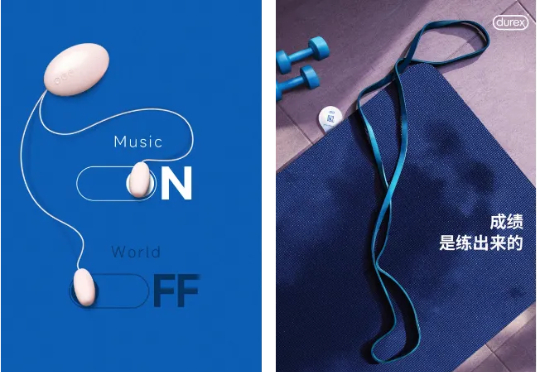
如果你没有杜蕾斯背后强大的5A广告公司、鬼才般的创意团队、句句封神的的金牌文案、审美爆辣的视觉艺术家。借助即梦刚上线的3.0生图模型以及 Deepseek生创意和文案,你也可以轻松复刻一个「杜蕾斯级别」的刷屏海报。
人和智能体共享奖励参数,这才是强化学习正确的方向?
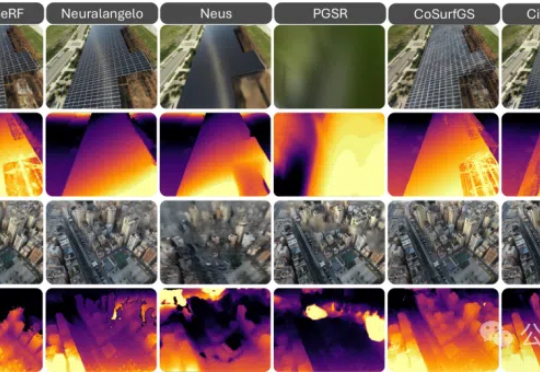
仅用4090就能实现大规模城市场景重建!

在大模型争霸的时代,算力与效率的平衡成为决定胜负的关键。
AI Agent 领域也存在 scaling law,甚至还在加速。

简单分享一份下线 AI 产品的信息列表(AI Graveyard),里面囊括的产品小类非常多。
高质量数据枯竭,传统预训练走向终点,大模型如何突破瓶颈?
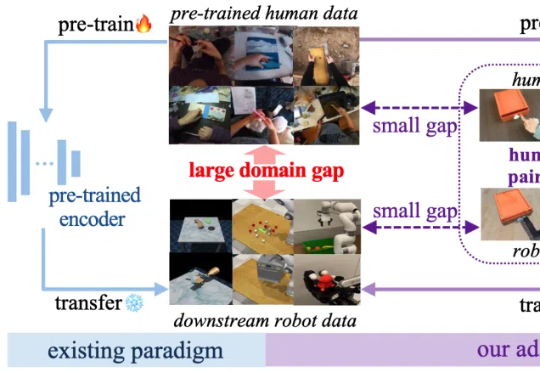
“让机器人看懂世界、听懂指令、动手干活”正从科幻走向现实。
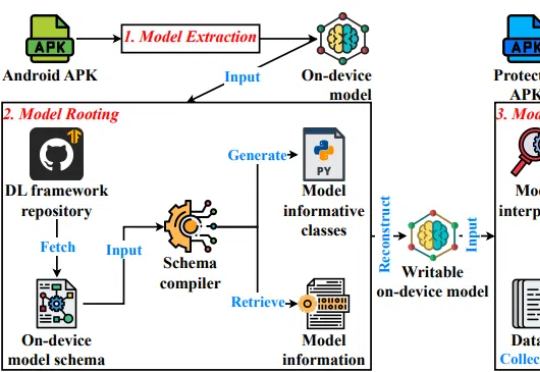
随着智能手机和物联网设备普及,移动端AI成为趋势,带来离线运行、低延迟、隐私保护等优势。然而,模型本地存储同时带来了严重风险。
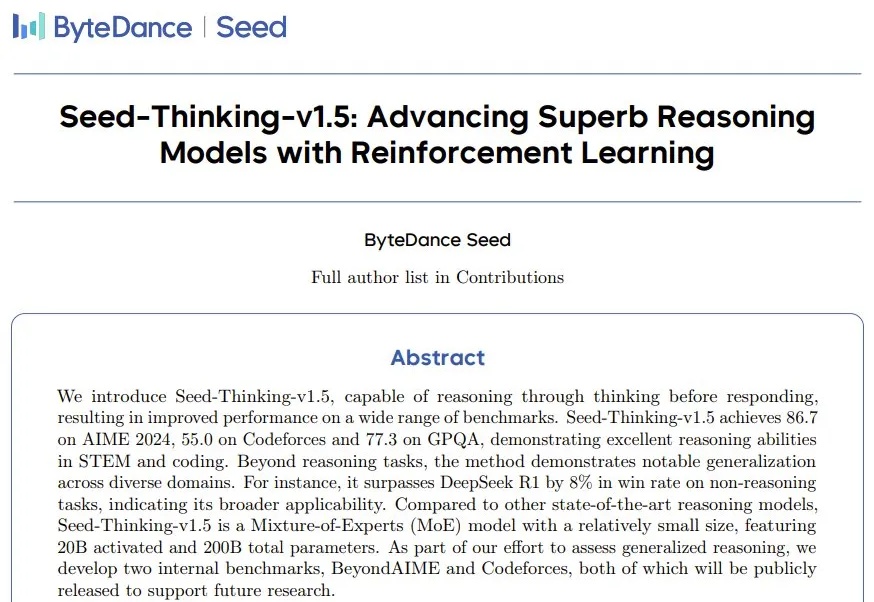
字节跳动豆包团队今天发布了自家新推理模型 Seed-Thinking-v1.5 的技术报告。从报告中可以看到,这是一个拥有 200B 总参数的 MoE 模型,每次工作时会激活其中 20B 参数。其表现非常惊艳,在各个领域的基准上都超过了拥有 671B 总参数的 DeepSeek-R1。有人猜测,这就是字节豆包目前正在使用的深度思考模型。
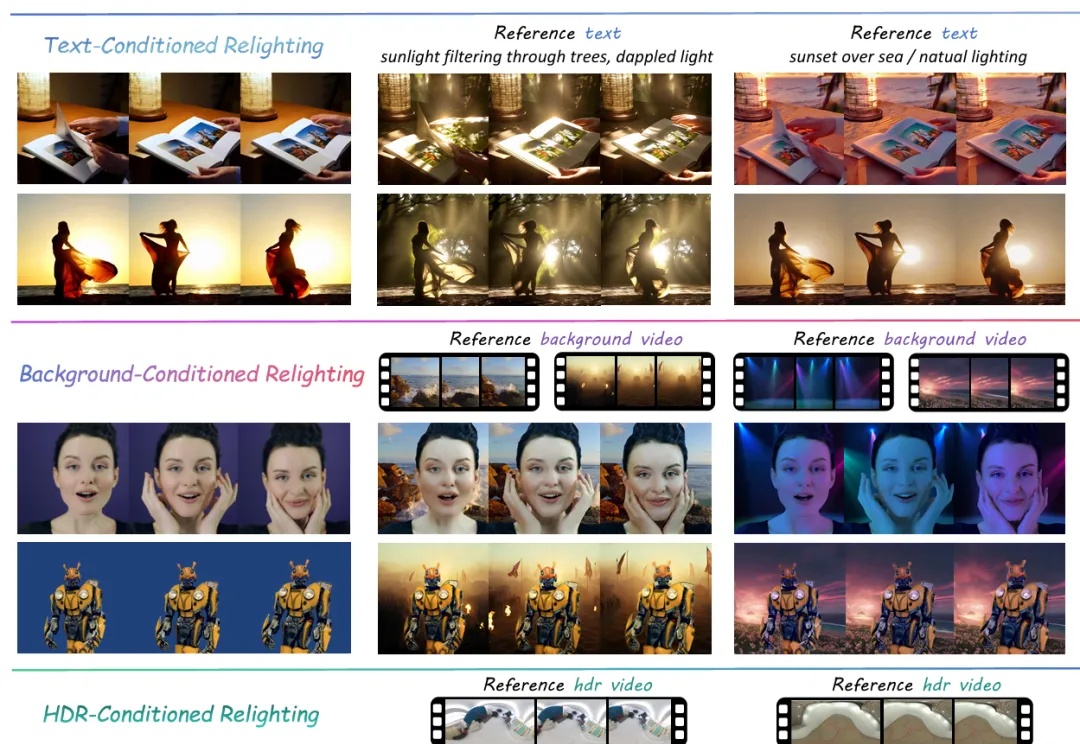
大家还记得那个 ICLR 2025 首次满分接收、彻底颠覆静态图像光照编辑的工作 IC-Light 吗?

报告深入分析了特朗普总统于2025年4月2日宣布的“解放日”关税措施对美国人工智能(AI)基础设施建设、相关供应链以及全球贸易格局的潜在影响。
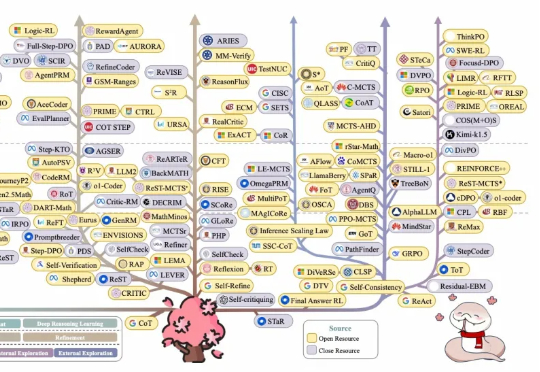
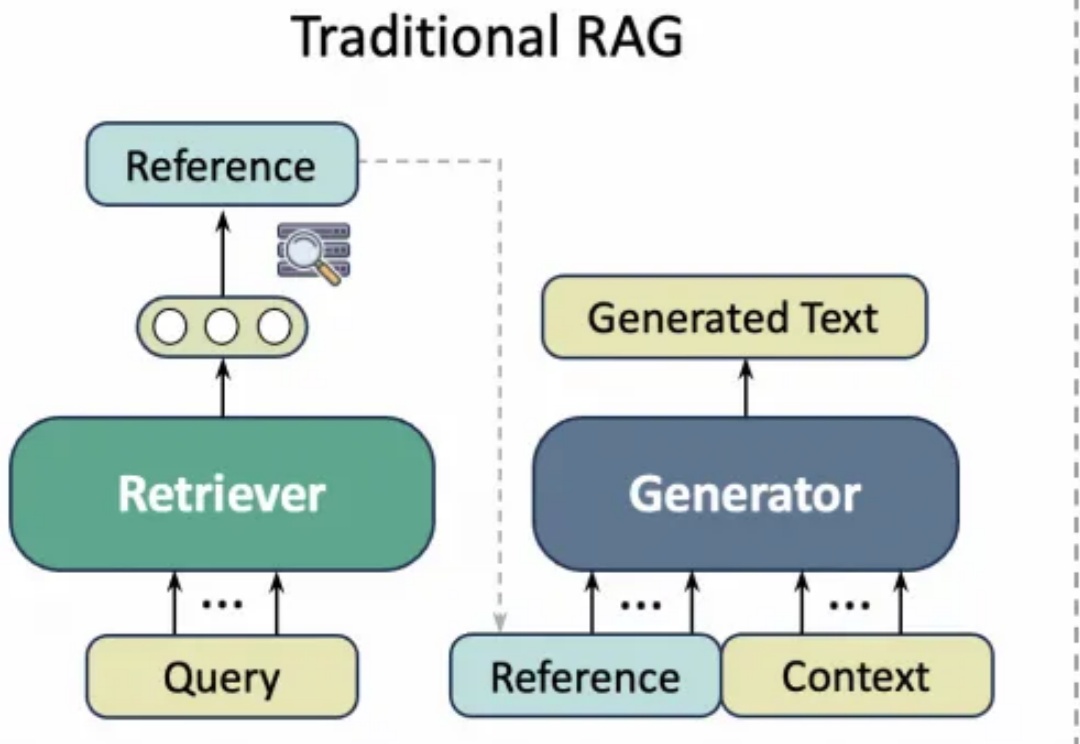
随着技术的深入应用,如何高效利用大模型技术优化用户体验,同时应对其带来的诸多挑战?本文将从RAG的发展趋势、技术挑战、核心举措以及未来展望四个维度总结我们应对挑战的新的思路和方法。
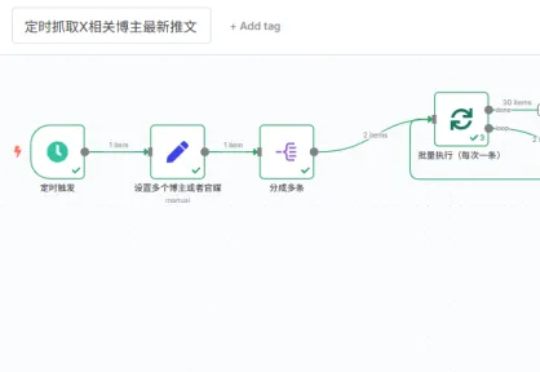
前两天给大家分享了一个我认为最强的开源AI Workflow平台:n8n。经过这几天的研究,我用n8n实现了一套超实用的X(原Twitter)热点监控workflow(工作流)。它由两个workflow(工作流)组成
学术写作通常需要花费大量精力查询文献引用,而以ChatGPT、GPT-4等为代表的通用大语言模型(LLM)虽然能够生成流畅文本,但经常出现“引用幻觉”(Citation Hallucination),即模型凭空捏造文献引用。这种现象严重影响了学术论文的可信度与专业性。
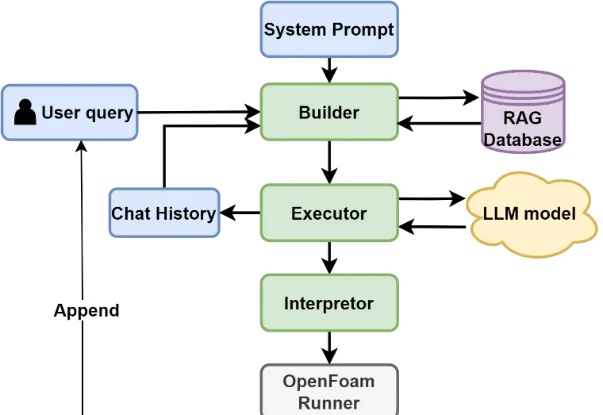
又一专业领域成功引入AI工程师!
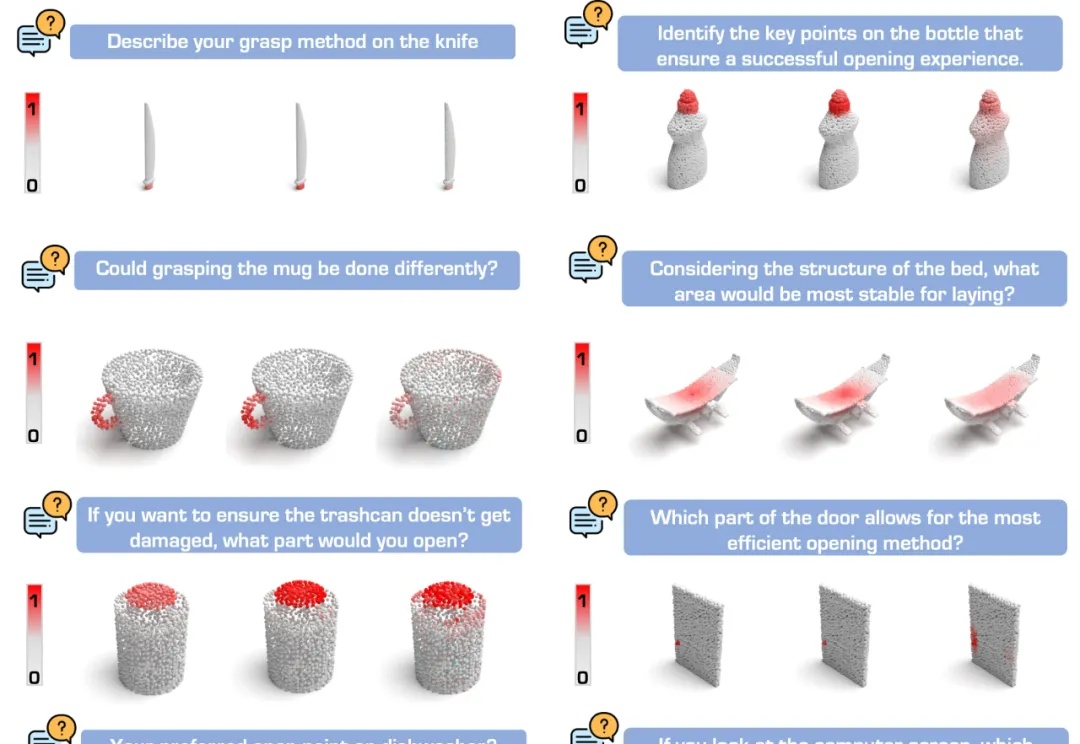
在现实世界中,如何让智能体理解并挖掘 3D 场景中可交互的部位(Affordance)对于机器人操作与人机交互至关重要。所谓 3D Affordance Learning,就是希望模型能够根据视觉和语言线索,自动推理出物体可供哪些操作、以及可交互区域的空间位置,从而为机器人或人工智能系统提供对物体潜在操作方式的理解。
港中文、清华等高校提出SICOG框架,通过预训练、推理优化和后训练协同,引入自生成数据闭环和结构化感知推理机制,实现模型自我进化,为大模型发展提供新思路。
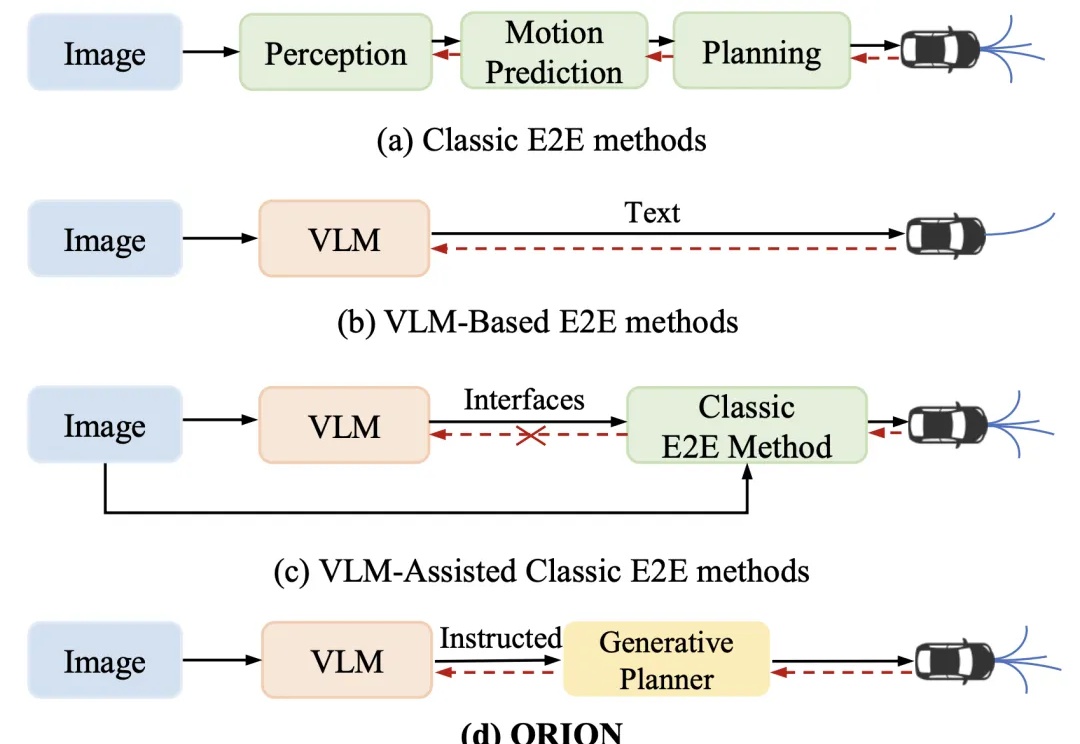
近年来,端到端(End-to-End,E2E)自动驾驶技术不断进步,但在复杂的闭环交互环境中,由于其因果推理能力有限,仍然难以做出准确决策。虽然视觉 - 语言大模型(Vision-Language Model,VLM)凭借其卓越的理解和推理能力,为端到端自动驾驶带来了新的希望,但现有方法在 VLM 的语义推理空间和纯数值轨迹的行动空间之间仍然存在巨大鸿沟。
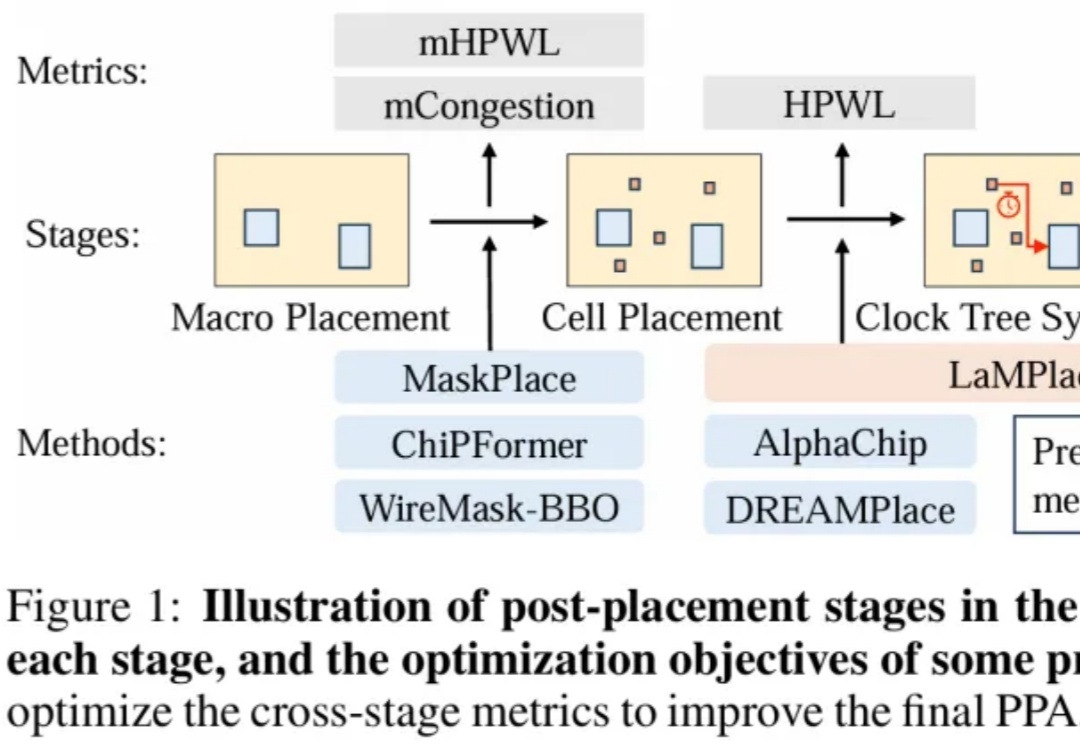
用AI指导芯片设计,中科大王杰教授团队、华为诺亚实验室、天津大学提出全新芯片宏单元布局优化方法LaMPlace!

刚刚,Kimi团队上新了!
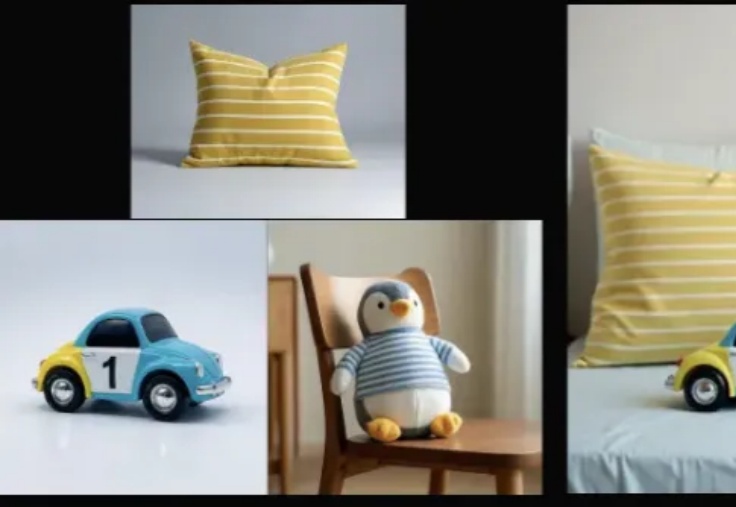
利用字节团队魔改的FLUX模型,可以直接把多个参考主体放进一张图了。
谷歌Deep Research重大升级,搭载全球顶尖Gemini 2.5 Pro模型。5分钟生成46页学术论文、复杂报告转为10分钟播客。性能超OpenAI DR 40%,价格仅为其1/10。
世界模型领域最新进展,要比拼“世界生成”了。
OpenAI o1/o3-mini级别的代码推理模型竟被抢先开源!UC伯克利和Together AI联合推出的DeepCoder-14B-Preview,仅14B参数就能媲美o3-mini,开源代码、数据集一应俱全,免费使用。
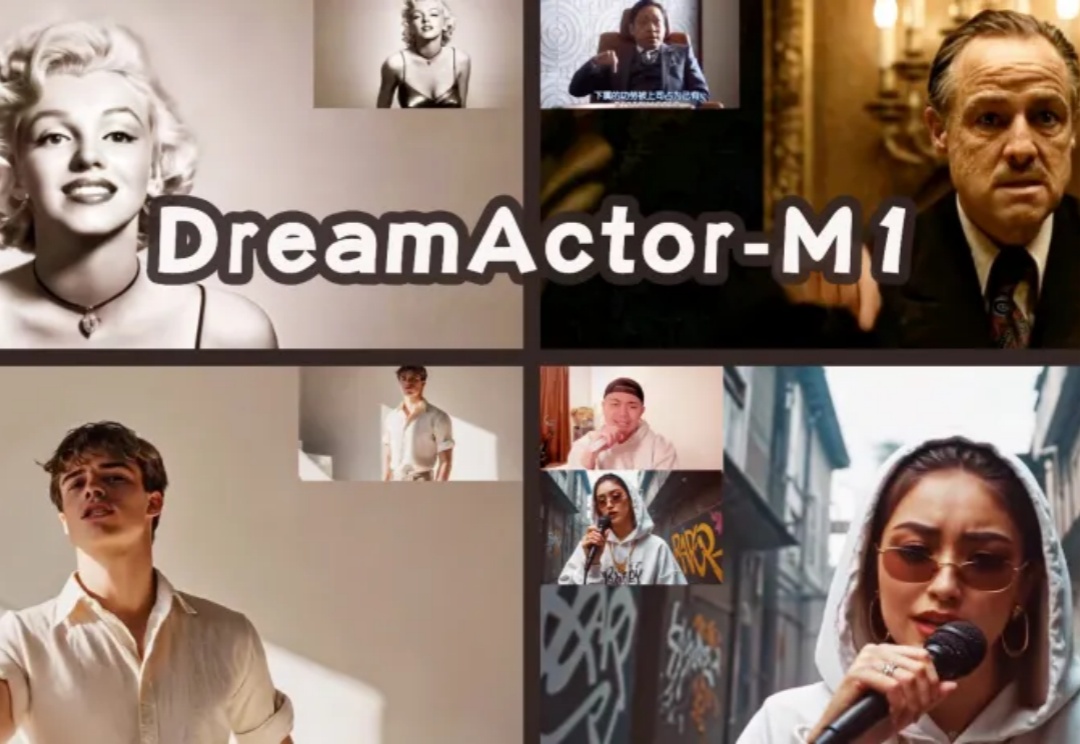
自数字人技术Omnihuman-1引起行业关注之后,字节智能创作团队再放大招。全新DreamActor-M1横空出世,一张照片一段视频,就能生成电影级视频,精准迁移表情动作,还支持多种画风。
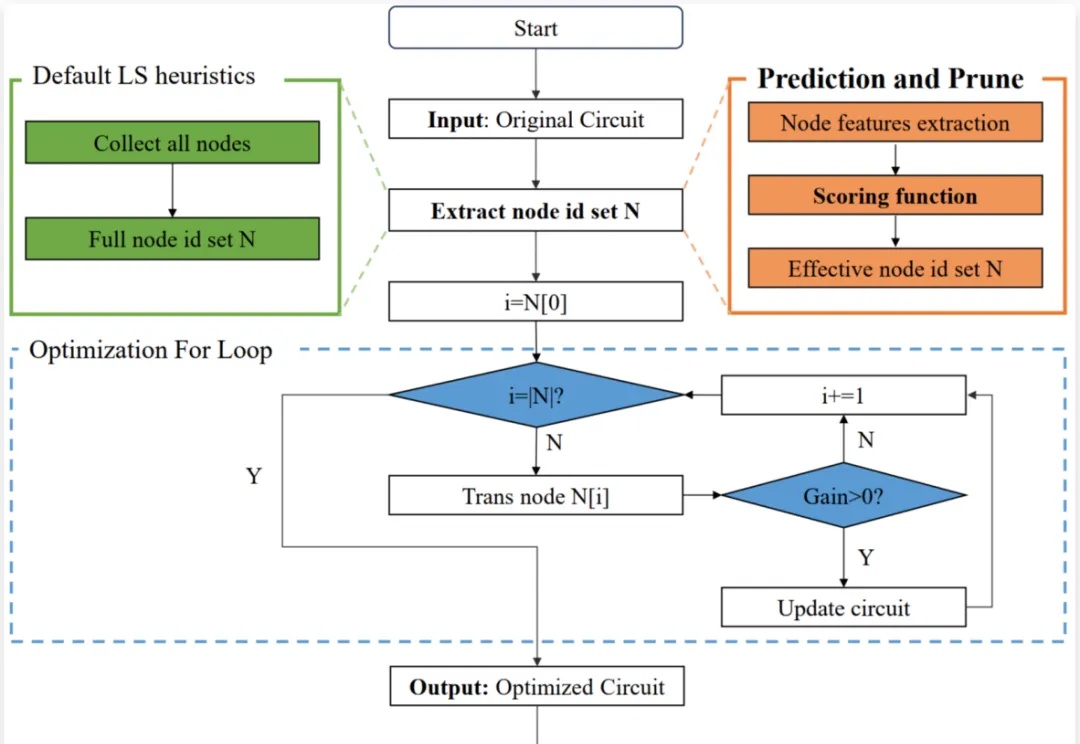
芯片设计是现代科技的核心,逻辑优化(Logic Optimization, LO)作为芯片设计流程中的关键环节,其效率直接影响着芯片设计的整体性能。
北京大学陈宝权教授团队提出RainyGS技术,通过结合物理模拟和3D高斯泼溅渲染框架,实现了真实场景中动态雨效的高质量仿真与呈现,真正实现「从真实到真实」,或者「以仿真乱真」,即Real2Sim2Real !相比现有的视频编辑工具(如 Runway),其物理真实性获得保证。
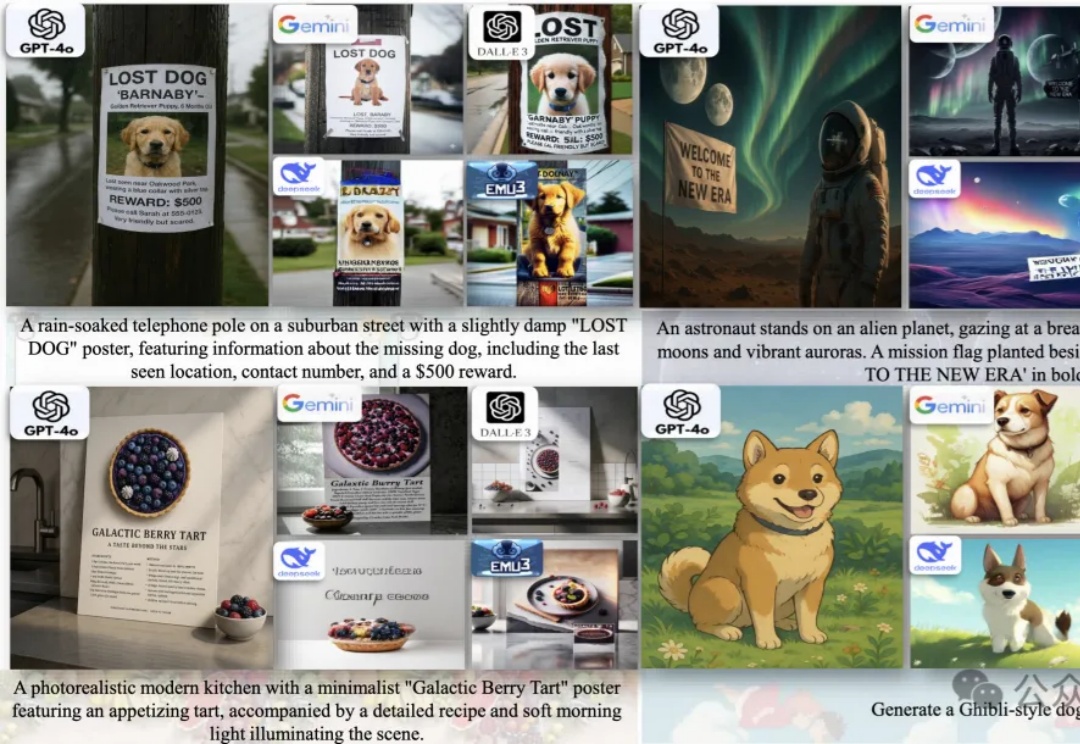
统一多模态大模型(U-MLLMs)逐渐成为研究热点,近期GPT-4o,Gemini-2.0-flash都展现出了非凡的理解和生成能力,而且还能实现跨模态输入输出,比如图像+文本输入,生成图像或文本。