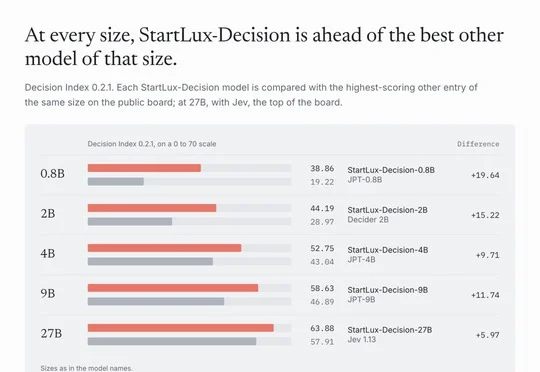
Jev被请下王座,StartLux中国开源决策模型冲上第一
Jev被请下王座,StartLux中国开源决策模型冲上第一StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
来自主题: AI资讯
9286 点击 2026-10-06 14:39

 搜索
StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
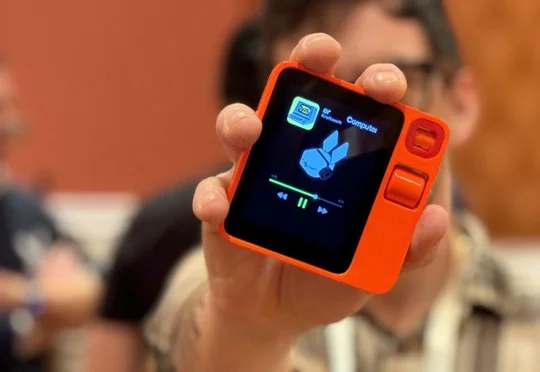
Rabbit创始人吕骋表示,人不该为Agent改变思考方式,OS3以持续对话、最多连接五台电脑并支持自带模型密钥和本地执行来降低门槛,但个人Agent的长期需求仍待验证。
在Anthropic冲刺IPO之际,Meta将Claude Code活跃用户从6万降至3万并转向Muse Code,微软也将内部Claude支出削减逾33%,单员工月度Token预算从10万美元降至1万美元。
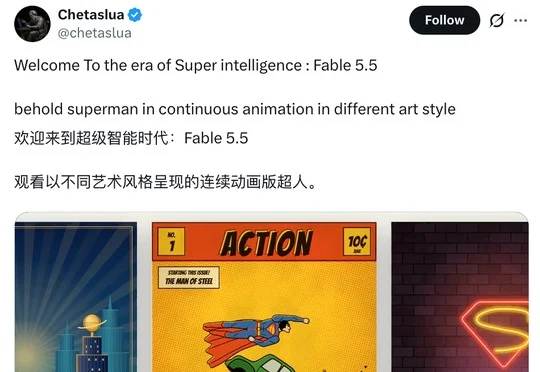
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
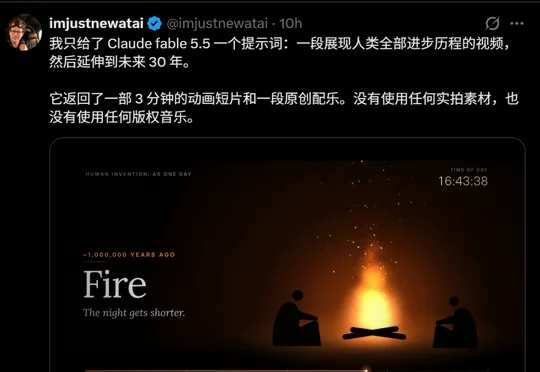
今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。
哈佛物理学家Matthew Schwartz用Claude和开源工具BootLoops处理可验证的科研任务,90天产出横跨18个学科的36篇论文初稿,并主张由人挑题、追问和验收,让AI发挥辅助而非替代科学家的作用。
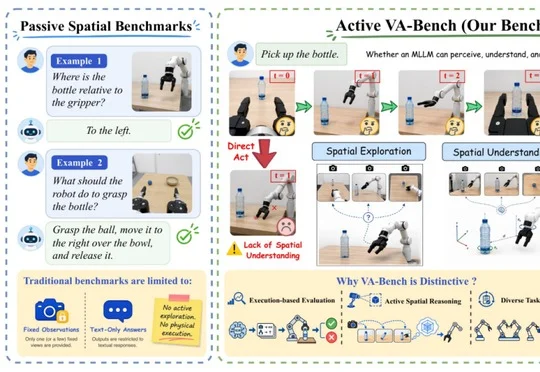
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
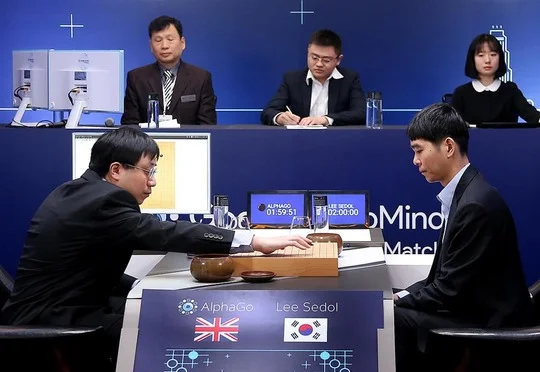
2016 年 3 月,首尔四季酒店。人机大战第二局进行到中途,AlphaGo 把一颗黑子落在了第五线上。现场解说一时语塞,有人怀疑程序出了 bug,因为在职业棋手的常识里,这手棋近乎于白送。
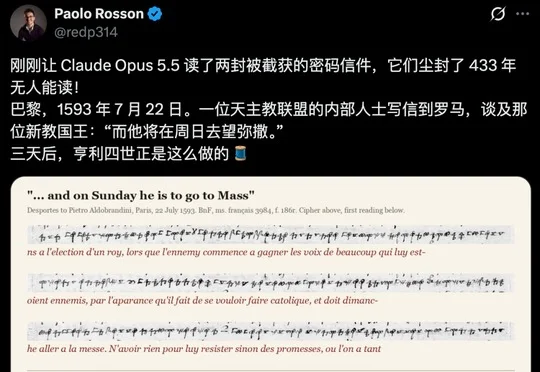
GPT-6 Astra与Claude Opus 5.5独立破译了1593年天主教联盟的两封密信,揭示法兰西国王亨利四世改宗天主教背后高达50万埃居的政治交易,并牵出教皇、西班牙王室与法国天主教联盟之间的权力背叛。
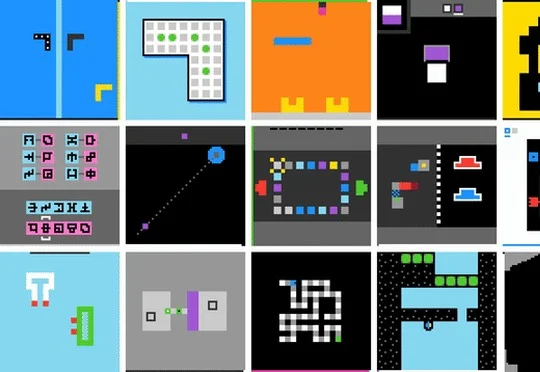
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。