在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
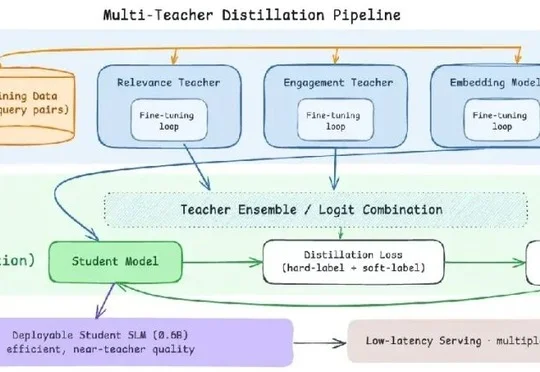
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
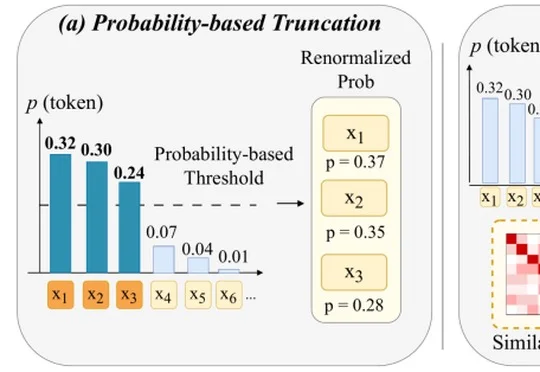
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
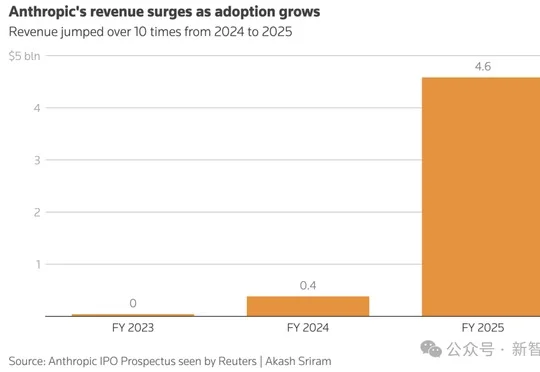
Anthropic招股书披露,其背负未来5180亿美元算力与基建长期支出承诺,2025年营收近46亿美元却净亏约420亿美元,公司正冲击或超2万亿美元的IPO估值,但客户集中度高且订单缺乏长期合同保障,能否撑住天价估值取决于收入增长能否持续跑赢算力成本。
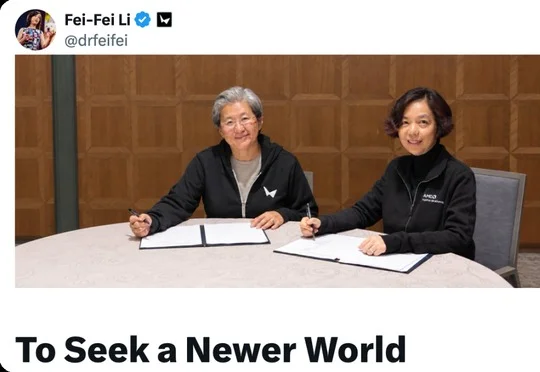
AMD 宣布以约 82 亿美元(折合人民币约 550 亿元)全股票方式收购李飞飞创立的 World Labs,交易完成后李飞飞将出任 AMD 执行副总裁兼首席科学家,双方将围绕空间智能模型研究与算力生态展开深度合作。
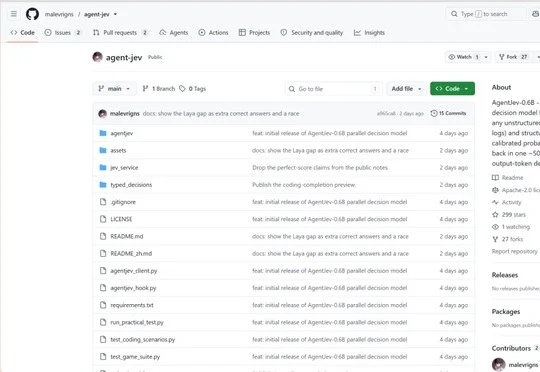
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
可灵AI发布时隔8个月大版本更新的旗舰视频生成模型Kling 4.0及轻量版Kling 4.0 Flash,单次原生生成时长提升至30秒,最多支持10个关键帧输入,新增双通道立体声输出,并将很快推出4K 10-bit HDR格式。
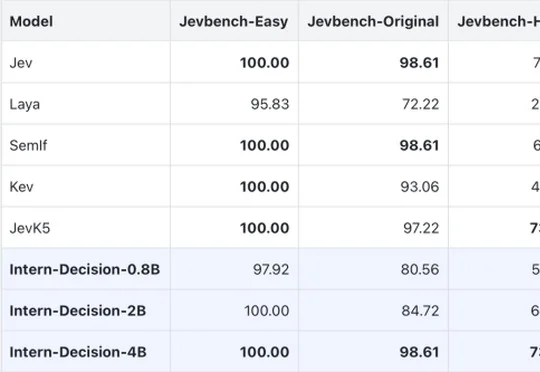
上海人工智能实验室开源的多模态决策SOTA模型Intern-Decision采用自回归式掩码语言任务框架,在推理速度上比Jev提升2至3倍,并在游戏画面决策、验证码识别和网页操作等任务中展现出将视觉理解与结构化决策结合的能力,目前已在Hugging Face、GitHub开源0.8B、2B和4B三个版本。
奥比中光向香港联交所提交上市申请,拟发行H股并在港交所主板上市,蚂蚁集团旗下上海云鑫持股8.92%,2025年营收9.41亿元、净利润1.28亿元,全球机器人3D视觉感知市场份额以29.0%排名第一。
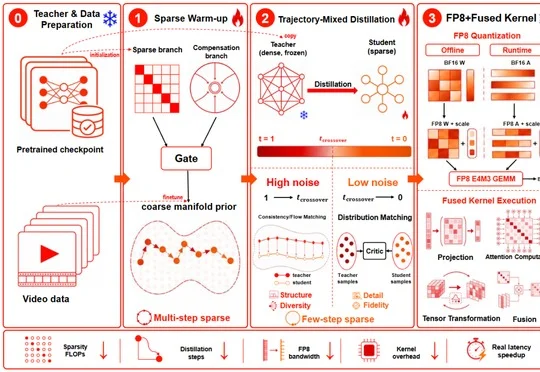
北京大学、清华大学与阿里巴巴等机构联合提出SparkDiffusion视频生成加速系统,通过融合稀疏注意力、少步蒸馏与FP8量化,在单卡RTX 5090上实现最高720倍推理加速,可在18秒内生成5秒720P视频,并已完整开源权重与训练代码。
在2026骁龙峰会上,高通CEO安蒙发布第六代骁龙8至尊版双旗舰平台并强调行业正迈向意图驱动的智能体AI时代,联合中国企业在手机端侧部署300亿参数MoE模型,同时指出高通已拓展至PC、汽车、机器人和数据中心等业务,肯定中国企业的智能体创新速度。