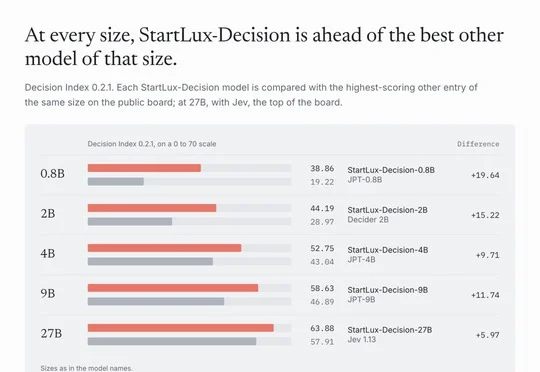
Jev被请下王座,StartLux中国开源决策模型冲上第一
Jev被请下王座,StartLux中国开源决策模型冲上第一StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
来自主题: AI资讯
8768 点击 2026-10-06 14:39

 搜索
StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
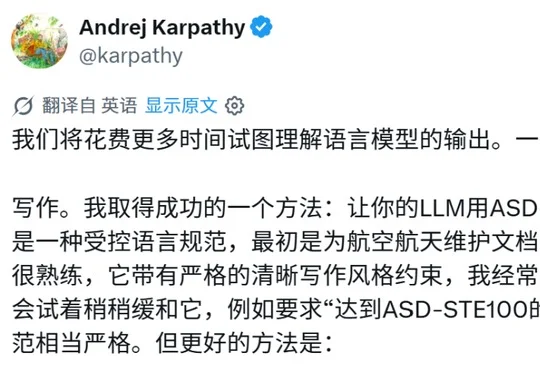
Karpathy建议让LLM采用约80%的ASD-STE100规范,并生成图示、HTML交互页面或定制讲解视频,将输出转化为更清晰易懂的软件产物。
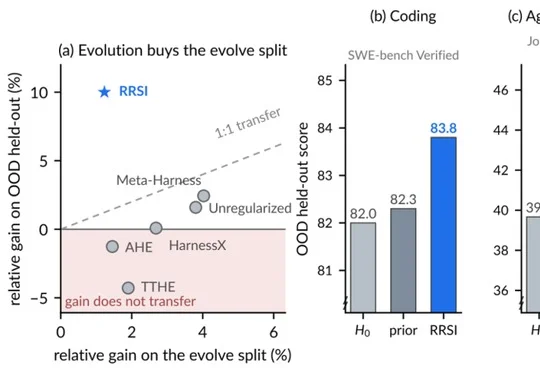
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
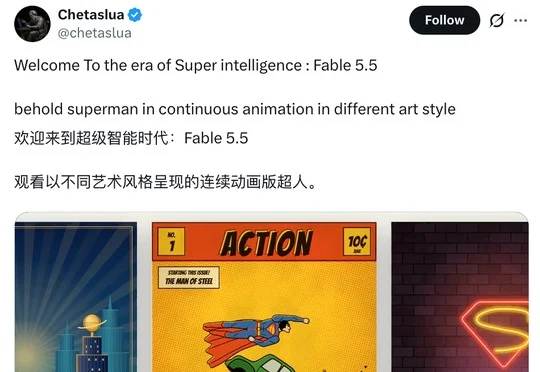
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
Anthropic 为 Claude Code 默认开放可深度改装的 Mods,并推出拥有超 2000 个插件和连接器的 Claude Marketplace,但高权限与暂缺收益分成也带来安全和持续运营疑问。
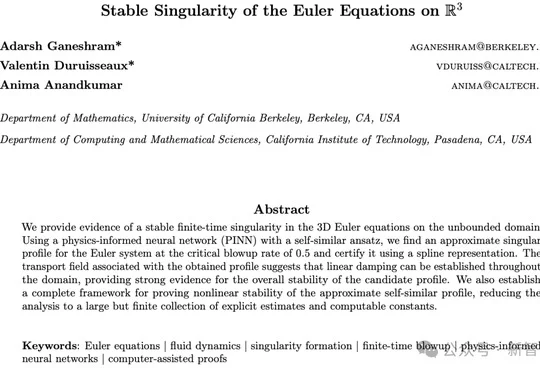
Caltech的Anima Anandkumar团队利用物理信息神经网络(PINN)和自研优化器,在三维无强迫欧拉方程自由空间中求得奇点候选解,缩放指数收敛至约0.5,但最终证明仍待完成。
哈佛物理学家Matthew Schwartz用Claude和开源工具BootLoops处理可验证的科研任务,90天产出横跨18个学科的36篇论文初稿,并主张由人挑题、追问和验收,让AI发挥辅助而非替代科学家的作用。
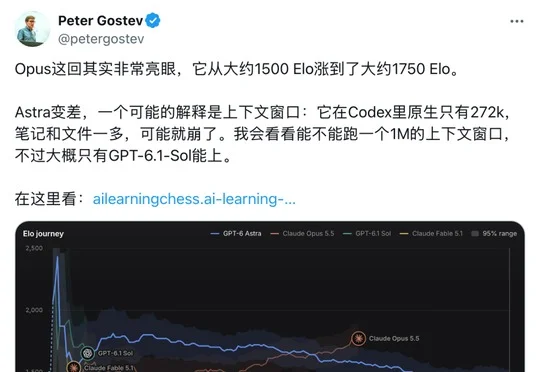
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
Harvey联合创始人Gabe Pereyra表示,AI应用公司不必与大模型公司比拼资金和算力,可借助真实任务评测、领域专家、开源模型和外部研究团队建立持续学习能力。
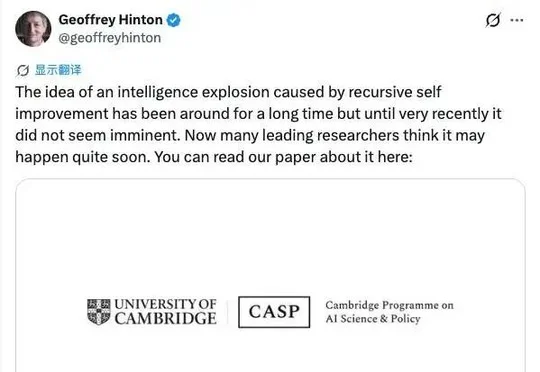
Geoffrey Hinton联合Yoshua Bengio、OpenAI首席科学家Jakub Pachocki、Anthropic联合创始人Jack Clark等20多位AI研究者发布剑桥CASP报告,指出AI已深度参与自身研发,Anthropic内部AI生成代码占比已超80%,警告递归自我改进可能引发技术进步突然加速的「智能爆炸」。