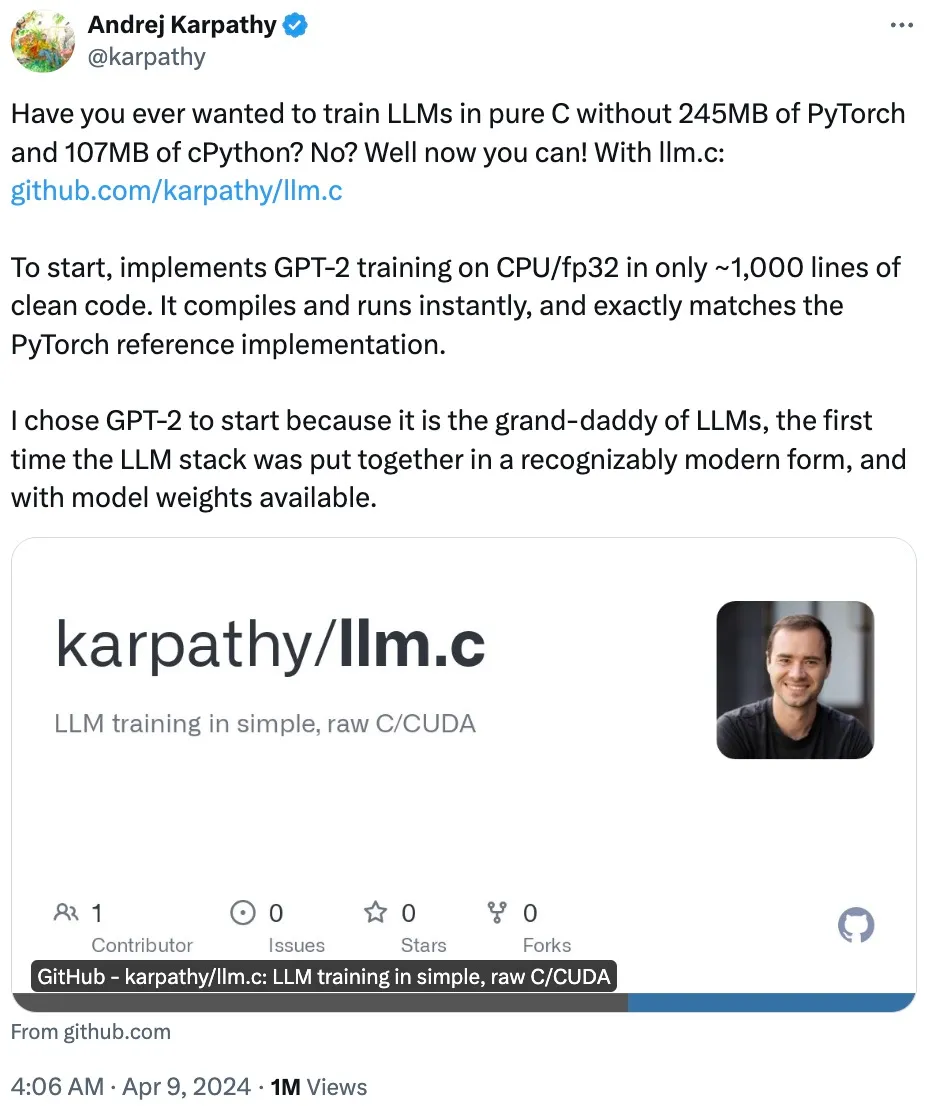
为什么要纯C语言手搓GPT-2,Karpathy回应网友质疑
为什么要纯C语言手搓GPT-2,Karpathy回应网友质疑一个仅用 1000 行代码即可在 CPU/fp32 上实现 GPT-2 训练的项目「llm.c」
来自主题: AI资讯
8036 点击 2024-04-11 20:53

 搜索
一个仅用 1000 行代码即可在 CPU/fp32 上实现 GPT-2 训练的项目「llm.c」
昨天的谷歌Next大会可是太精彩了,谷歌一连放出不少炸弹。 - 升级「视频版」Imagen 2.0,下场AI视频模型大混战 - 发布时被Sora光环掩盖的Gemini 1.5 Pro,正式开放 - 首款Arm架构CPU发布,全面对垒微软/亚马逊/英伟达/英特尔
近日,天才程序员Justine Tunney发推表示自己更新了Llamafile的代码,通过手搓84个新的矩阵乘法内核,将Llama的推理速度提高了500%!
是时候让CPU在AI应用上 “支棱”起来了。
大模型的训练阶段我们选择GPU,但到了推理阶段,我们果断把CPU加到了菜单上。

AIGC的这把火,燃起来的可不只是百模大战的热度和雨后春笋般的各式AI应用。更是由于算力与通信需求的爆发式增长,使得底层的专用加速芯片、以及配备这些芯片的AI加速服务器再次被拉到了大众的聚光灯下。

“Claude 3、Gemini 1.5,是要把RAG(检索增强生成)给搞死了吗?”
众所周知,如今“AI PC”可以说是消费电子行业最为热门的话题之一。对于一些不太了解技术细节,但却对这个概念心向往之的消费者而言,他们相信“AI PC”可以更智能地帮助自己完成一些不熟练的操作,或是减轻日常工作的负担。
2024年第一个四分之一还没过完,PC市场的最热关键词,已是非「AI」莫属。
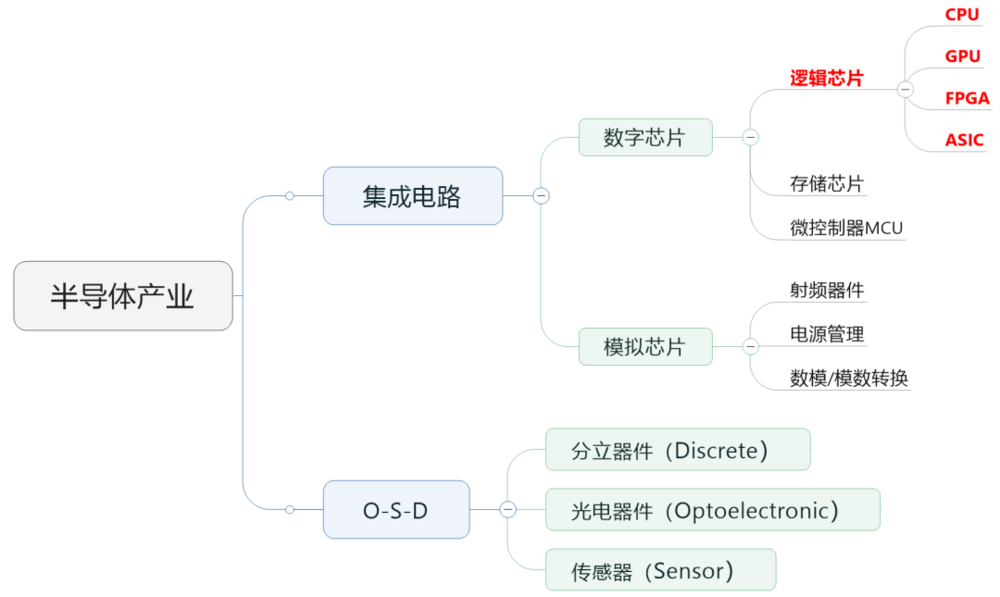
本文介绍了为什么在AI计算中要使用GPU,以及GPU与CPU的区别和作用。GPU具备强悍的并行计算能力,适合处理大量高强度并行计算任务,包括深度学习算法。