142页重磅,DeepSeek-R1的"甜蜜点",开创了一个崭新的研究领域“思维学”。 | 最新
142页重磅,DeepSeek-R1的"甜蜜点",开创了一个崭新的研究领域“思维学”。 | 最新这是一份142页的研究论文,本文深入解析了大型推理模型DeepSeek-R1如何通过"思考"解决问题。研究揭示了模型思维的结构化过程,以及每个问题都存在甜蜜点"最佳推理区间"的惊人发现。这标志着"思维学"这一新兴领域的诞生,为我们理解和优化AI推理能力提供了宝贵框架。
搜索
这是一份142页的研究论文,本文深入解析了大型推理模型DeepSeek-R1如何通过"思考"解决问题。研究揭示了模型思维的结构化过程,以及每个问题都存在甜蜜点"最佳推理区间"的惊人发现。这标志着"思维学"这一新兴领域的诞生,为我们理解和优化AI推理能力提供了宝贵框架。
GPT - 4o、Deepseek - R1 等高级模型已展现出令人惊叹的「深度思考」能力:理解上下文关联、拆解多步骤问题、甚至通过思维链(Chain - of - Thought)进行自我验证、自我反思等推理过程。
继接入 DeepSeek 后,APPSO 发现名为「元宝」的 AI 助手目前已经正式入驻微信。现在,你可以在微信框搜索「元宝」,亦或者直接扫描二维码图片,将其添加到通讯录,即可与它展开对话。
2024 年,是学习平板这个品类集中爆发的一年。
近年来,大模型(Large Language Models, LLMs)在数学、编程等复杂任务上取得突破,OpenAI-o1、DeepSeek-R1 等推理大模型(Reasoning Large Language Models,RLLMs)表现尤为亮眼。但它们为何如此强大呢?
大家好,我是袋鼠帝上个月底,智谱发布了一个非常牛逼的产品AutoGLM沉思版(国内首个免费使用的DeepResearch),它既能推理,又能动手,还能接管你的浏览器帮你干活儿。
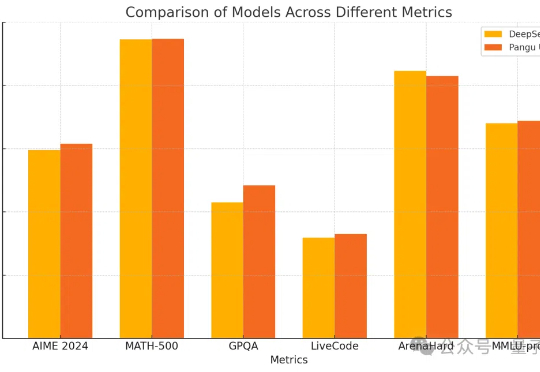
密集模型的推理能力也能和DeepSeek-R1掰手腕了?
诺奖得主Demis Hassabis表示,通过AI,DeepMind团队在一年里,完成了10亿年的博士研究时间!10亿年的科学探索被压缩到了一年之内,或许这才代表了AI技术的最高使命。
书接上回,用几块3000元显卡作为加速主力的一体机,就能跑通671B的DeepSeek。
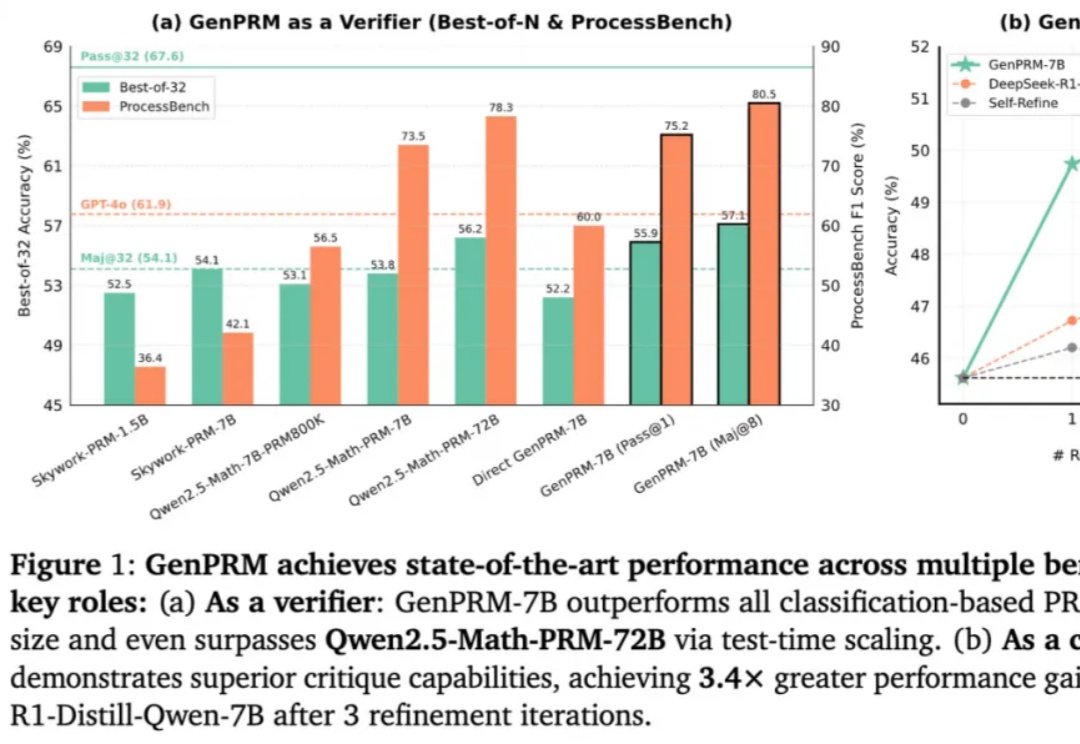
随着 OpenAI o1 和 DeepSeek R1 的爆火,大语言模型(LLM)的推理能力增强和测试时扩展(TTS)受到广泛关注。然而,在复杂推理问题中,如何精准评估模型每一步回答的质量,仍然是一个亟待解决的难题。传统的过程奖励模型(PRM)虽能验证推理步骤,但受限于标量评分机制,难以捕捉深层逻辑错误,且其判别式建模方式限制了测试时的拓展能力。