在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
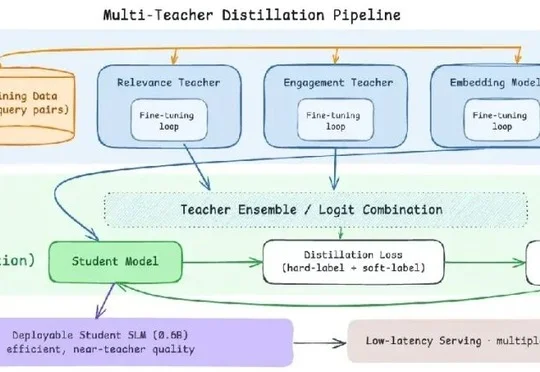
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
思特雅大学曾仔健搭建的AI Has Taste项目公开453份数学研究手稿和6篇AI-Proposed Conjectures,其中AI曾构造反例推翻论文猜想并获原作者确认,该系统通过多Agent协作将失败转化为新一轮研究输入,推动AI从生成答案走向生成研究议程。
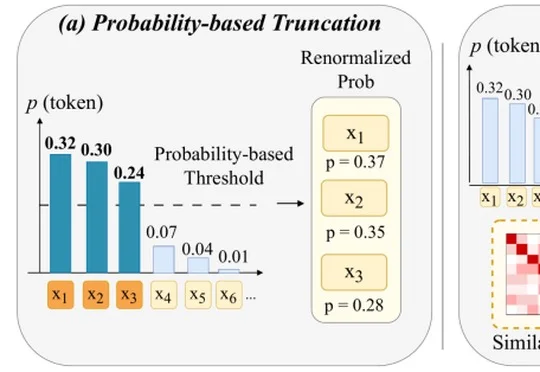
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
360图龙锋发现OpenAI Codex的curated Git插件同步链路存在0day漏洞,可绕过沙箱审批机制在用户授权前静默执行恶意操作,威胁全球2500万用户的开发凭证与代码仓库安全。
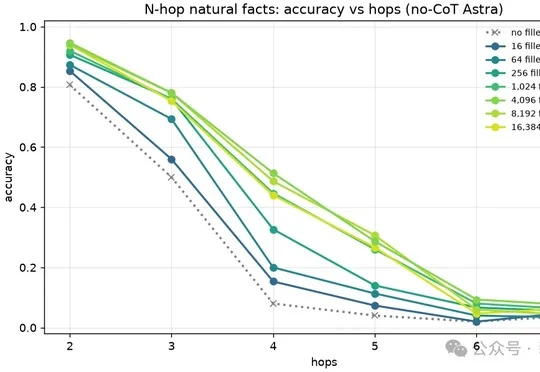
Redwood Research发现GPT-6 Astra能将题目后的空白Token当作思考空间,在四跳推理测试中准确率从约10%升至50%、旧AIME题从约60%升至约90%,这一现象引发对AI思维链监控有效性的担忧。
Meta旗下个人智能体Muse上线12天下载量跑赢ChatGPT后被曝核心灵魂文件SOUL.md及工作区组织方式与开源项目OpenClaw高度雷同,Meta超级智能实验室产品负责人Nat Friedman承认Muse在产品设计上深受OpenClaw启发,目标是将其打造为安全易用、可扩展至数十亿人的版本。
诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
9月18日,亚马逊云科技官宣,旗下大模型服务平台Bedrock正式托管Kimi K3。国产模型上线海外云平台并非新鲜事。但是作为开源模型,开始让美国云厂商愿意"交钱" ,Kimi确实是独一份。
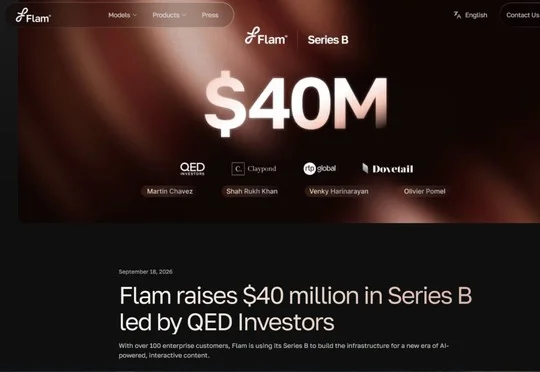
AI互动内容公司Flam完成4000万美元B轮融资,由QED Investors领投、宝莱坞巨星沙鲁克·汗跟投,Google已为其企业客户,资金将用于AI模型研发、产品矩阵扩展及海外销售团队建设。
最近看到了一个挺有意思的东西,就是TypeSafe AI 做的 Jev。Reddit 上很多人用它玩 DOOM,也有人拿它玩 Mario。我申请之后,拿到 API Key 后,也做了一个网页小游戏,想看看它到底在里面起什么作用。一开始,我最想弄清楚的其实很简单:同样是让 AI 操作游戏,为什么要用 Jev?GPT 不能做吗?当然能。