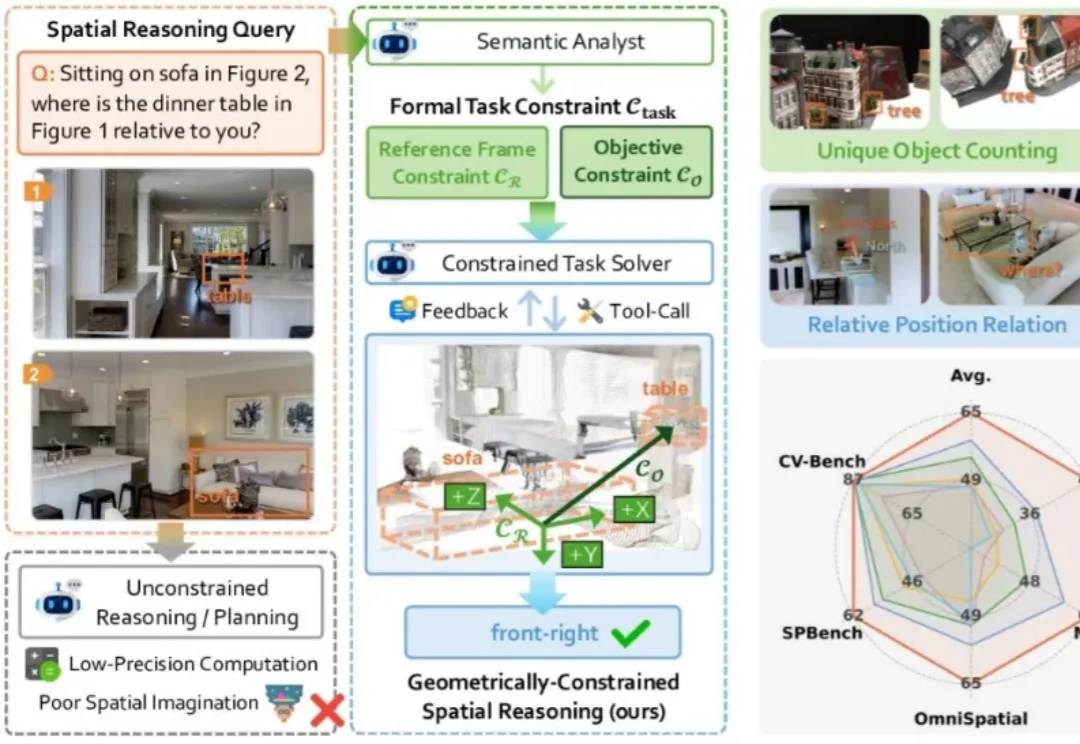
引入几何约束后,VLM跨越了「空间推理」的认知鸿沟
引入几何约束后,VLM跨越了「空间推理」的认知鸿沟现有的视觉大模型普遍存在「语义-几何鸿沟」(Semantic-to-Geometric Gap),不仅分不清东南西北,更难以处理精确的空间量化任务。例如问「你坐在沙发上时,餐桌在你的哪一侧?」,VLM 常常答错。
来自主题: AI技术研报
7688 点击 2026-01-13 10:20

 搜索
现有的视觉大模型普遍存在「语义-几何鸿沟」(Semantic-to-Geometric Gap),不仅分不清东南西北,更难以处理精确的空间量化任务。例如问「你坐在沙发上时,餐桌在你的哪一侧?」,VLM 常常答错。

今天聊一聊怎么在RAG、agent场景中实现语义高亮(Semantic Highlight)。
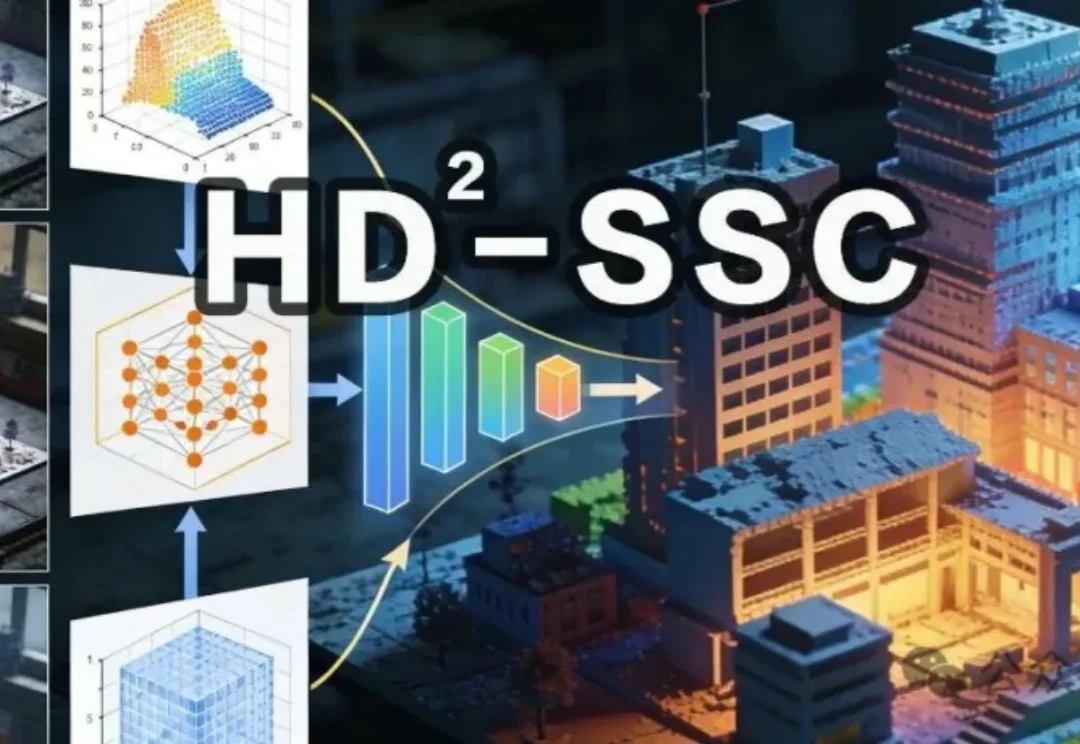
北京大学团队提出了一种新的视觉语义场景补全方法HD²-SSC,用于从多视角图像重建三维语义场景。该方法通过高维度语义解耦和高密度占用优化,解决了现有技术中二维输入与三维输出之间的维度差异,以及人工标注与真实场景密度差异的问题,从而实现更准确的语义场景补全。
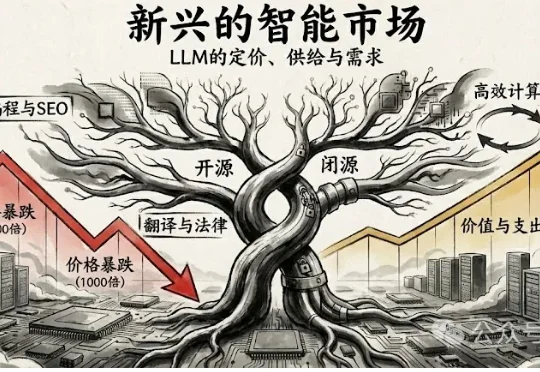
2025年12月12日,波士顿大学的 Andrey Fradkin 团队发布了一项令业界瞩目的研究 《The Emerging Market for Intelligence: Pricing, Supply, and Demand for LLMs》(智能的新兴市场:LLM的定价、供给与需求)。

在具身智能与视频理解飞速发展的今天,如何让 AI 真正 “看懂” 复杂的操作步骤?北京航空航天大学陆峰教授团队联合东京大学,提出视频理解新框架。该工作引入了 “状态(State)” 作为视觉锚点,解决了抽象文本指令与具象视频之间的对齐难题,已被人工智能顶级会议 AAAI 2026 接收。
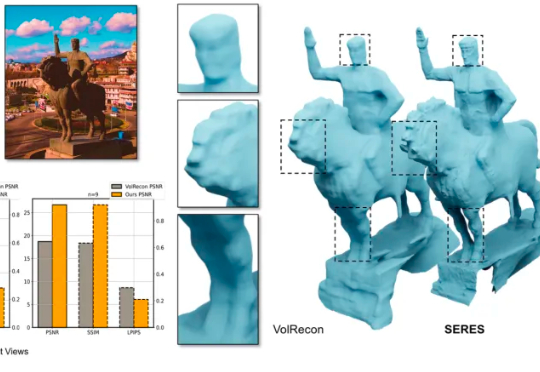
直观经验却告诉我们,只要把同一物体的 “对应部分” 对齐,形状就会变得清晰。基于这一朴素而有效的直觉,作者提出SERES(Semantic-Aware Reconstruction from Sparse Views),在不改动主干框架的前提下,把跨视角的语义一致性变成一种训练期先验注入到模型里,用低成本的方法去解决高价值的歧义问题,让少量视角也能得到清晰而完整的几何。
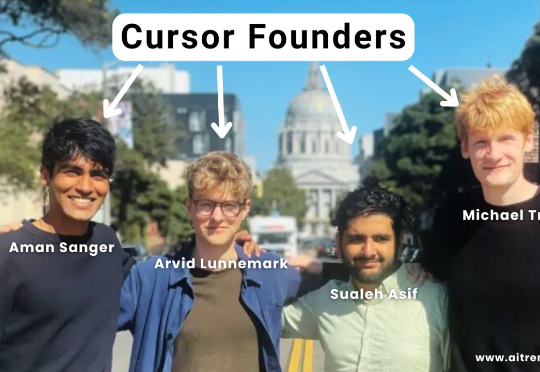
美国当地时间 10 月 29 日,据外媒消息,AI 编码工具 Cursor 背后的公司 Anysphere 的联合创始人 Arvid Lunnemark 已离职。Cursor 最初由四位联合创始人创立,除了 Lunnemark 之外,还有 Aman Sanger、Michael Truell 和 Sualeh Asif。
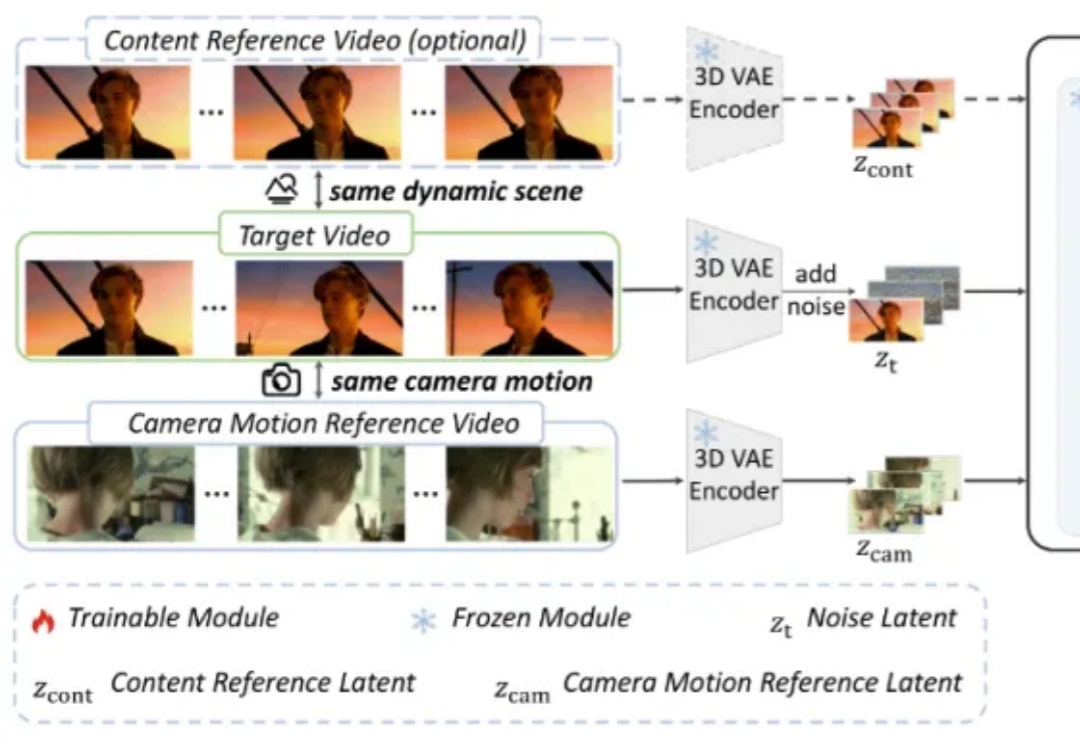
作为视频创作者,你是否曾梦想复刻《盗梦空间》里颠覆物理的旋转镜头,或是重现《泰坦尼克号》船头经典的追踪运镜?
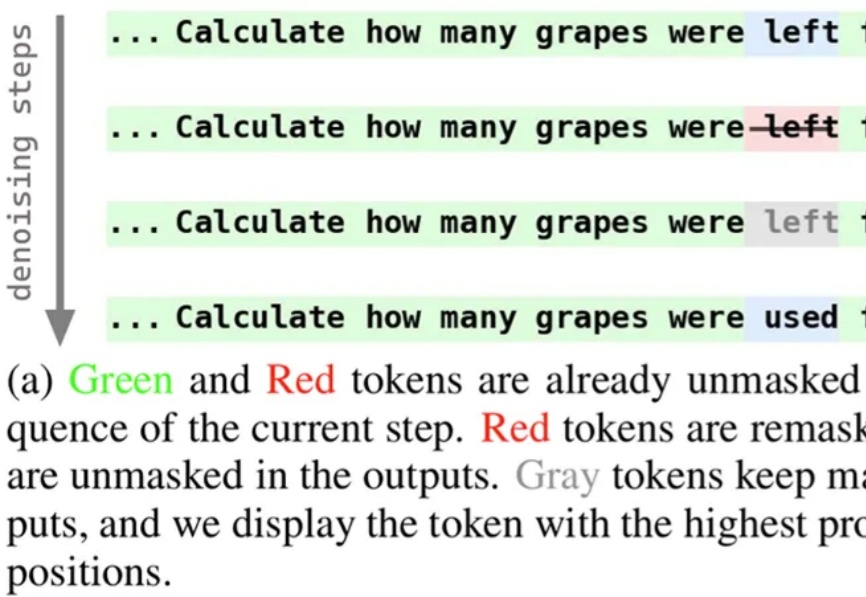
近期,扩散语言模型备受瞩目,提供了一种不同于自回归模型的文本生成解决方案。为使模型能够在生成过程中持续修正与优化中间结果,西湖大学 MAPLE 实验室齐国君教授团队成功训练了具有「再掩码」能力的扩散语言模型(Remasking-enabled Diffusion Language Model, RemeDi 9B)。
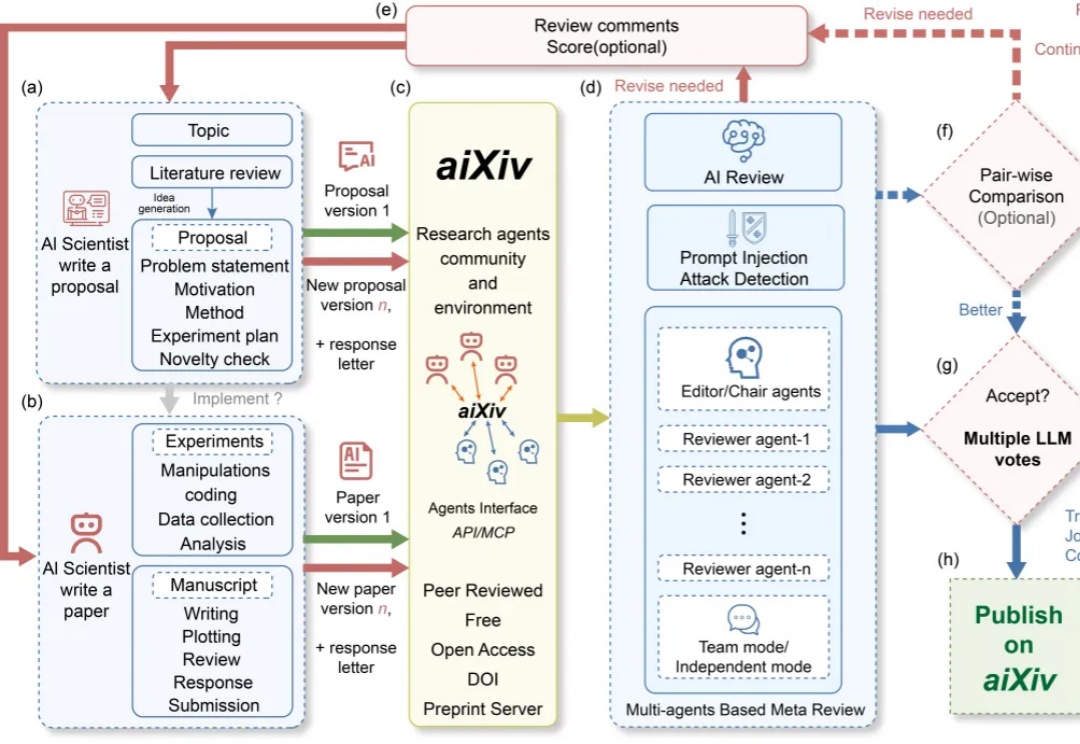
在讨论 AGI 或者通用机器人定义时,人们往往会自然联想到一些直观的衡量标准,比如 AI 能否解出高考题、在国际数学奥林匹克(IMO,International Mathematical Olympiad)上获得金牌,或者机器人能否胜任家务。