最前线|「无问芯穹」发布千卡规模异构芯片混训平台,筑基面向MxN生态格局的AI Native基础设施
最前线|「无问芯穹」发布千卡规模异构芯片混训平台,筑基面向MxN生态格局的AI Native基础设施「无问芯穹」Infini-AI云平台已集成大模型异构千卡混训能力,是全球首个可进行单任务千卡规模异构芯片混合训练的平台。
来自主题: AI资讯
11492 点击 2024-07-05 14:27

 搜索
「无问芯穹」Infini-AI云平台已集成大模型异构千卡混训能力,是全球首个可进行单任务千卡规模异构芯片混合训练的平台。
开源大语言模型(LLM)百花齐放,为了让它们适应各种下游任务,微调(fine-tuning)是最广泛采用的基本方法。基于自动微分技术(auto-differentiation)的一阶优化器(SGD、Adam 等)虽然在模型微调中占据主流,然而在模型越来越大的今天,却带来越来越大的显存压力。
「微调你的模型,获得比GPT-4更好的性能」不只是说说而已,而是真的可操作。最近,一位愿意动手的ML工程师就把几个开源LLM调教成了自己想要的样子。
刚刚AI搜索又出新产品了,这次是前百度高管离职后创业融资6千万美元,推出的首个AI产品——Genspark。
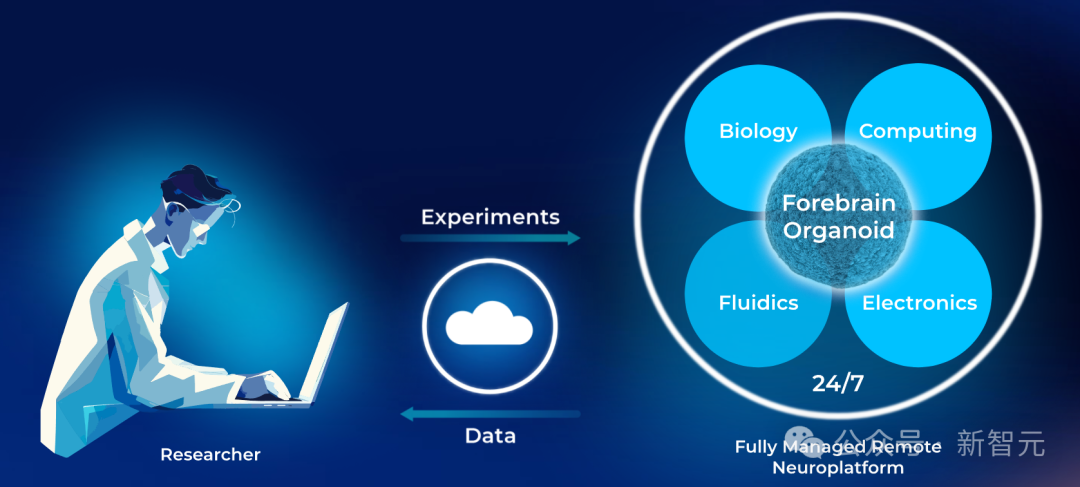
瑞士领先的生物计算初创公司FinalSpark推出了首个在线平台Neuroplatform,使全球研究人员能够全天候访问16个人脑类器官,FinalSpark旨在开发世界上第一个生物处理器。这种生物处理器功耗比传统数字处理器低一百万倍,有可能减少计算机过度使用造成的环境影响。
大语言模型(LLM)的迅速发展,引发了关于如何评估其公平性和可靠性的热议。
从大规模网络爬取、精细过滤到去重技术,通过FineWeb的技术报告探索如何打造高质量数据集,为大型语言模型(LLM)预训练提供更优质的性能。
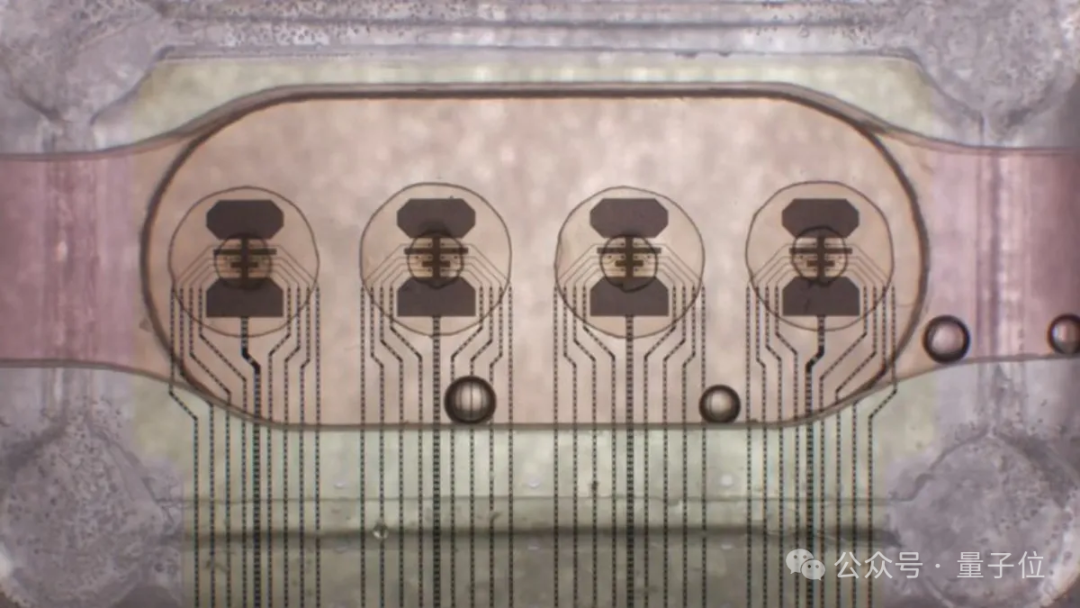
首个“脑PU”来了!由“16核”类人脑器官(human brain organoids)组成。
本文介绍了香港科技大学(广州)的一篇关于大模型高效微调(LLM PEFT Fine-tuning)的文章「Parameter-Efficient Fine-Tuning with Discrete Fourier Transform」
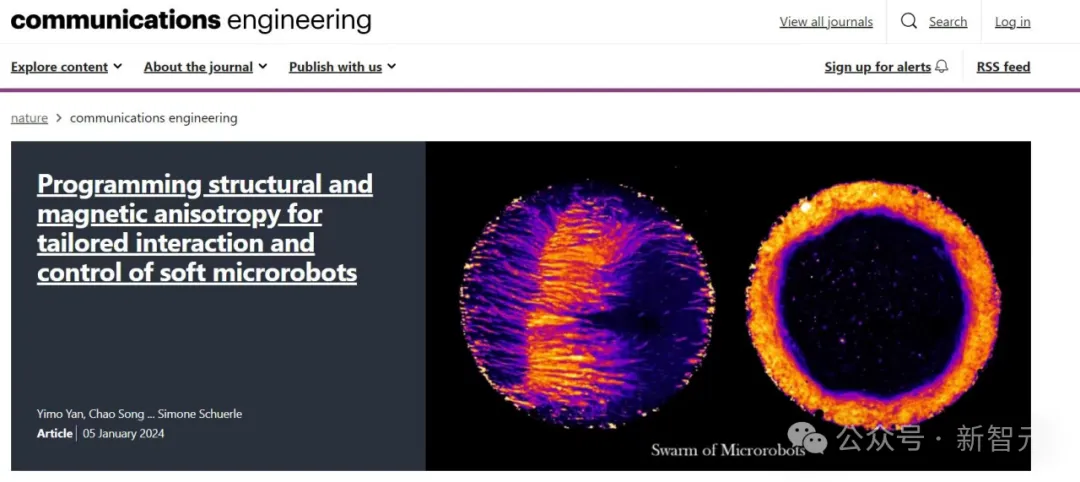
日前,北京大学智能学院可视计算与学习实验室陈宝权教授团队与苏黎世联邦理工学院健康科技系转化医学研究所Simone Schürle-Finke教授团队展开合作,首次使用物理模拟技术辅助可编程磁性微米级机器人的制造。