我的上下文资产,凭什么被大厂绑架?
我的上下文资产,凭什么被大厂绑架?开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
来自主题: AI资讯
9433 点击 2026-09-25 10:13

 搜索
开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
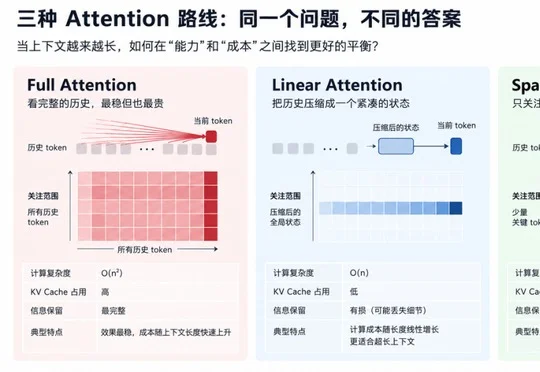
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
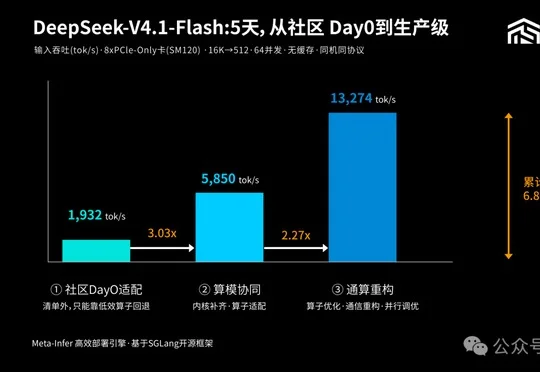
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
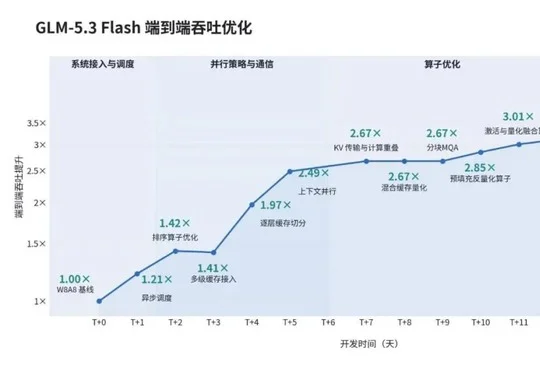
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
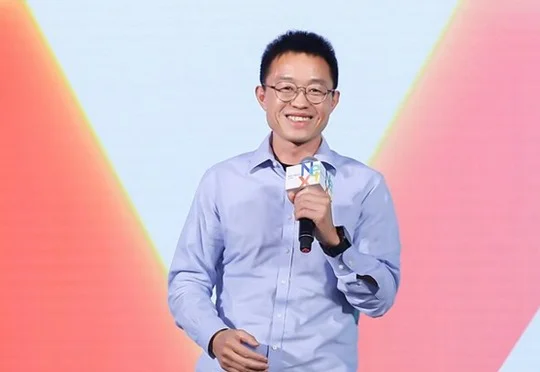
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
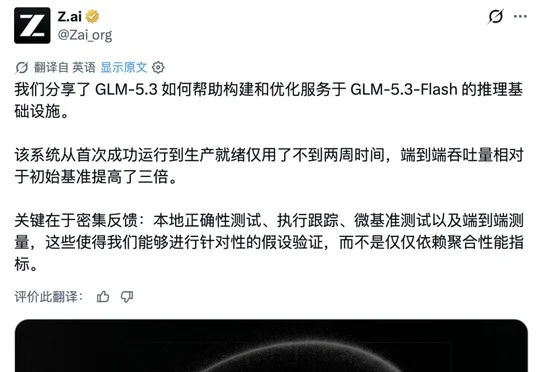
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
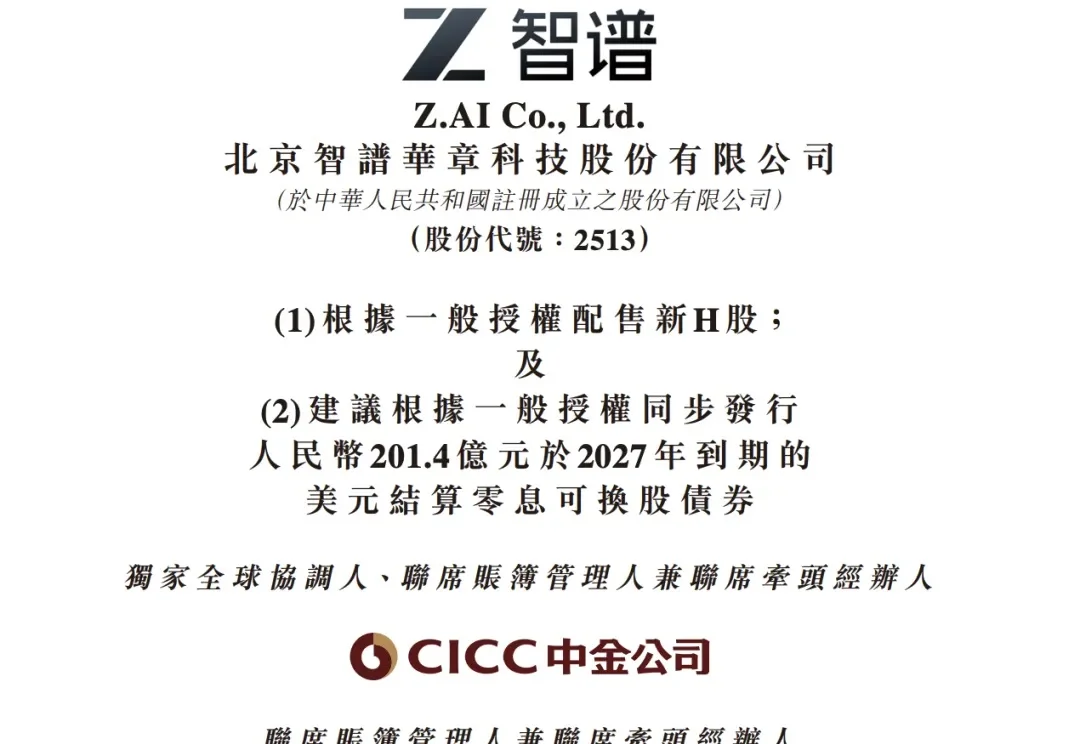
上市不到九个月,智谱一口气再融335亿元。
智谱宣布完成约50亿美元融资,募资净额约60%将用于下一代GLM基础模型及完全自训练体系(含递归式自我改进RSI)的研发,并支撑算力基础设施建设,同时约15%用于业务拓展与战略投资,约25%用于优化资本结构与补充营运资金。
创新工场汪华与Floatboat.ai创始人谭少卿对话指出,腾讯WorkBuddy、字节豆包工作、阿里千问办公等大厂AI办公会战已完成Agent市场教育,GLM-5.3-Flash和DeepSeek-V4-Flash等国产模型跨过能力门槛,巨头的壁垒仅剩资金,而中国创业者凭借贴近开源模型生态的优势,有望在垂直Agent领域找到更多机会。