超越DeepSeek推理,效率更高!斯坦福马腾宇新作:有限数据,无限迭代
超越DeepSeek推理,效率更高!斯坦福马腾宇新作:有限数据,无限迭代STP(自博弈定理证明器)让模型扮演「猜想者」和「证明者」,互相提供训练信号,在有限的数据下实现了无限自我改进,在Lean和Isabelle验证器上的表现显著优于现有方法,证明成功率翻倍,并在多个基准测试中达到最先进的性能。
来自主题: AI技术研报
5657 点击 2025-02-28 15:21

 搜索
STP(自博弈定理证明器)让模型扮演「猜想者」和「证明者」,互相提供训练信号,在有限的数据下实现了无限自我改进,在Lean和Isabelle验证器上的表现显著优于现有方法,证明成功率翻倍,并在多个基准测试中达到最先进的性能。
马斯克的 xAI 今天宣布正式完成了 60 亿美金的 C 轮融资,参与的投资人包括了 a16z、Blackrock、Fidelity、Kingdom Holdings、Lightspeed、MGX、Morgan Stanley、OIA、QIA、Sequoia Capital、Valor Equity Partners、Vy Capital、Nvidia、AMD 以及其它。
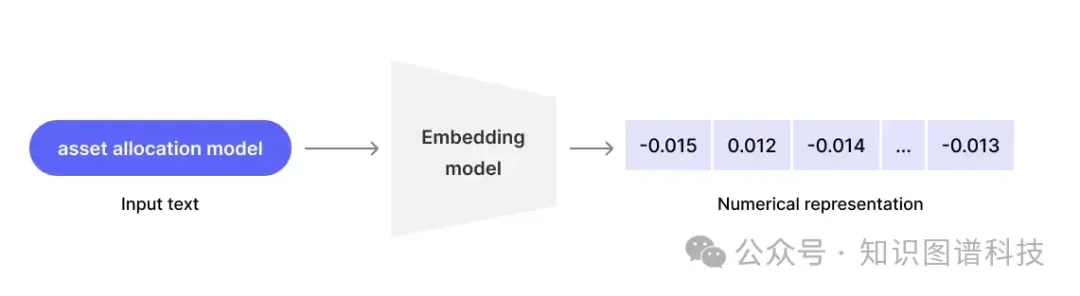
自从生成式 AI 和 LLM 在世界舞台上占据中心位置以来,员工们一直在思考如何最好地将这些变革性的新工具应用于他们的工作流程。然而,他们中的许多人在尝试将生成式 AI 集成到企业环境中时遇到了类似的问题,例如隐私泄露、缺乏相关性以及需要更好的个性化结果。
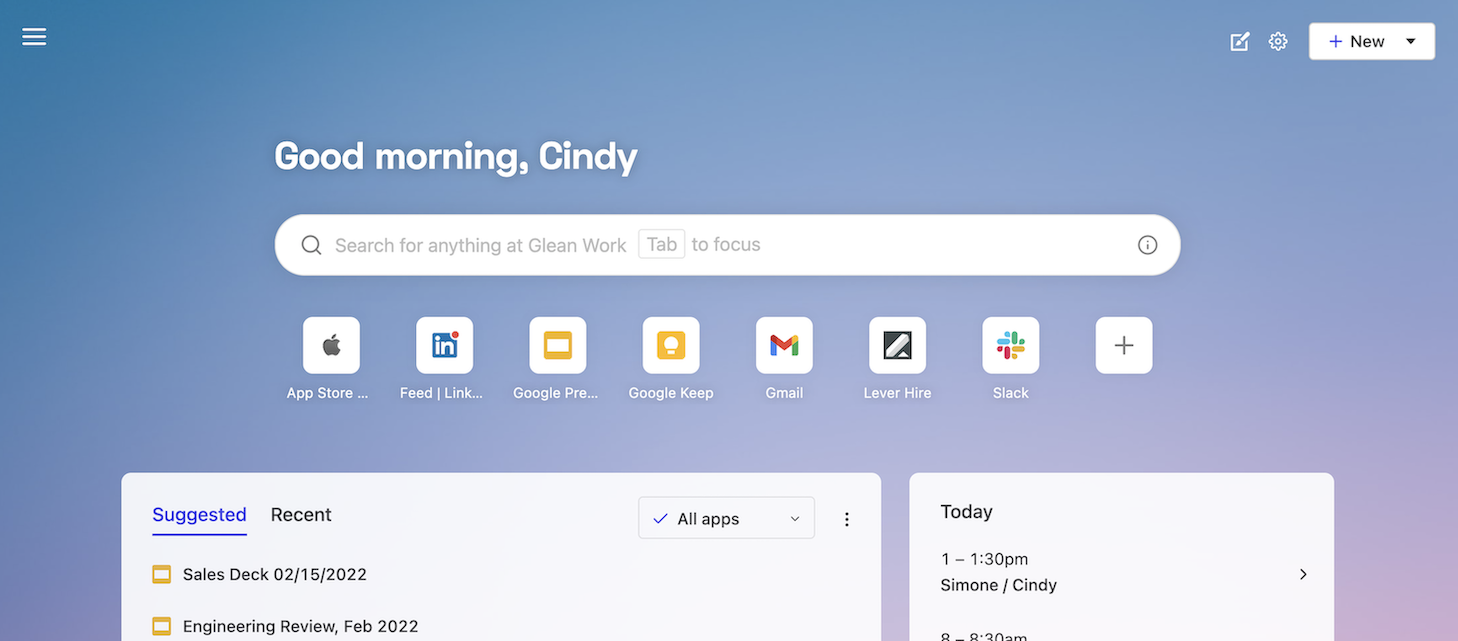
在 9 月份完成了 2.6 亿美元的 E 轮融资后,主打企业内部 AI 搜索的 Glean 估值达到 46 亿美元。
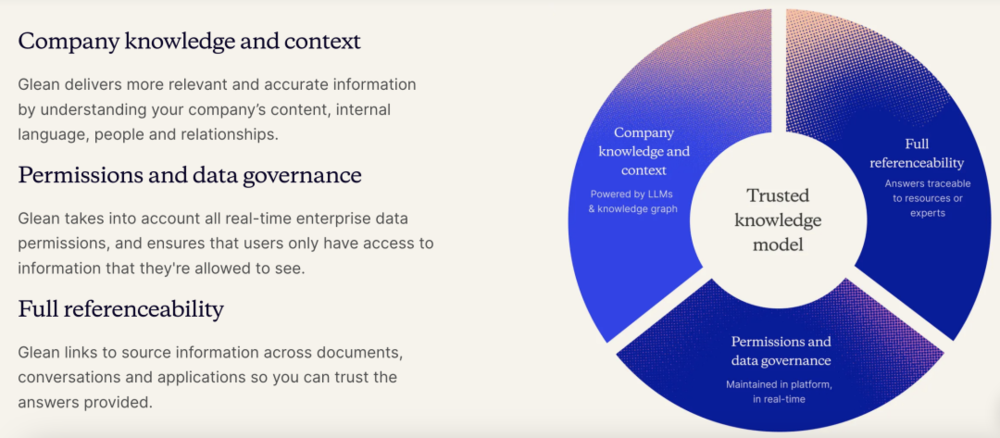
Glean可以把它想象成是企业内部的Google或ChatGPT,它是一个员工可以去提问的地方,而Glean会利用公司的知识来回答所有这些问题,无论这些知识存储在哪里,都会将其整合到一起。
诺贝尔物理学奖和化学奖被AI「包圆」后,人们再次确信:基础科学研究的范式,已经被AI从根本上改变。
在现代社会中,Wealthsimple、SUPER、webflow、duolingo、CONFLUENT、upside、CONTINO等多家企业都曾面临信息过载和知识孤岛的挑战。

Glean已召开2024年秋季“beyond the box”发布活动。
LLM数学水平不及小学生怎么办?CMU清华团队提出了Lean-STaR训练框架,在语言模型进行推理的每一步中都植入CoT,提升了模型的定理证明能力,成为miniF2F上的新SOTA。
大模型引发的AI大战持续了两年多之后,现在所有创业团队和投资人都在问的一个问题是——适用于大模型真正的场景有哪些?或者,更重要的是,到底怎么才能获得货真价实的客户和营收?