无需百卡集群!港科等开源LightGen: 极低成本文生图方案媲美SOTA模型
无需百卡集群!港科等开源LightGen: 极低成本文生图方案媲美SOTA模型文本到图像(Text-to-Image, T2I)生成任务近年来取得了飞速进展,其中以扩散模型(如 Stable Diffusion、DiT 等)和自回归(AR)模型为代表的方法取得了显著成果。然而,这些主流的生成模型通常依赖于超大规模的数据集和巨大的参数量,导致计算成本高昂、落地困难,难以高效地应用于实际生产环境。
搜索
文本到图像(Text-to-Image, T2I)生成任务近年来取得了飞速进展,其中以扩散模型(如 Stable Diffusion、DiT 等)和自回归(AR)模型为代表的方法取得了显著成果。然而,这些主流的生成模型通常依赖于超大规模的数据集和巨大的参数量,导致计算成本高昂、落地困难,难以高效地应用于实际生产环境。
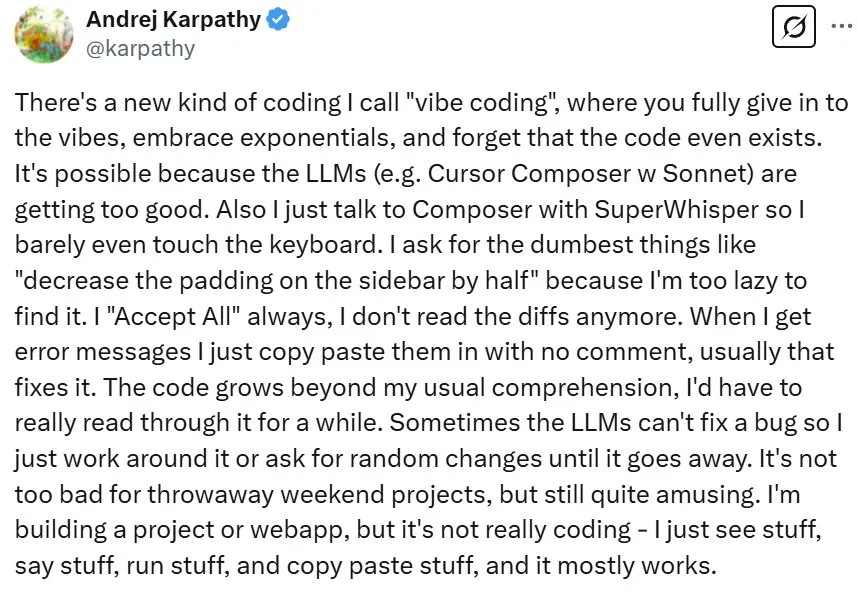
近段时间,著名 AI 科学家 Andrej Karpathy 提出的氛围编程(vibe coding)是 AI 领域的一大热门话题。简单来说,氛围编程就是鼓励开发者忘掉代码,进入开发的氛围之中。更简单地讲,就是向 LLM 提出需求,然后「全部接受」即可。
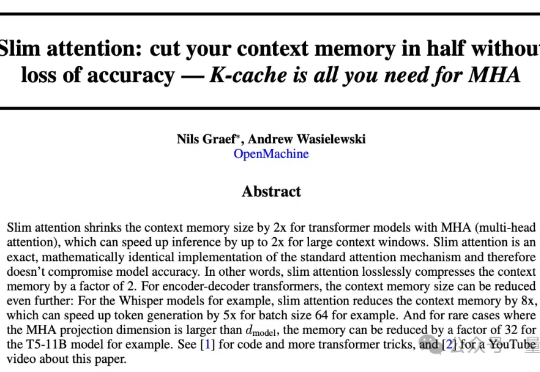
大模型同样的上下文窗口,只需一半内存就能实现,而且精度无损? 前苹果ASIC架构师Nils Graef,和一名UC伯克利在读本科生一起提出了新的注意力机制Slim Attention。
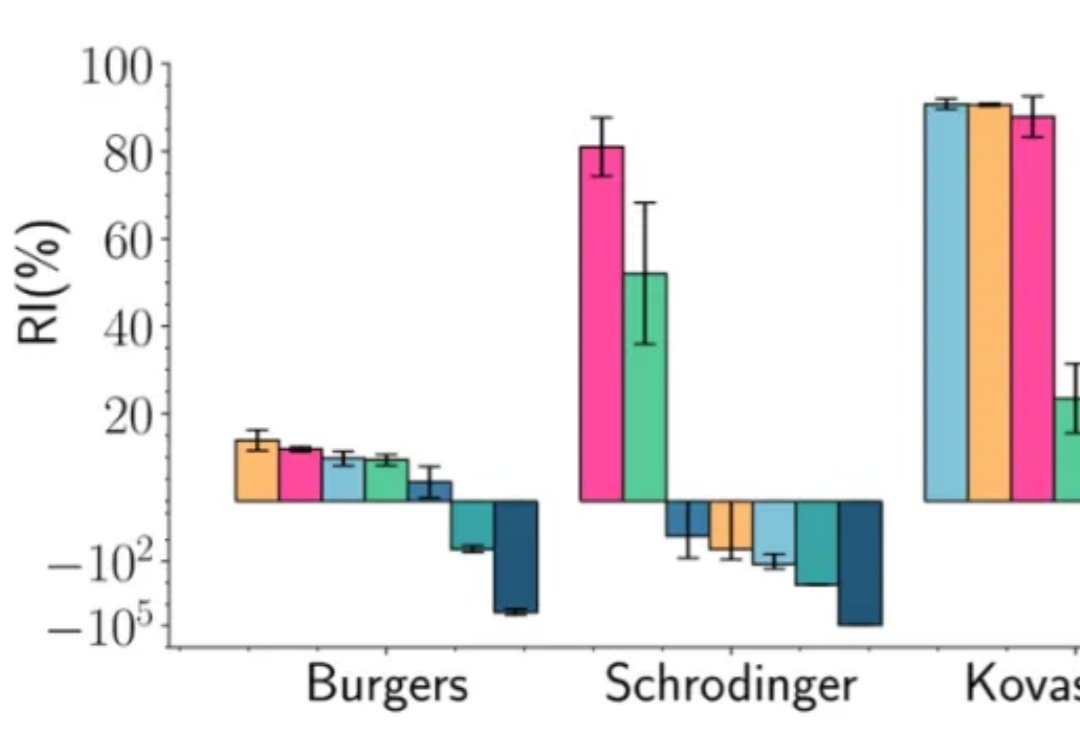
在深度学习的多个应用场景中,联合优化多个损失项是一个普遍的问题。典型的例子包括物理信息神经网络(Physics-Informed Neural Networks, PINNs)、多任务学习(Multi-Task Learning, MTL)和连续学习(Continual Learning, CL)。然而,不同损失项的梯度方向往往相互冲突,导致优化过程陷入局部最优甚至训练失败。
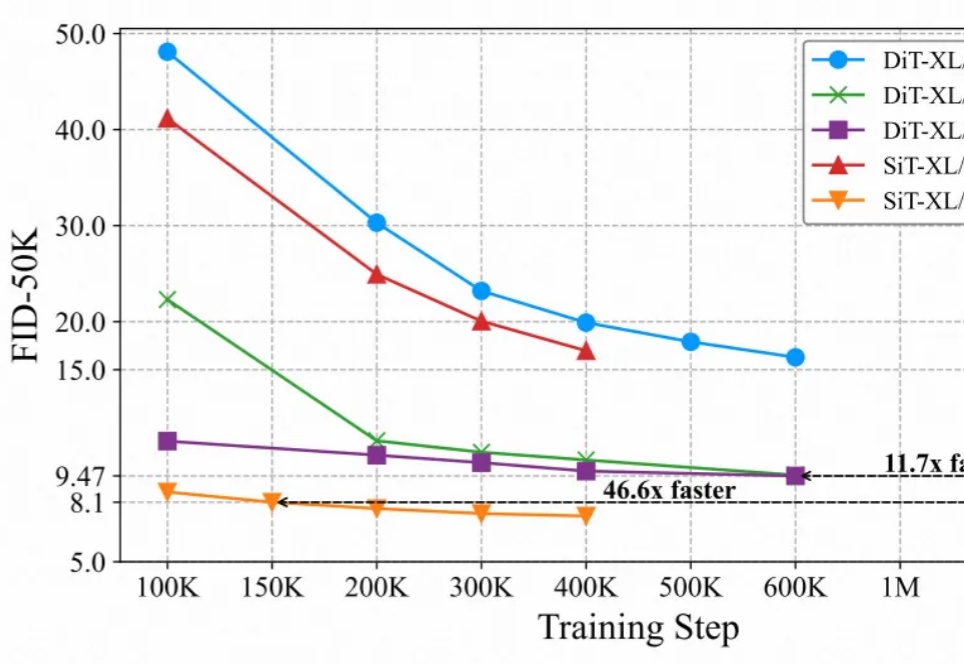
最近的研究强调了扩散模型与表征学习之间的相互作用。扩散模型的中间表征可用于下游视觉任务,同时视觉模型表征能够提升扩散模型的收敛速度和生成质量。然而,由于输入不匹配和 VAE 潜在空间的使用,将视觉模型的预训练权重迁移到扩散模型中仍然具有挑战性。
「压缩即智能」。这并不是一个新想法,著名 AI 研究科学家、OpenAI 与 SSI 联合创始人 Ilya Sutskever 就曾表达过类似的观点。
语音Agent市场在2024年下半年迎来爆发式增长。据Cartesia统计,在最新一届YC中,构建语音相关产品的公司占比达22%。
AI工业3D设计领域,还存在着无限的想象空间。
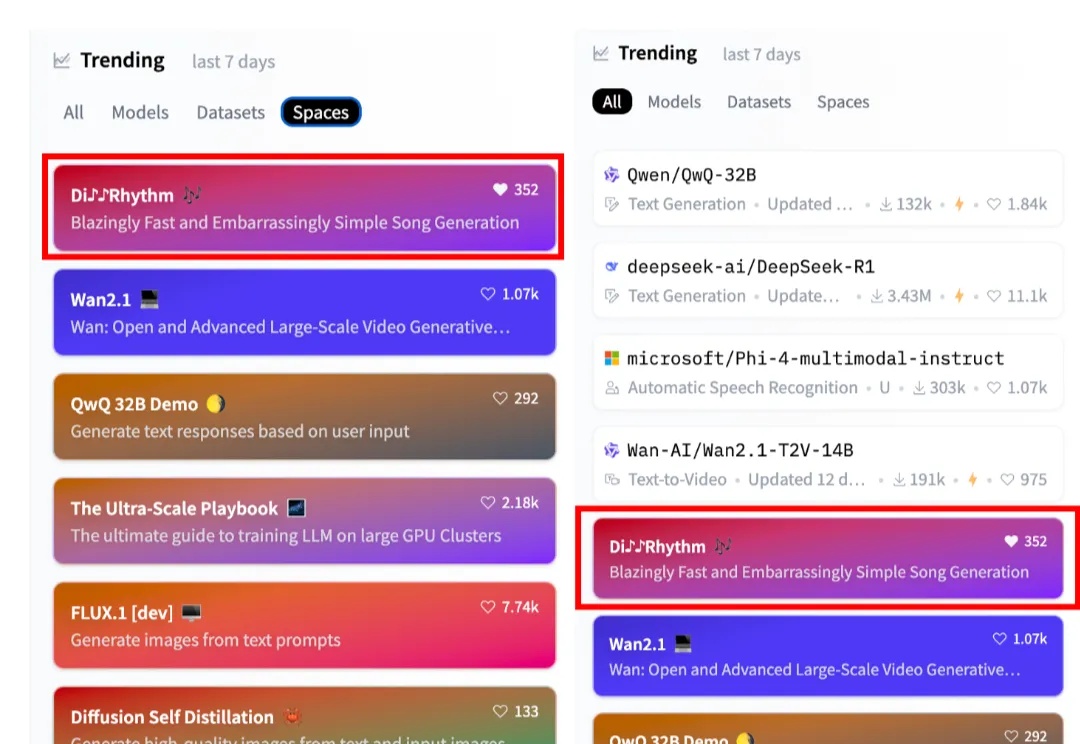
DiffRhythm是一款新型AI音乐生成模型,能在10秒内生成长达4分45秒的完整歌曲,包含人声和伴奏。它采用简单高效的全diffusion架构,仅需歌词和风格提示即可创作,还支持本地部署,最低只需8G显存。
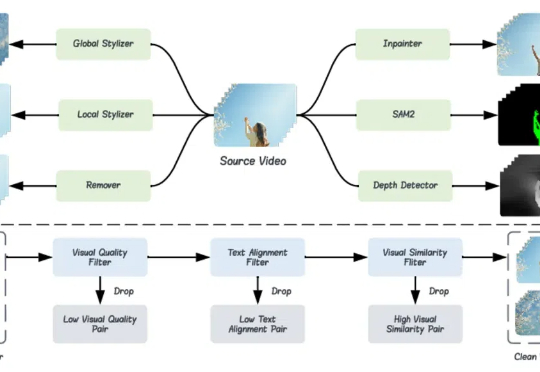
为了解决视频编辑模型缺乏训练数据的问题,本文作者(来自香港中文大学、香港理工大学、清华大学等高校和云天励飞)提出了一个名为 Señorita-2M 的数据集。该数据集包含 200 万高质量的视频编辑对,囊括了 18 种视频编辑任务。