AI资讯新闻榜单内容搜索-SI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SI
CityDreamer4D: 下一个世界模型,何必是视频生成模型?

CityDreamer4D: 下一个世界模型,何必是视频生成模型?

CityDreamer4D: 下一个世界模型,何必是视频生成模型?

在过去的两年里,城市场景生成技术迎来了飞速发展,一个全新的概念 ——世界模型(World Model)也随之崛起。当前的世界模型大多依赖 Video Diffusion Models(视频扩散模型)强大的生成能力,在城市场景合成方面取得了令人瞩目的突破。然而,这些方法始终面临一个关键挑战:如何在视频生成过程中保持多视角一致性?

来自主题: AI技术研报
8813 点击    2025-01-28 11:53
滚烫Deepseek一夜刀掉英伟达4万亿,除夕开源多模态新模型:7B超越DALL-E 3和StableDiffusion

滚烫Deepseek一夜刀掉英伟达4万亿,除夕开源多模态新模型:7B超越DALL-E 3和StableDiffusion

滚烫Deepseek一夜刀掉英伟达4万亿,除夕开源多模态新模型:7B超越DALL-E 3和StableDiffusion

DeepSeek大爆出圈,现在连夜发布新模型——多模态Janus-Pro-7B,发布即开源。在GenEval和DPG-Bench基准测试中击败了DALL-E 3和Stable Diffusion。

来自主题: AI资讯
12936 点击    2025-01-28 10:54
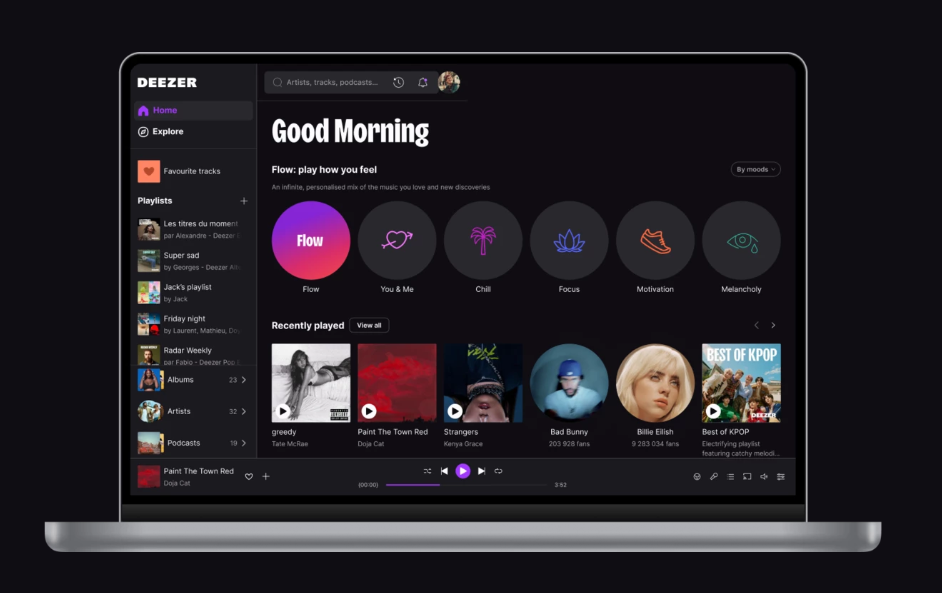
法国音乐流媒体平台Deezer日均上传超万首AI音乐,平台开始检测标记AI音乐和人工音乐做区分

法国音乐流媒体平台Deezer日均上传超万首AI音乐,平台开始检测标记AI音乐和人工音乐做区分

法国音乐流媒体平台Deezer日均上传超万首AI音乐,平台开始检测标记AI音乐和人工音乐做区分

法国音乐流媒体平台Deezer近日在其官方新闻稿中透露,每天有约10,000首“完全由人工智能生成的曲目”被上传至其平台。这一数字占Deezer每日新增内容的10%左右。尽管与Spotify和Apple Music等巨头相比,Deezer的规模较小,但其每日新增曲目量也达到了约10万首。

来自主题: AI资讯
8369 点击    2025-01-26 14:24
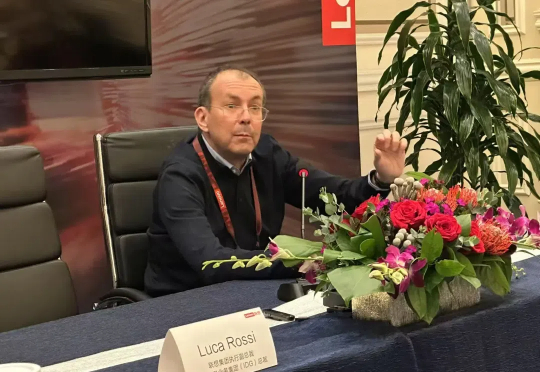
扛起联想75%营收的男人,对2025年AI硬件做出六点预测

扛起联想75%营收的男人,对2025年AI硬件做出六点预测

扛起联想75%营收的男人,对2025年AI硬件做出六点预测

谁是Luca Rossi?他的官方职位是“联想集团执行副总裁兼智能设备业务集团(IDG)总裁”,换成直白一点的形容,Luca管理着联想旗下几乎所有消费级终端产品——包括PC、智能手机、平板电脑等等。

来自主题: AI资讯
9753 点击    2025-01-24 12:47
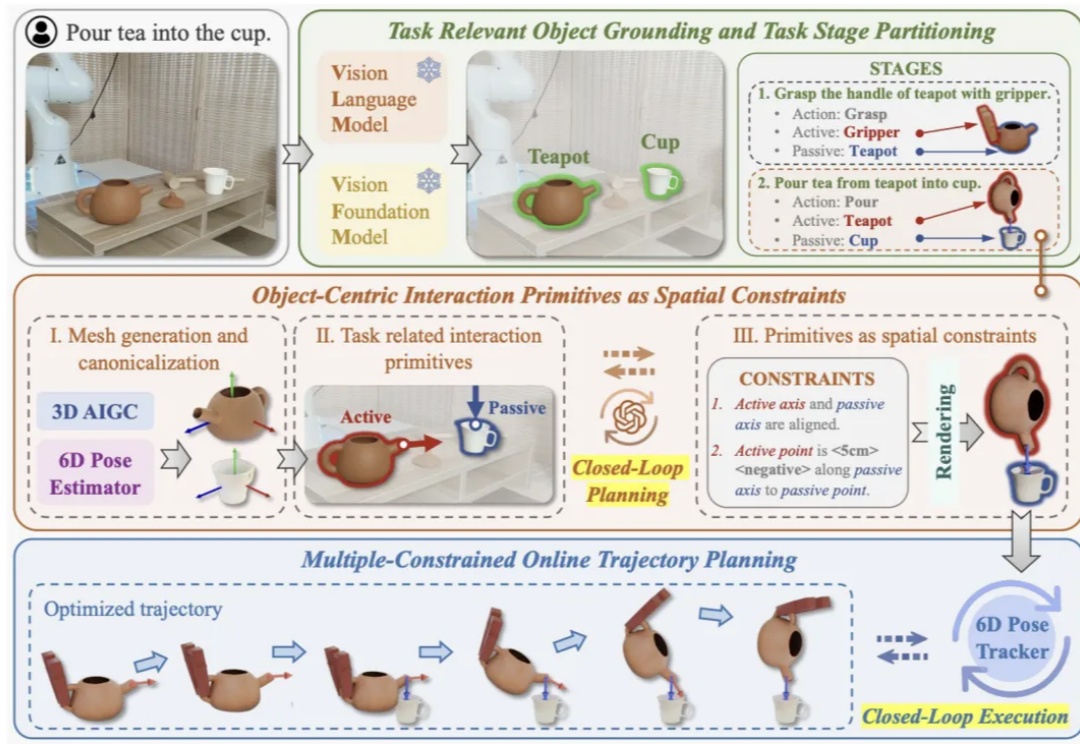
化解机器人的「幻觉」:北大发布OmniManip,VLM结合双闭环系统,3D理解能力大幅提升

化解机器人的「幻觉」:北大发布OmniManip,VLM结合双闭环系统,3D理解能力大幅提升

化解机器人的「幻觉」:北大发布OmniManip,VLM结合双闭环系统,3D理解能力大幅提升

近年来视觉语⾔基础模型(Vision Language Models, VLMs)在多模态理解和⾼层次常识推理上⼤放异彩,如何将其应⽤于机器⼈以实现通⽤操作是具身智能领域的⼀个核⼼问题。这⼀⽬标的实现受两⼤关键挑战制约:

来自主题: AI技术研报
9778 点击    2025-01-23 13:09
无直接数据可用,AI怎么学会「干活」?微软团队揭秘AI从语言到行动的进化之路

无直接数据可用,AI怎么学会「干活」?微软团队揭秘AI从语言到行动的进化之路

无直接数据可用,AI怎么学会「干活」?微软团队揭秘AI从语言到行动的进化之路

该技术报告的主要作者 Lu Wang, Fangkai Yang, Chaoyun Zhang, Shilin He, Pu Zhao, Si Qin 等均来自 Data, Knowledge, and Intelligence (DKI) 团队,为微软 TaskWeaver, WizardLLM, Windows GUI Agent UFO 的核心开发者。

来自主题: AI技术研报
8882 点击    2025-01-21 22:16
细粒度对齐无需仔细标注了!淘天提出视觉锚定奖励,自我校准实现多模态对齐

细粒度对齐无需仔细标注了!淘天提出视觉锚定奖励,自我校准实现多模态对齐

细粒度对齐无需仔细标注了!淘天提出视觉锚定奖励,自我校准实现多模态对齐

近年来,视觉大模型(Large Vision Language Models, LVLMs)领域经历了迅猛的发展,这些模型在图像理解、视觉对话以及其他跨模态任务中展现出了卓越的能力。然而,随着 LVLMs 复杂性和能力的增长,「幻觉现象」的挑战也日益凸显。

来自主题: AI技术研报
8571 点击    2025-01-19 14:51
OpenAI员工疯狂暗示,内部已成功开发ASI?被曝训出GPT-5但雪藏

OpenAI员工疯狂暗示,内部已成功开发ASI?被曝训出GPT-5但雪藏

OpenAI员工疯狂暗示,内部已成功开发ASI?被曝训出GPT-5但雪藏

OpenAI,有大事发生!最近各种爆料频出,比如OpenAI已经跨过「递归自我改进」临界点,o4、o5已经能自动化AI研发,甚至OpenAI已经研发出GPT-5?OpenAI员工如潮水般爆料,疯狂暗示内部已开发出ASI。

来自主题: AI资讯
10649 点击    2025-01-18 14:54
生成越长越跑偏?浙大商汤新作StarGen让场景视频生成告别「短片魔咒」

生成越长越跑偏?浙大商汤新作StarGen让场景视频生成告别「短片魔咒」

生成越长越跑偏?浙大商汤新作StarGen让场景视频生成告别「短片魔咒」

本文介绍了一篇由浙江大学章国锋教授和商汤科技研究团队联合撰写的论文《StarGen: A Spatiotemporal Autoregression Framework with Video Diffusion Model for Scalable and Controllable Scene Generation》。

来自主题: AI技术研报
10426 点击    2025-01-17 11:14