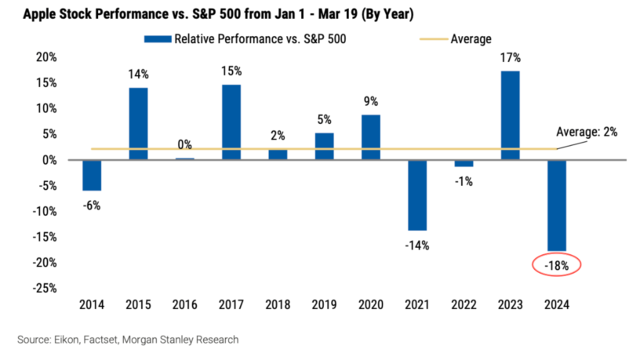
大摩:市场低估了苹果的AI计划
大摩:市场低估了苹果的AI计划苹果近期面临内忧外患,放弃造车让市场感到颓势尽显,新产品Vision Pro需求也大幅放缓,在中国市场的手机市占率也被华为超越;同时,外部也面临各国政府反垄断围剿,无论是欧盟首次启动新数字法展开针对苹果等科技巨头的调查,还是美国司法部最近的反垄断起诉。大量的负面信息导致苹果股价今年迄今已经跌超11%,是过去10年来最差的开年表现。
来自主题: AI资讯
12718 点击 2024-03-26 13:45

 搜索
苹果近期面临内忧外患,放弃造车让市场感到颓势尽显,新产品Vision Pro需求也大幅放缓,在中国市场的手机市占率也被华为超越;同时,外部也面临各国政府反垄断围剿,无论是欧盟首次启动新数字法展开针对苹果等科技巨头的调查,还是美国司法部最近的反垄断起诉。大量的负面信息导致苹果股价今年迄今已经跌超11%,是过去10年来最差的开年表现。
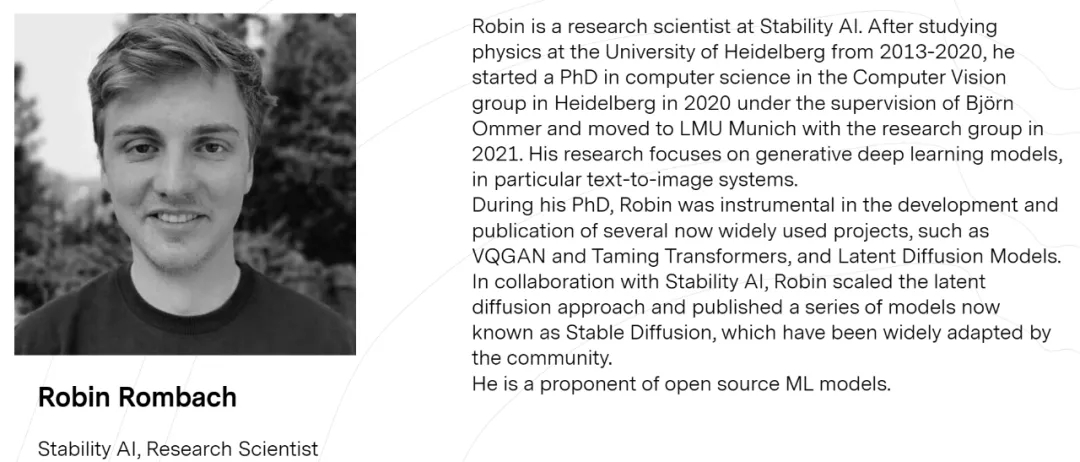
内部核心员工出走频繁,外部投资者不断丧失信心,成立于 2019 年的 AI 初创公司 Stability AI 还能推出伟大的产品吗?
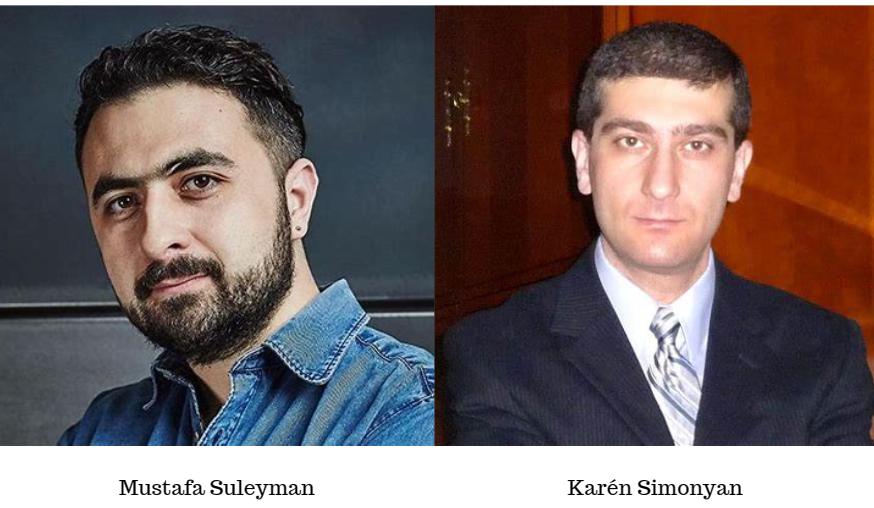
3月19日,微软发文称,公司已聘请了Inflection AI的CEO穆斯塔法-苏莱曼(Mustafa Suleyman )和首席科学家卡伦-西蒙扬(Karén Simonyan)将前往微软,前者将领导新成立的微软人工智能部门。据了解,前往微软的还有Inflection AI大部分员工。
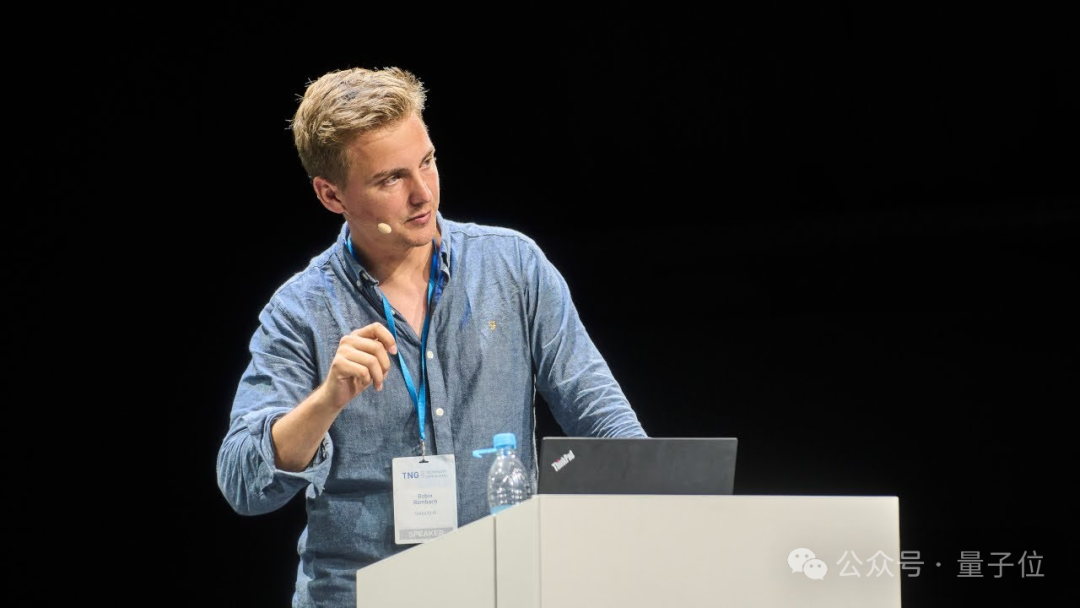
最新消息,Stable Diffusion核心研究团队已集体辞职!名单包括研究团队领导、论文一作Robin Rombach,共同一作Andreas Blattmann,以及另一位作者Dominik Lorenz。
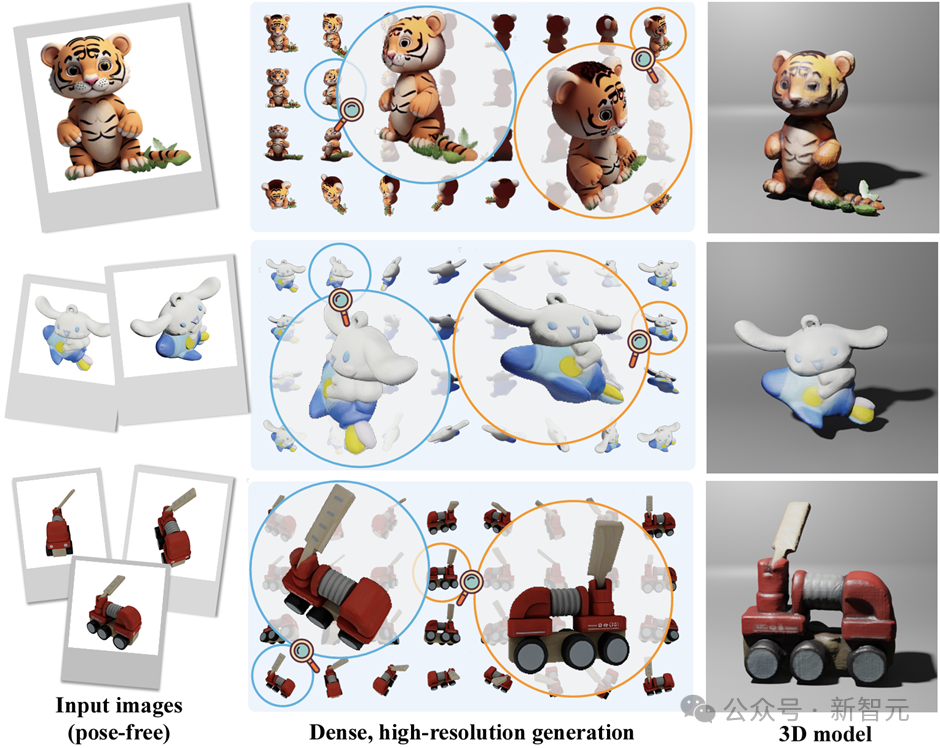
受人类视觉系统的启发,MVDiffusion++结合计算方法高保真和人类视觉系统灵活性,可以根据任意数量的无位姿图片, 生成密集、高分辨率的有位姿图像,实现了高质量的3D模型重建。
3D 生成领域迎来新的「SOTA 级选手」,支持商用和非商用。Stability AI 的大模型家族来了一位新成员。昨日,Stability AI 继推出文生图 Stable Diffusion、文生视频 Stable Video Diffusion 之后,又为社区带来了 3D 视频生成大模型「Stable Video 3D」(简称 SV3D)。
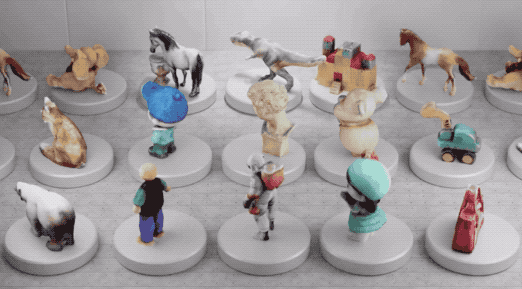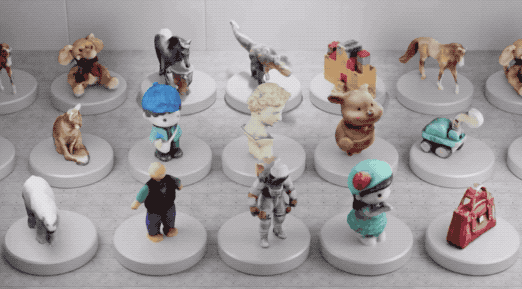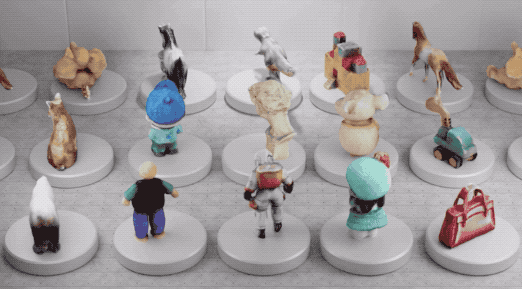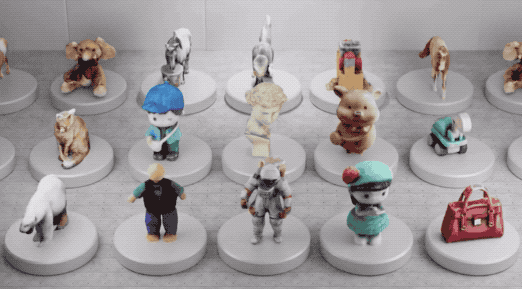
Stable Diffusion背后公司Stability AI又上新了。 这次带来的是图生3D方面的新进展: 基于Stable Video Diffusion的Stable Video 3D(SV3D),只用一张图片就能生成高质量3D网格。
【新智元导读】利用文本生成图片(Text-to-Image, T2I)已经满足不了人们的需要了,近期研究在T2I模型的基础上引入了更多类型的条件来生成图像,本文对这些方法进行了总结综述。
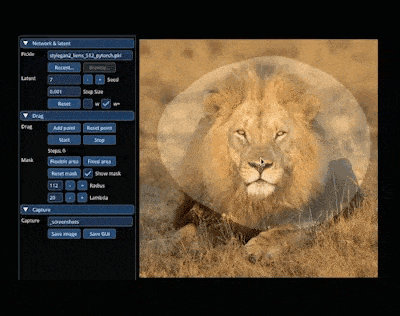
年 5 月,动动鼠标就能让图片变「活」得研究 DragGAN 吸引了 AI 圈的关注。通过拖拽,我们可以改变并合成自己想要的图像,比如下图中让一头狮子转头并张嘴!
近日,谷歌DeepMind宣布推出一个可扩展指令多世界智能体(Scalable Instructable Multiworld Agent,SIMA)。