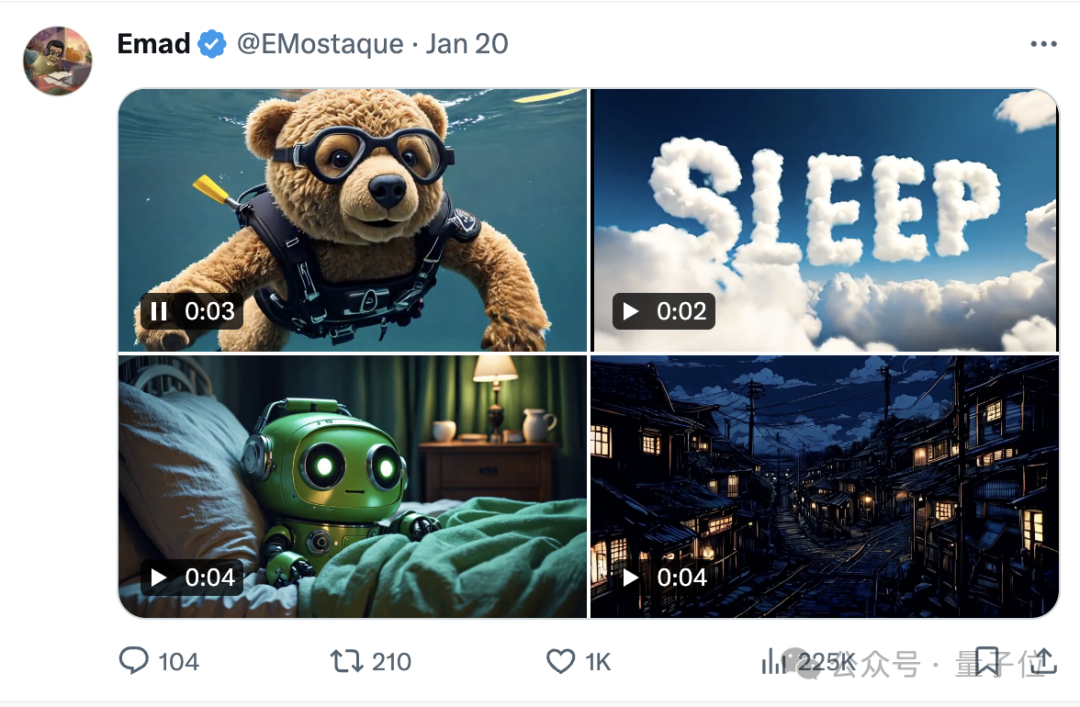
Stability AI杀回来了:视频生成新Demo效果惊人,网友:一致性超群
Stability AI杀回来了:视频生成新Demo效果惊人,网友:一致性超群Stable Diffusion要王者归来了?
来自主题: AI技术研报
4784 点击 2024-01-21 14:08

 搜索
Stable Diffusion要王者归来了?
主题驱动的文本到图像生成,通常需要在多张包含该主题(如人物、风格)的数据集上进行训练,这类方法中的代表工作包括 DreamBooth、Textual Inversion、LoRAs 等,但这类方案因为需要更新整个网络或较长时间的定制化训练,往往无法很有效地兼容社区已有的模型,并无法在真实场景中快速且低成本应用。

最近来自浙江大学ReLER实验室的研究人员提出SIFU模型,一种侧视图条件隐函数模型用于单张图片3D人体重建。模型通过引入人体侧视图作为先验条件,并结合扩散模型进行纹理增强,在几何与纹理重建测试中均达到SOTA,并且在真实世界中具有多种应用场景。
在自然语言处理(Natural Language Processing,NLP)领域,Transformer 模型因其在序列建模中的卓越性能而受到广泛关注。
LAMM (Language-Assisted Multi-Modal) 旨在建设面向开源学术社区的多模态指令微调及评测框架,其包括了高度优化的训练框架、全面的评测体系,支持多种视觉模态。
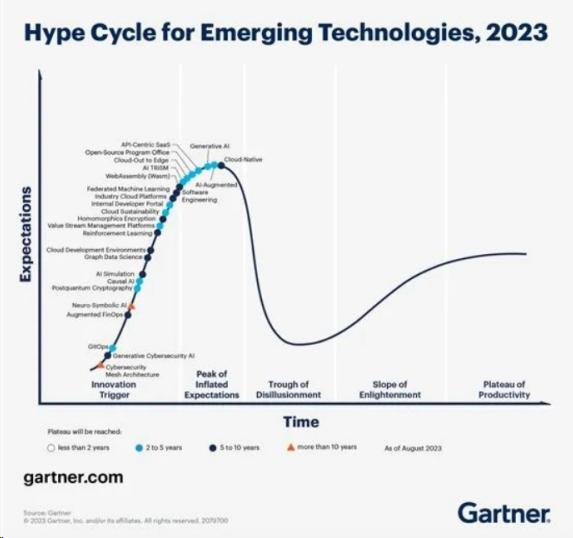
在本篇文章中,适道将综合Coatue、a16z、Radical Ventures等明星VC预言;The Information、FT、Sifted汇集的投资者预言;以及Greg Brockman等行业大佬的观点,试着归纳接下来一年中AI的发展脉络。
在过去短短两年内,随着诸如 LAION-5B 等大规模图文数据集的开放,Stable Diffusion、DALL-E 2、ControlNet、Composer ,效果惊人的图片生成方法层出不穷。图片生成领域可谓狂飙突进。
在 AI 领域,近年来各个子领域都逐渐向 transformer 架构靠拢,只有文生图和文生视频一直以 diffusion + u-net 结构作为主流方向。diffusion 有更公开可用的开源模型,消耗的计算资源也更少。
这篇论文介绍了一项新的任务 —— 指向性遥感图像分割(RRSIS),以及一种新的方法 —— 旋转多尺度交互网络(RMSIN)。
比互联网时代机会规模大10倍,但三分之二机会可能是大公司的。面对此次以生成式AI掀起的产业创新浪潮,硅谷技术VC——Fusion Fund的创始人张璐给出这样的论断。