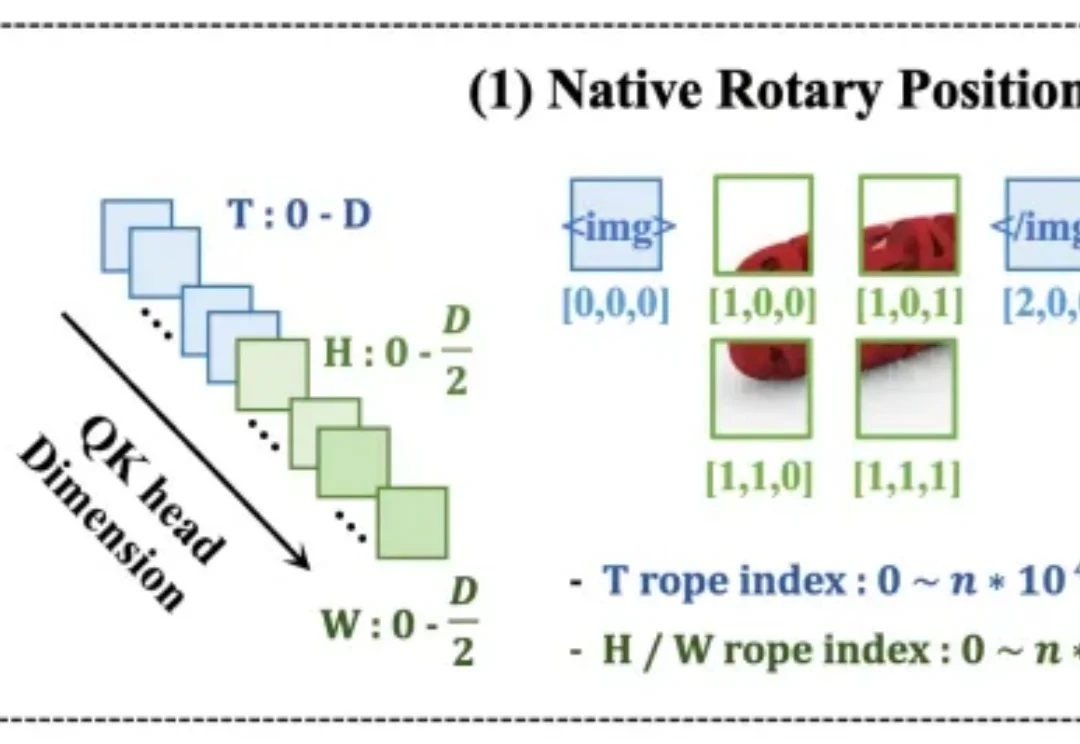
直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能
直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
来自主题: AI技术研报
8622 点击 2026-06-24 16:06

 搜索
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
Google DeepMind在6月份对外分享了DiffusionGemma的技术报告,明确指向了一条与现有主流完全不同的演进道路。当大家都在绞尽脑汁让大模型逐词吐字的速度变快时,谷歌干脆把生成顺序改了。
今天上午,利弗莫尔证券数据确认:MOMENTA GLOBAL LIMITED(梦腾智驾环球有限公司)已正式通过港交所上市聆讯,联席保荐人为中金公司、德意志银行。
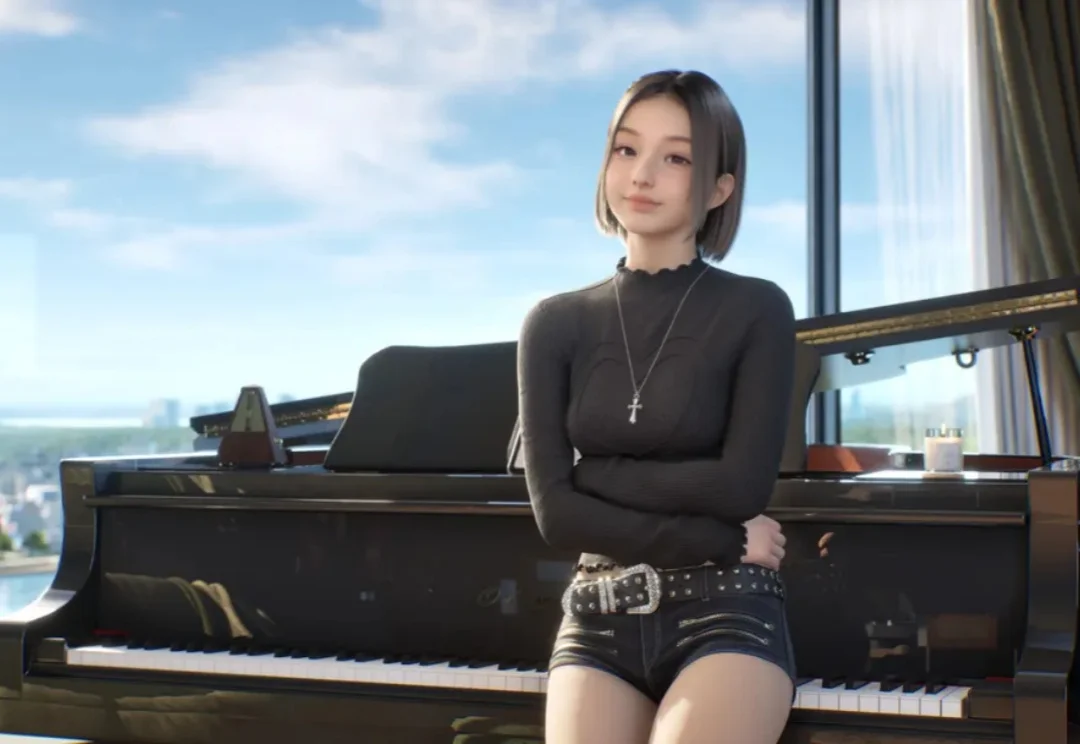
米哈游的新项目《BSide: Olivia Lin》,看起来不太像一款传统游戏。
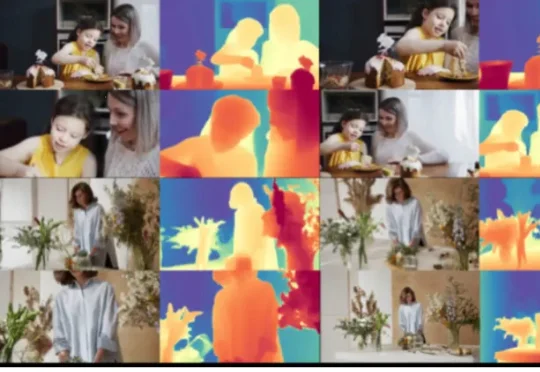
如今,CameraSquad 的出现,让这种多视角一致的视频生成与 3D 世界状态构建成为现实。近日,中国科学院大学高林研究员团队联合卡迪夫大学、香港科技大学和快手可灵团队,提出了一种面向多轨迹并行生成的相机可控视频生成方法 CameraSquad [1],相关论文已被 ACM SIGGRAPH 2026 录用。
真正把灵动岛推上风口的,是 6 月以来接连发生的几件事。6 月 8 日的 WWDC 2026,苹果发布了全新的 Siri AI。Federighi 在台上的原话是,苹果要「带来下一代 Apple Intelligence,并推出 Siri AI,一个明显更聪明、更博学、也更能干的 Siri」。
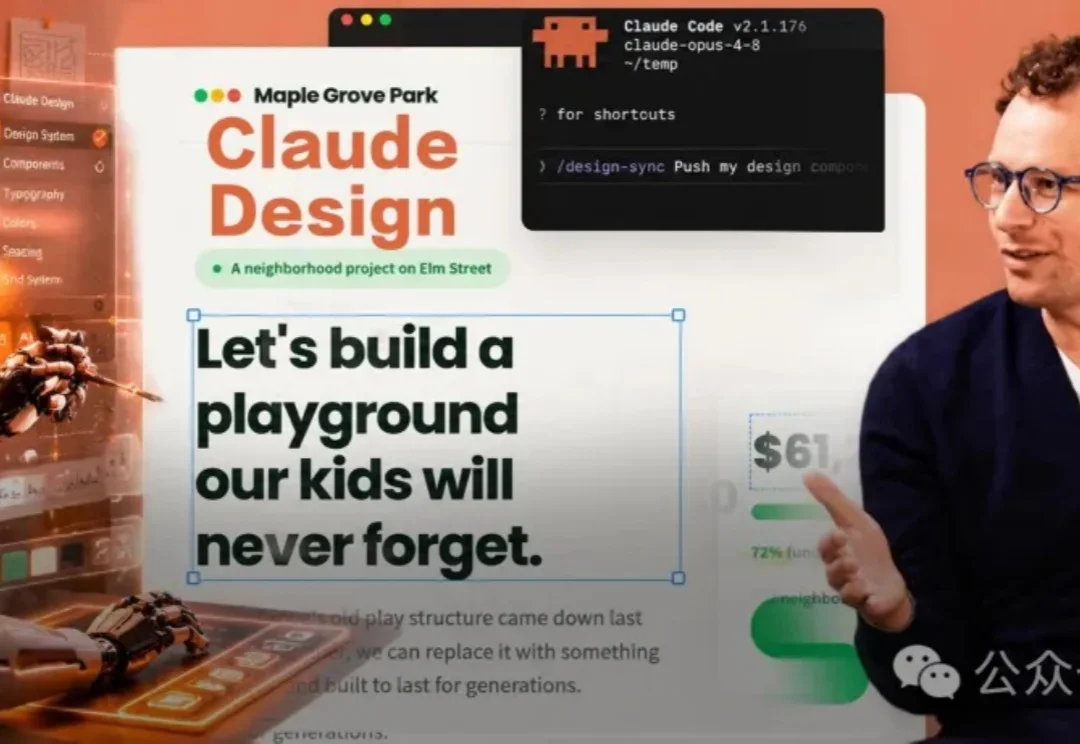
猝不及防!Anthropic深夜甩出Claude Design大更新,设计系统一键导入,代码双向同步,9大平台一键导出。Anthropic设计师亲自下场录屏:AI跑了八轮自查,才敢把设计稿给你看。
PD大促还有两个周就开始了,不知道做亚马逊的你们词库搭好了吗?
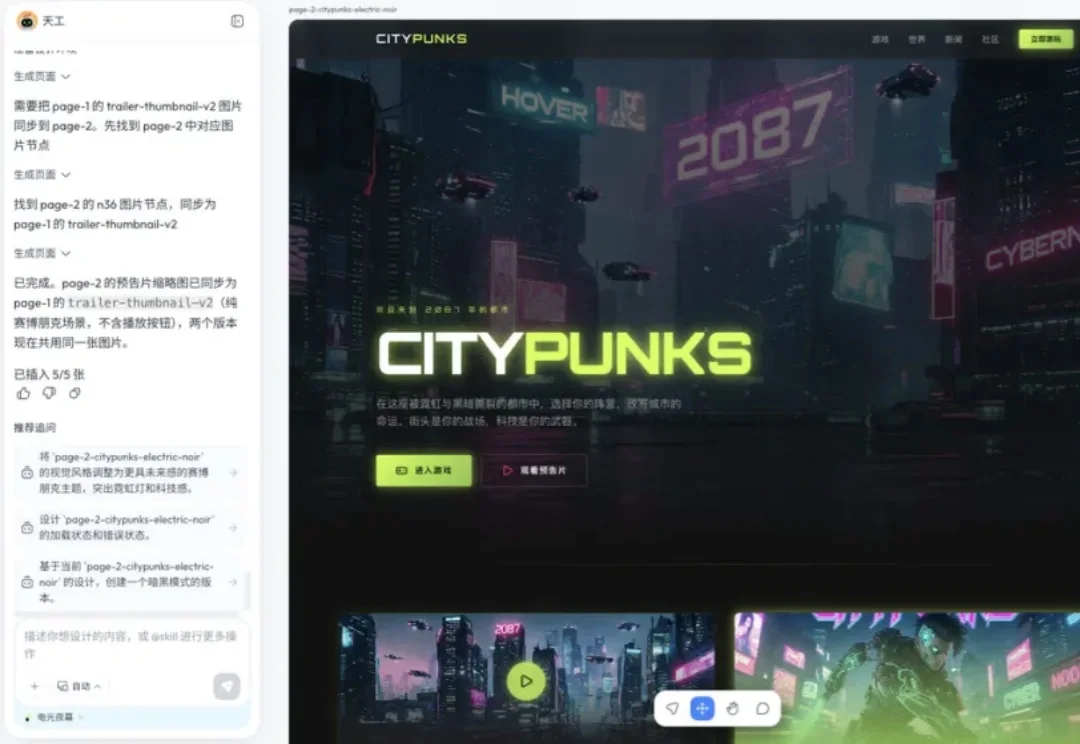
你有没有想过,做一个网站这件事,可能根本不需要会设计,也不需要会写代码?这听起来有点反常识,但天工刚好就在往这个方向走。6月15日,天工设计智能体正式在 tiangong.cn 全面上线,我看完它的介绍之后第一反应是,这不是又一个做图工具,这是想直接把从想法到产品原型这条路给压缩掉。
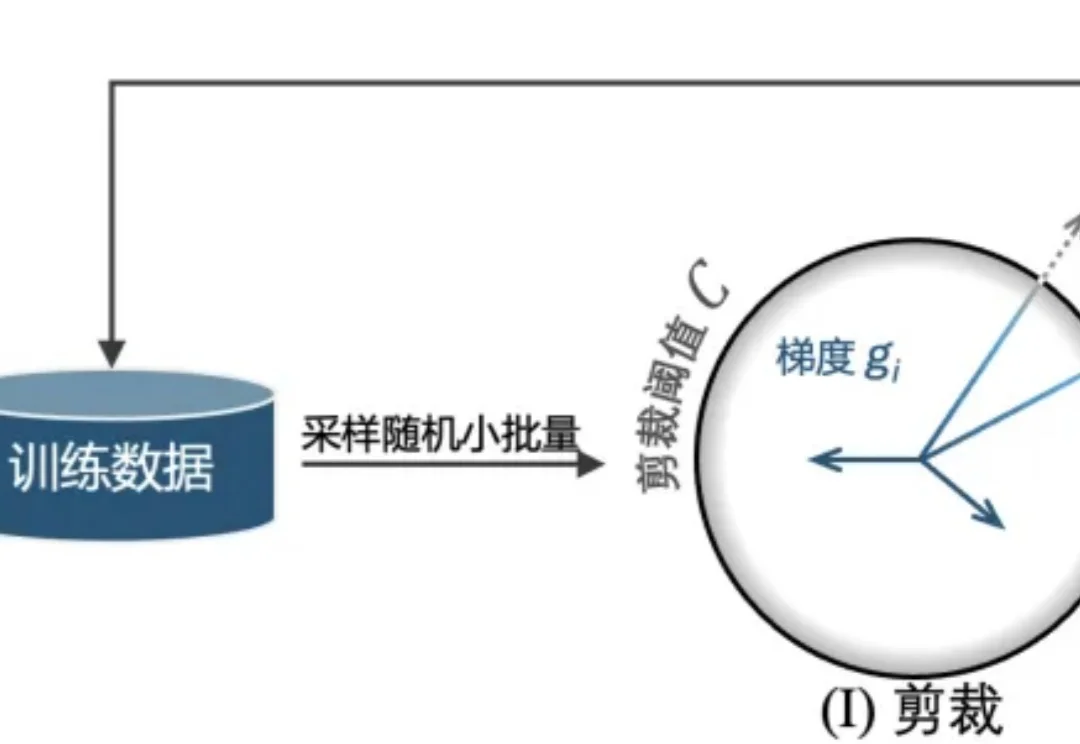
近日,来自英国南安普顿大学(University of Southampton)和广州大学的研究者团队提出 SlaClip,一种用于差分隐私随机梯度下降(DP-SGD)[1] 的自适应梯度剪裁方法。