AI资讯新闻榜单内容搜索-SI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SI
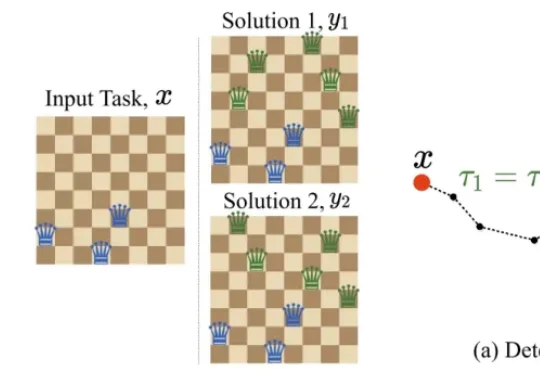
Bengio新论文刷新递归推理上限,并行轨迹碾压串行推理

Bengio新论文刷新递归推理上限,并行轨迹碾压串行推理

Bengio新论文刷新递归推理上限,并行轨迹碾压串行推理

现在,图灵奖得主 Yoshua Bengio 给出了一份全新的并行方案。他们提出了 GRAM(Generative Recursive reAsoning Models,生成式递归推理模型),把确定性的递归潜在推理变成了概率性的多轨迹计算。模型在潜在空间中进行随机递归推理,每一步都可以采样不同的方向,最终形成对解空间的多路径探索。

来自主题: AI技术研报
13180 点击    2026-05-24 10:12
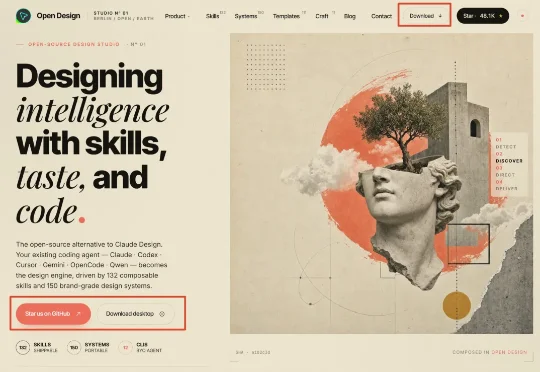
Claude绝对不想让你知道这个开源免费平替 |OpenDesign 8000字保姆级教程

Claude绝对不想让你知道这个开源免费平替 |OpenDesign 8000字保姆级教程

Claude绝对不想让你知道这个开源免费平替 |OpenDesign 8000字保姆级教程

最近有一个工具让我有点上头,而且越用越停不下来,越用越觉得这个工具太牛逼了,必须写一篇详细教程安利给大家。 它叫 Open Design。 如果你用过 Claude Design,你大概知道我在说什么。

来自主题: AI资讯
11842 点击    2026-05-23 20:55
AlphaGo之父把AI扔进23年的人造社会:智能体3块最硬骨头全在这

AlphaGo之父把AI扔进23年的人造社会:智能体3块最硬骨头全在这

AlphaGo之父把AI扔进23年的人造社会:智能体3块最硬骨头全在这

从Atari到AlphaGo,从AlphaStar到SIMA,DeepMind用游戏做AI研究已走过十余年,每换一个战场,研究问题就升一个量级。这一次的战场是EVE Online:一个跑了23年、从未重置的活宇宙。

来自主题: AI资讯
13268 点击    2026-05-23 13:48
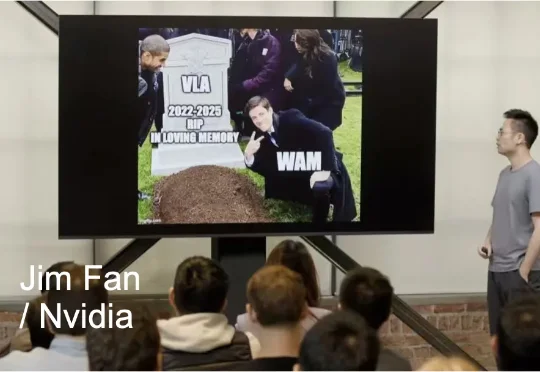
终结VLA?英伟达押注的具身新范式,首篇世界动作模型WAM综述重磅发布

终结VLA?英伟达押注的具身新范式,首篇世界动作模型WAM综述重磅发布

终结VLA?英伟达押注的具身新范式,首篇世界动作模型WAM综述重磅发布

Jim Fan 押注的这条 “先预测世界,再生成动作” 的新路,正是当下具身智能领域最炙手可热的下一代范式 —— 世界动作模型(World Action Models,简称 WAM)。虽然 WAM 正在迅速成为各大顶尖实验室的核心发力点,但业界至今仍然缺乏对它的统一标准和系统梳理。近期,复旦大学可信具身智能研究院,上海创智学院,新加坡国立大学发表了首篇 WAM 的详细综述。

来自主题: AI技术研报
17659 点击    2026-05-23 09:55
李飞飞最新发布ESI-Bench,空间智能的ImageNet来了

李飞飞最新发布ESI-Bench,空间智能的ImageNet来了

李飞飞最新发布ESI-Bench,空间智能的ImageNet来了

李飞飞团队最新发布ESI-Bench——一个专门用来评测具身空间智能的新基准。过去的空间智能评测默认给模型最优观测,而ESI-Bench第一个把观察者变成行动者,闭合了感知-行动回路。

来自主题: AI技术研报
10518 点击    2026-05-22 15:32
从《Time》年度发明到北美销量No.1,VITURE如何让XR眼镜「有用」?

从《Time》年度发明到北美销量No.1,VITURE如何让XR眼镜「有用」?

从《Time》年度发明到北美销量No.1,VITURE如何让XR眼镜「有用」?

很多人知道,苹果 Vision pro 是 VR 眼镜的市场标杆产品,Meta和Google都曾大举进军AI眼镜,但鲜有人知的是,2025年冲到北美第一的 XR 眼镜,是一家很低调的公司——VITURE。

来自主题: AI资讯
8573 点击    2026-05-22 09:27
ICML 2026|传统UED瓶颈被打破,强化学习也能精准定位「最近发展区」

ICML 2026|传统UED瓶颈被打破,强化学习也能精准定位「最近发展区」

ICML 2026|传统UED瓶颈被打破,强化学习也能精准定位「最近发展区」

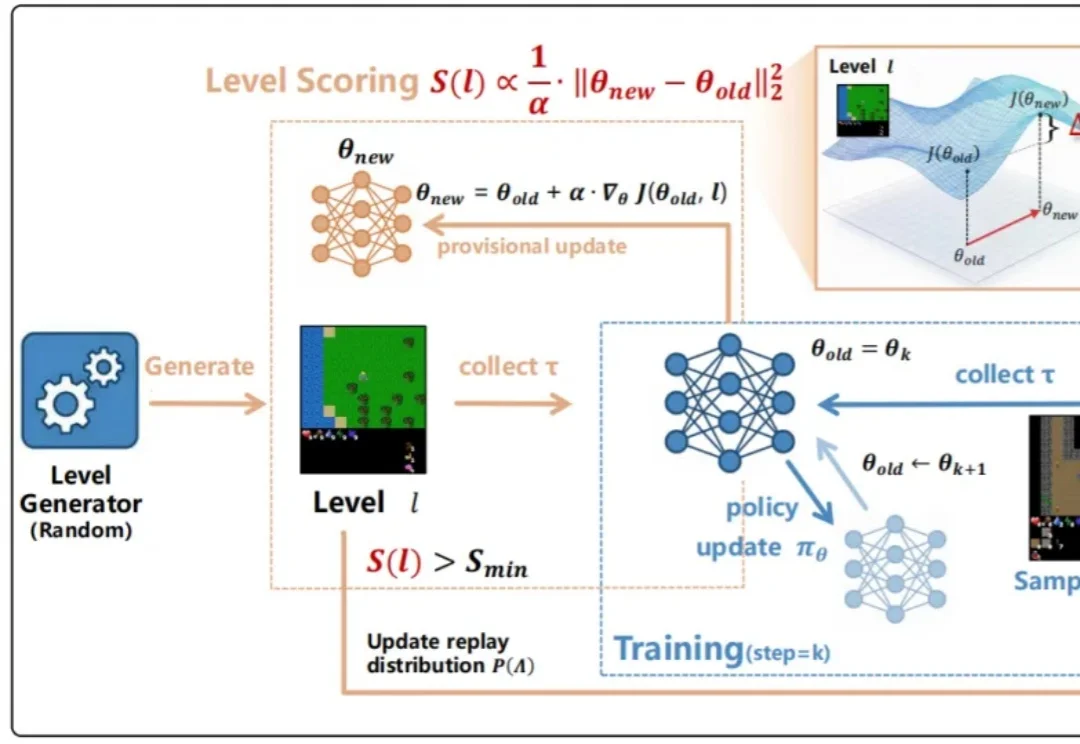
训练强化学习智能体时,一个常见问题是:有些 level 太简单,智能体跑几遍就会;有些 level 又太难,智能体几乎得不到有效反馈。前者只是在重复已有能力,后者则会把训练预算消耗在无效探索上。真正有价值的训练环境,往往位于二者之间。

来自主题: AI技术研报
10608 点击    2026-05-22 08:45
刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2

刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2

刚刚,谢赛宁团队放出第二代表征自编码器 RAEv2

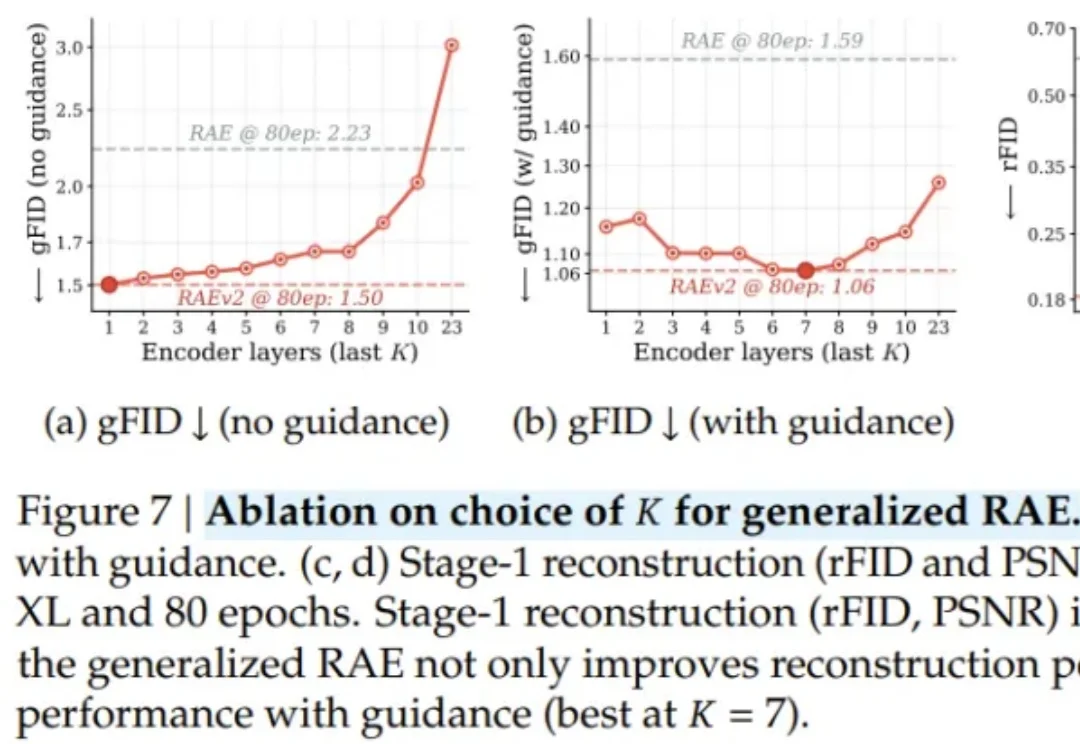
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?

来自主题: AI技术研报
9574 点击    2026-05-21 16:45
体验完阿里首款Design Agent,我开始替UI/前端焦虑了..

体验完阿里首款Design Agent,我开始替UI/前端焦虑了..

体验完阿里首款Design Agent,我开始替UI/前端焦虑了..

大家好,我是袋鼠帝 作为一名后端程序员,我略懂前端,但是对于UI设计是一窍不通。

来自主题: AI产品测评
9651 点击    2026-05-21 16:10
CVPR 2026 | 让3DGS看见内部结构,中关村学院GaussianPile实现切片式容积影像快速重建

CVPR 2026 | 让3DGS看见内部结构,中关村学院GaussianPile实现切片式容积影像快速重建

CVPR 2026 | 让3DGS看见内部结构,中关村学院GaussianPile实现切片式容积影像快速重建

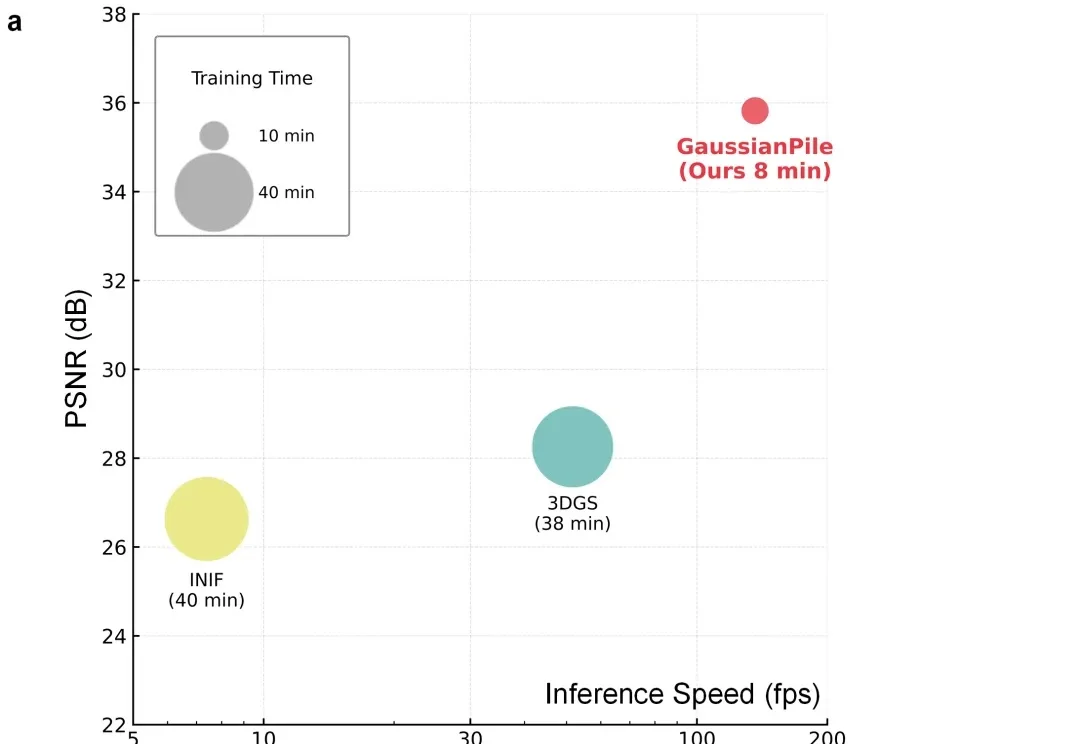
近年来,3D Gaussian Splatting(3DGS)在三维视觉和图形学中展现出很强的表示与渲染能力。相比传统体素或神经辐射场,它用一组可优化的各向异性高斯来表示三维场景,既能保留连续空间结构,又能实现高速渲染。

来自主题: AI技术研报
6707 点击    2026-05-21 16:09