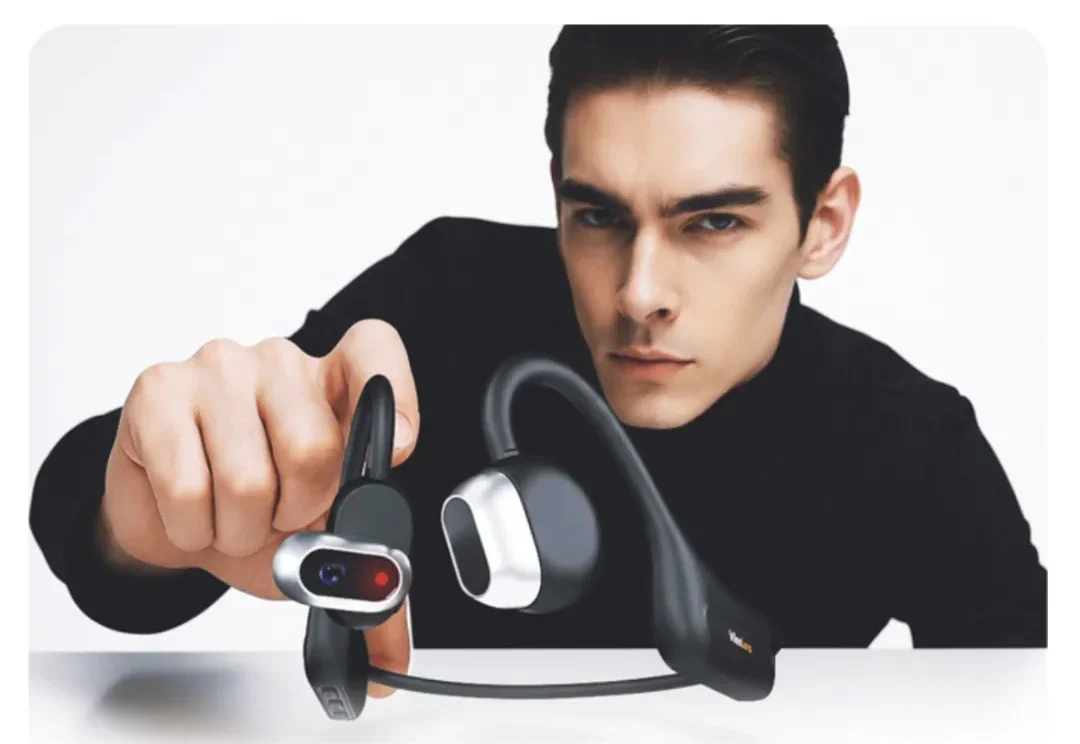
逃离内卷:一个深圳老板自投 1000 多万「豪赌」出的 AI 硬件新品类——相机耳机/MusicCam
逃离内卷:一个深圳老板自投 1000 多万「豪赌」出的 AI 硬件新品类——相机耳机/MusicCam面对「9 块 9 包邮」的耳机内卷,传统制造商何卫自投 1000 多万 All-in 新品 MusicCam。他坚信,只有通过重投入、差异化和清晰的海外布局,才能摆脱「乙方」的命运,重新夺回市场主动权。
来自主题: AI资讯
10651 点击 2025-12-17 16:18

 搜索
面对「9 块 9 包邮」的耳机内卷,传统制造商何卫自投 1000 多万 All-in 新品 MusicCam。他坚信,只有通过重投入、差异化和清晰的海外布局,才能摆脱「乙方」的命运,重新夺回市场主动权。
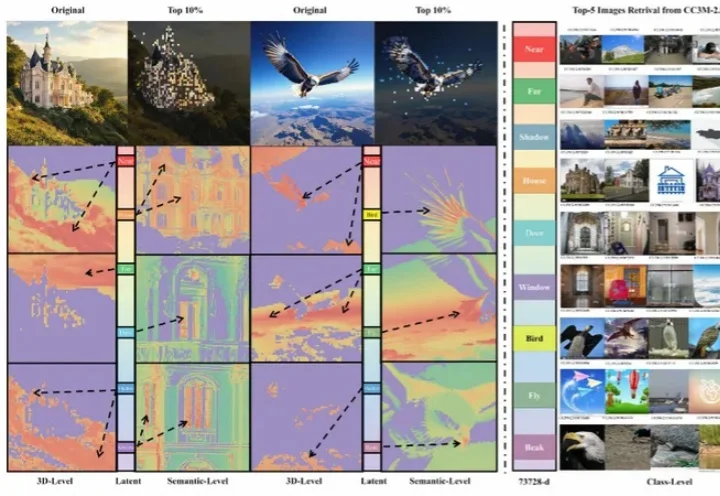
过去三年,扩散模型席卷图像生成领域。以 DiT (Diffusion Transformer) 为代表的新一代架构不断刷新图像质量的极限,让模型愈发接近真实世界的视觉规律。
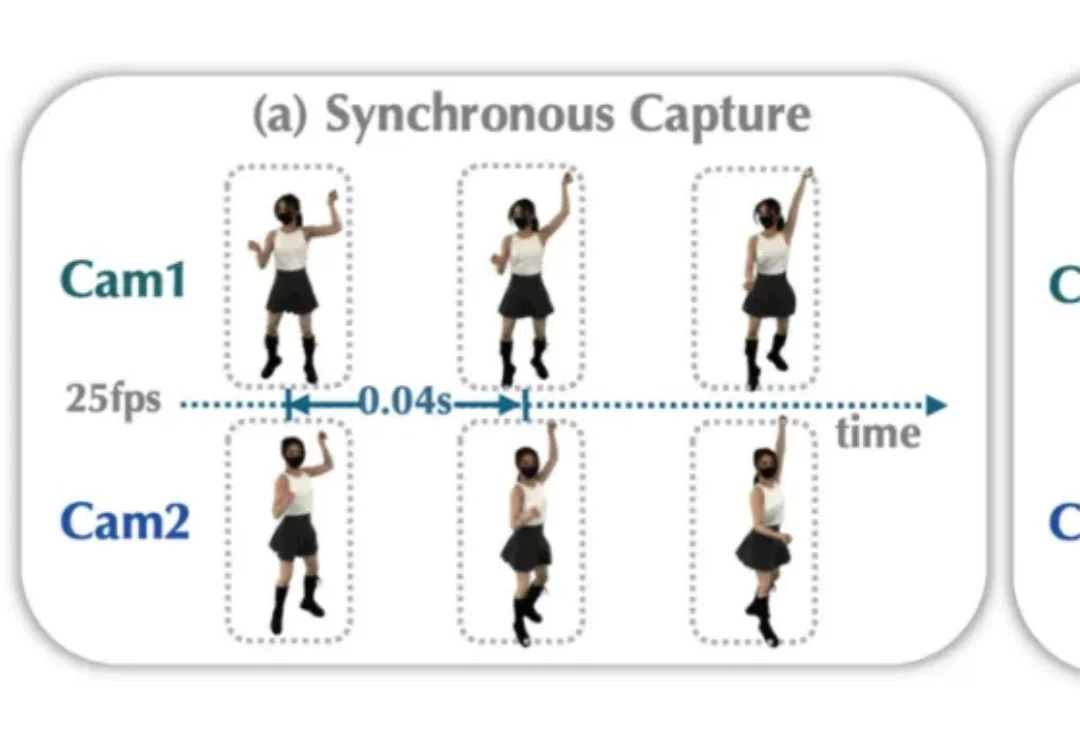
当古装剧中的长袍在武林高手凌空翻腾的瞬间扬起 0.01 秒的惊艳弧度,当 VR 玩家想伸手抓住对手 “空中定格” 的剑锋,当 TikTok 爆款视频里一滴牛奶皇冠般的溅落要被 360° 无死角重放 —— 如何用普通的摄像机,把瞬间即逝的高速世界 “冻结” 成可供反复拆解、传送与交互的数字化 4D 时空,成为 3D 视觉领域的一个难题。
破解AI胡说八道的关键,居然是给大模型砍断99.9%的连接线?
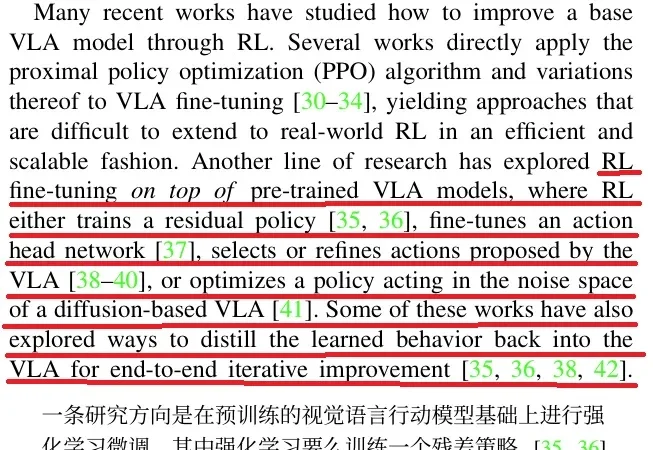
在 Physical Intelligence 最新的成果 π0.6 论文里,他们介绍了 π0.6 迭代式强化学习的思路来源:
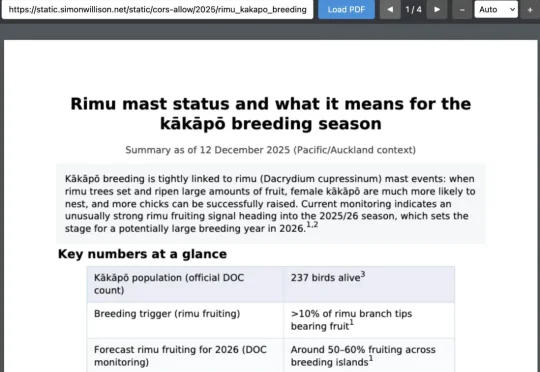
还在争论Skills是不是prompt?已经可以停下火了。因为,刚刚得到的消息消息,OpenAI已经悄悄地用上了Skills了。今天,知名博主、Django Web 框架联合创始人Simon Willson爆料:
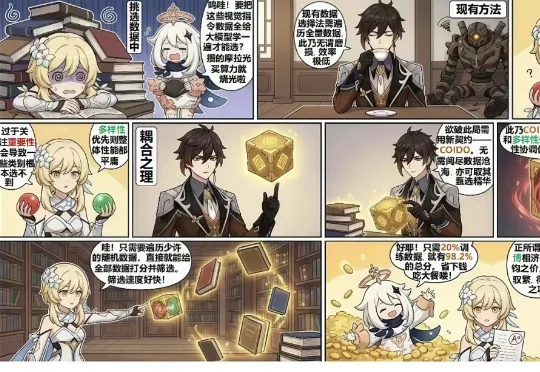
在深入技术细节之前,我们先用一张漫画来直观理解 COIDO (Coupled Importance-Diversity Optimization) 解决的核心问题与方案:正如钟离在漫画中所言,面对海量视觉指令数据的选择任务,传统方法需要遍历全部数据才能进行筛选造成大量「磨损」(高昂计算成本)。同时在面对数据重要性和多样性问题时,传统方法往往顾此失彼。
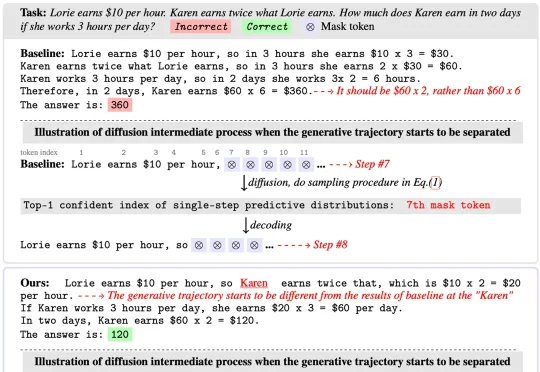
扩散语言模型(Diffusion Language Models)以其独特的 “全局规划” 与并行解码能力广为人知,成为 LLM 领域的全新范式之一。然而在 Any-order 解码模式下,其通常面临

实现通用机器人的类人灵巧操作能力,是机器人学领域长期以来的核心挑战之一。近年来,视觉 - 语言 - 动作 (Vision-Language-Action,VLA) 模型在机器人技能学习方面展现出显著潜力,但其发展受制于一个根本性瓶颈:高质量操作数据的获取。
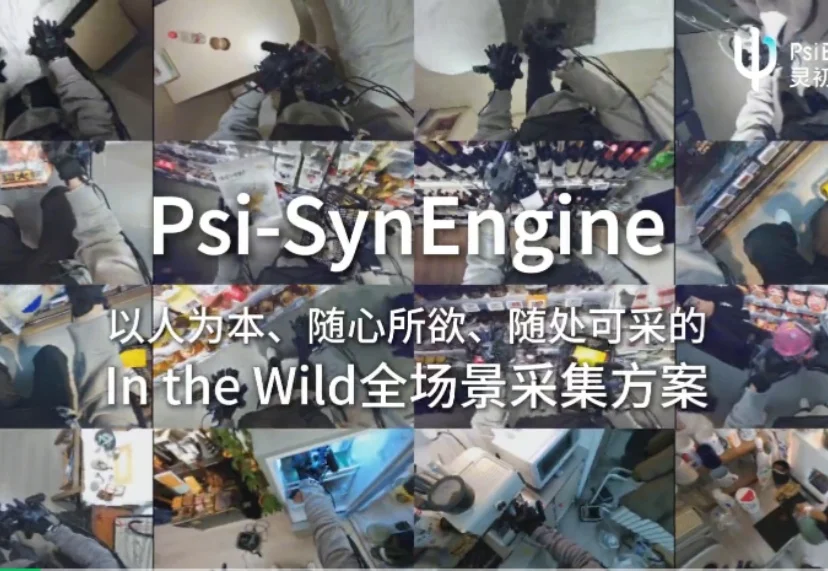
灵初智能发布全球首个具身原生人类数据采集方案 Psi-SynEngine。该方案由灵初智能全栈自研,包含便携式外骨骼触觉手套数采套装、大规模 in the wild 数采数据管线、基于世界模型和强化学习的跨本体数据迁移模型,并已率先将采集到的人类数据应用于物流等真实场景。