AI资讯新闻榜单内容搜索-SI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SI
AMD携手Stability AI推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型,带来更快速且画质无损的文生图功能

AMD携手Stability AI推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型,带来更快速且画质无损的文生图功能

AMD携手Stability AI推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型,带来更快速且画质无损的文生图功能

AMD携手Stability AI宣布推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型。该模型可直接运行于AMD XDNA 2 NPU之上,能够显著提升图像生成质量。新模型作为Amuse 3.1平台的组件之一亮相,于今天一起发布。

来自主题: AI资讯
12195 点击    2025-07-23 10:06
AI“压力面”,DeepSeek性能暴跌近30% | 清华&上海AI Lab

AI“压力面”,DeepSeek性能暴跌近30% | 清华&上海AI Lab

AI“压力面”,DeepSeek性能暴跌近30% | 清华&上海AI Lab

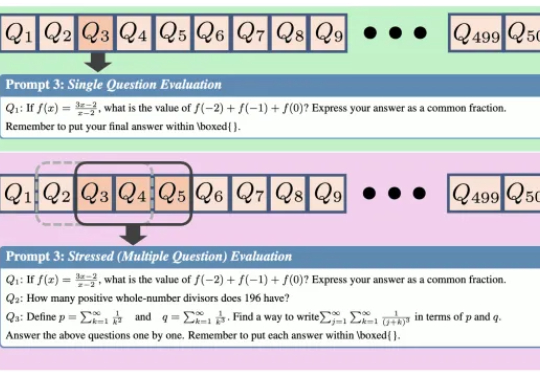
给AI一场压力测试,结果性能暴跌近30%。 来自上海人工智能实验室、清华大学和中国人民大学的研究团队设计了一个全新的“压力测试”框架——REST (Reasoning Evaluation through Simultaneous Testing)。

来自主题: AI技术研报
11222 点击    2025-07-21 10:44
Transformer终结者!谷歌DeepMind全新MoR架构问世,新一代魔王来了

Transformer终结者!谷歌DeepMind全新MoR架构问世,新一代魔王来了

Transformer终结者!谷歌DeepMind全新MoR架构问世,新一代魔王来了

Transformer杀手来了?KAIST、谷歌DeepMind等机构刚刚发布的MoR架构,推理速度翻倍、内存减半,直接重塑了LLM的性能边界,全面碾压了传统的Transformer。网友们直呼炸裂:又一个改变游戏规则的炸弹来了。

来自主题: AI技术研报
11286 点击    2025-07-17 17:00
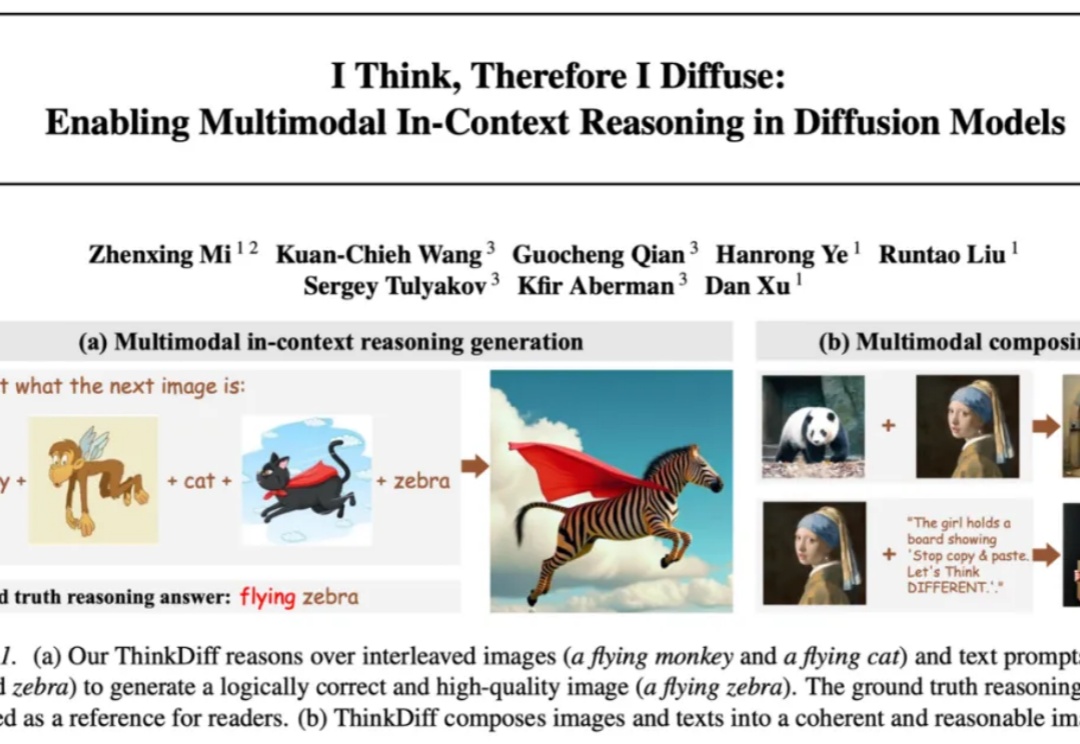
ICML 2025|多模态理解与生成最新进展:港科联合SnapResearch发布ThinkDiff,为扩散模型装上大脑

ICML 2025|多模态理解与生成最新进展:港科联合SnapResearch发布ThinkDiff,为扩散模型装上大脑

ICML 2025|多模态理解与生成最新进展:港科联合SnapResearch发布ThinkDiff,为扩散模型装上大脑

自 Stable Diffusion、Flux 等扩散模型 (Diffusion models) 席卷图像生成领域以来,文本到图像的生成技术取得了长足进步。但它们往往只能根据精确的文字或图片提示作图,缺乏真正读懂图像与文本、在多模 态上下文中推理并创作的能力。能否让模型像人类一样真正读懂图像与文本、完成多模态推理与创作,一直是学术界和工业界关注的热门问题。

来自主题: AI技术研报
9966 点击    2025-07-16 15:19
比Adam更有效,POET从谱不变原理出发,让LLM训练又稳又快

比Adam更有效,POET从谱不变原理出发,让LLM训练又稳又快

比Adam更有效,POET从谱不变原理出发,让LLM训练又稳又快

Zeju Qiu和Tim Z. Xiao是德国马普所博士生,Simon Buchholz和Maximilian Dax担任德国马普所博士后研究员

来自主题: AI技术研报
11134 点击    2025-07-15 10:11
VLA 推理新范式!一致性模型 CEED-VLA 实现四倍加速!

VLA 推理新范式!一致性模型 CEED-VLA 实现四倍加速!

VLA 推理新范式!一致性模型 CEED-VLA 实现四倍加速!

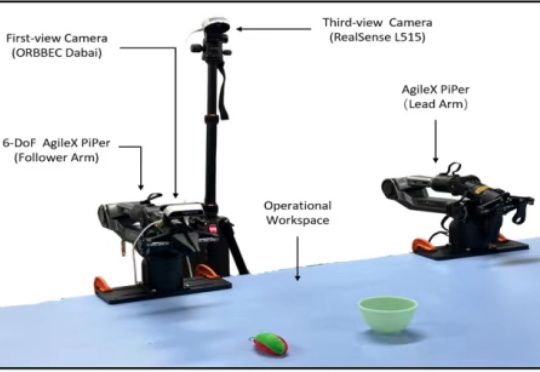
近年来,视觉 - 语言 - 动作(Vision-Language-Action, VLA)模型因其出色的多模态理解与泛化能力,已成为机器人领域的重要研究方向。尽管相关技术取得了显著进展,但在实际部署中,尤其是在高频率和精细操作等任务中,VLA 模型仍受到推理速度瓶颈的严重制约。

来自主题: AI技术研报
8542 点击    2025-07-14 11:12
EasyCache:无需训练的视频扩散模型推理加速——极简高效的视频生成提速方案

EasyCache:无需训练的视频扩散模型推理加速——极简高效的视频生成提速方案

EasyCache:无需训练的视频扩散模型推理加速——极简高效的视频生成提速方案

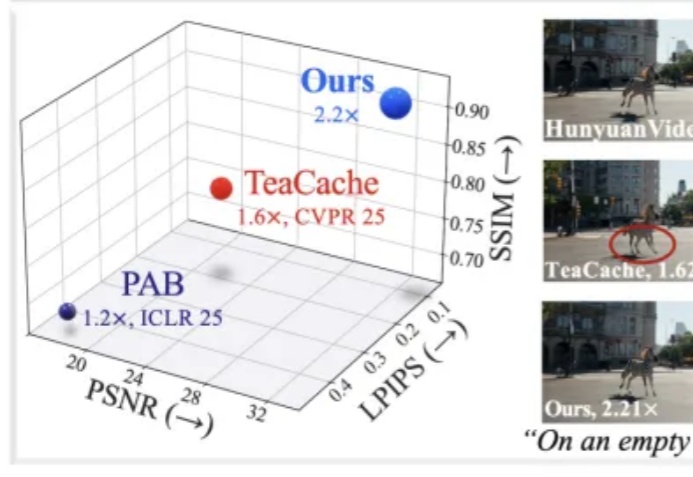
近年来,随着扩散模型(Diffusion Models)和扩散 Transformer(DiT)在视频生成领域的广泛应用,AI 合成视频的质量和连贯性有了飞跃式提升。像 OpenAI Sora、HunyuanVideo、Wan2.1 等大模型,已经能够生成结构清晰、细节丰富且高度连贯的长视频内容,为数字内容创作、虚拟世界和多媒体娱乐带来了巨大变革。

来自主题: AI技术研报
9414 点击    2025-07-14 10:42
告别Transformer!北大、北邮、华为开源纯卷积DiC:3x3卷积实现SOTA性能,比DiT快5倍!

告别Transformer!北大、北邮、华为开源纯卷积DiC:3x3卷积实现SOTA性能,比DiT快5倍!

告别Transformer!北大、北邮、华为开源纯卷积DiC:3x3卷积实现SOTA性能,比DiT快5倍!

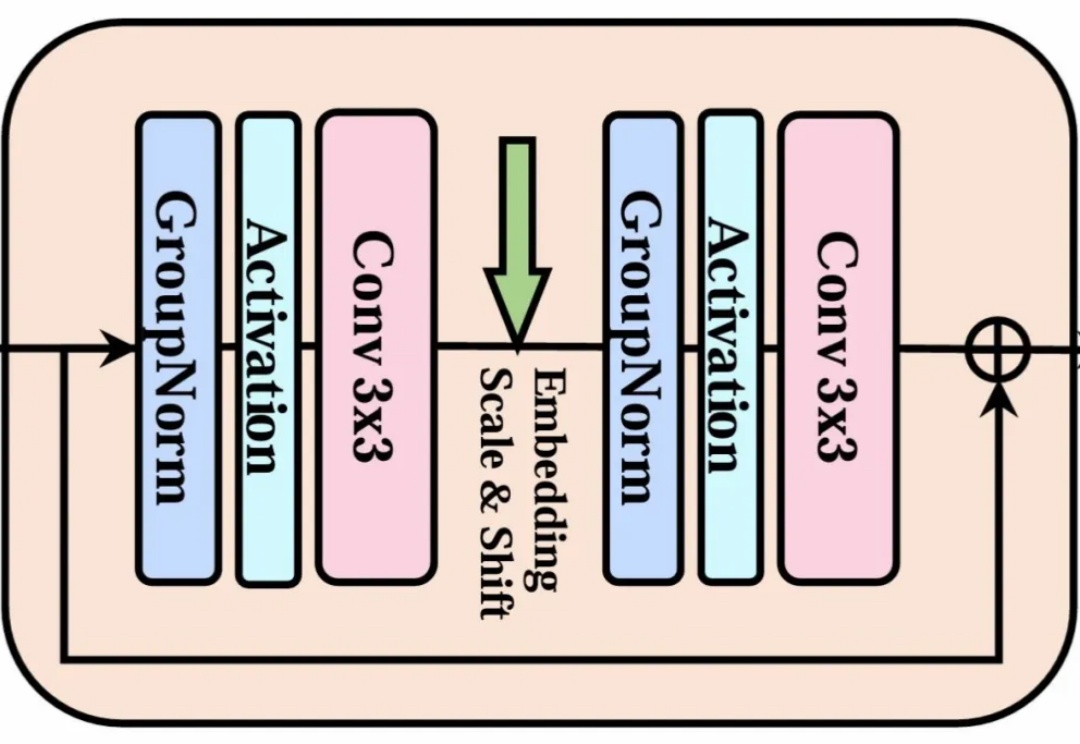
当整个 AI 视觉生成领域都在 Transformer 架构上「卷生卷死」时,一项来自北大、北邮和华为的最新研究却反其道而行之,重新审视了深度学习中最基础、最经典的模块——3x3 卷积。

来自主题: AI技术研报
9843 点击    2025-07-14 10:25
Meta发布40页报告,具身智能的下一步是「心智世界模型」:能听,能看,能理解,会共情

Meta发布40页报告,具身智能的下一步是「心智世界模型」:能听,能看,能理解,会共情

Meta发布40页报告,具身智能的下一步是「心智世界模型」:能听,能看,能理解,会共情

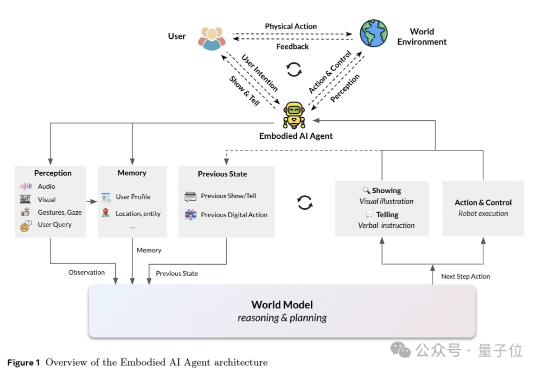
这篇报告第一次把对人心智状态的推断,放到和物理世界模型(physical world model)同等重要的位置上,并将其概念化为心智世界模型(mental world model)。相比于传统世界模型(如LeCun的JEPA)仅关注物理规律(物体运动、机械因果),心智世界模型则首次将心理规律(意图、情感、社会关系)纳入世界模型框架,实现“双轨建模”。

来自主题: AI资讯
9679 点击    2025-07-11 12:25