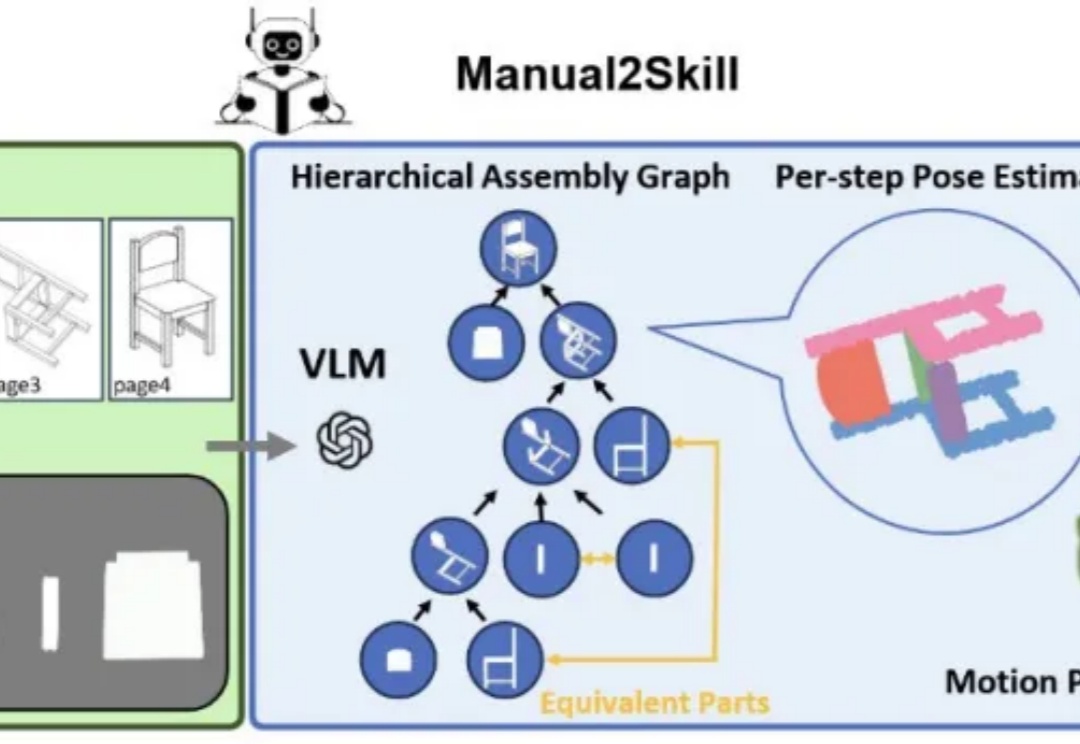
RSS 2025|从说明书学习复杂机器人操作任务:NUS邵林团队提出全新机器人装配技能学习框架Manual2Skill
RSS 2025|从说明书学习复杂机器人操作任务:NUS邵林团队提出全新机器人装配技能学习框架Manual2Skill视觉语言模型(Vision-Language Models, VLMs),为真实环境中的机器人操作任务提供了极具潜力的解决方案。
来自主题: AI技术研报
11591 点击 2025-05-29 16:33

 搜索
视觉语言模型(Vision-Language Models, VLMs),为真实环境中的机器人操作任务提供了极具潜力的解决方案。
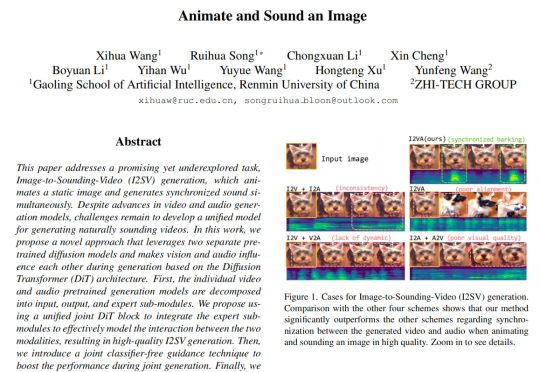
来自中国人民大学高瓴人工智能学院与值得买科技 AI 团队在 CVPR 2025 会议上发表了一项新工作,首次提出了一种从静态图像直接生成同步音视频内容的生成框架。其核心设计 JointDiT(Joint Diffusion Transformer)框架实现了图像 → 动态视频 + 声音的高质量联合生成。
想象一下,作为销售经理,你每天晚上都会被一个问题困扰:我的销售代表今天在客户家里到底说了什么?这不是什么玄学,而是销售行业一个长期存在的盲区。我们有监控后台操作的工具,有分析线上会议的软件,甚至有追踪每个电话的系统,但对于面对面销售这个最关键的环节,我们却一直处在黑暗中摸索。
从OpenAI 的 4o 到 Stable Diffusion,能够根据文本提示生成逼真图像的 AI 基础模型如今已比比皆是。相比之下,能够仅凭文本提示就生成完整、连贯的 3D 在线环境的基础模型才刚刚崭露头角。
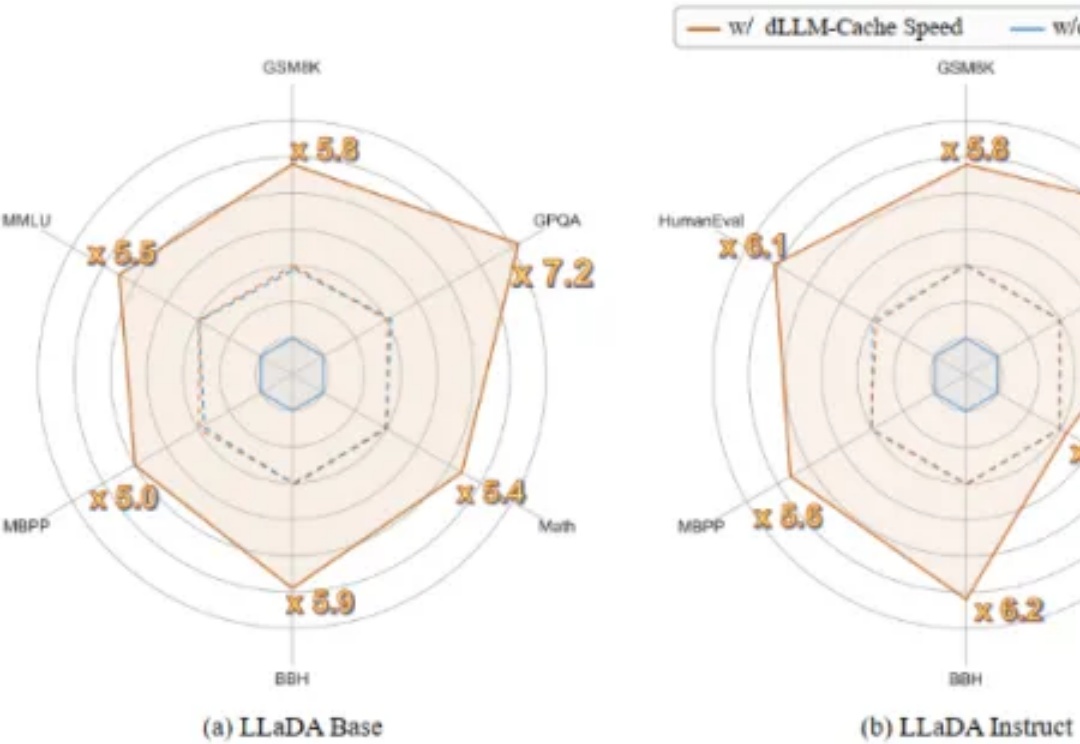
首个用于加速扩散式大语言模型(diffusion-based Large Language Models, 简称 dLLMs)推理过程的免训练方法。

作为首批入选印度“IndiaAI Mission”国家级项目、承担构建印度主权基础大模型任务的公司之一,Sarvam AI 近日发布了名为 Sarvam-M 的模型。这是一个基于 Mistral Small 构建的 240 亿参数、权重开放的混合语言模型。
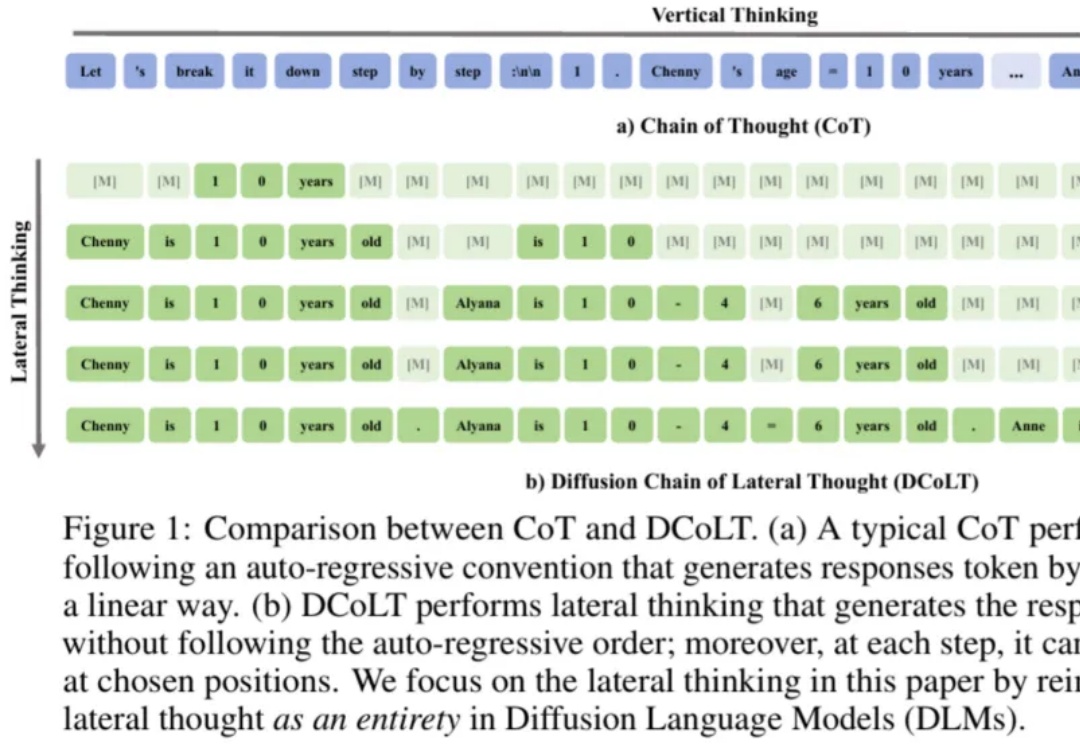
近年来,思维链在大模型训练和推理中愈发重要。近日,西湖大学 MAPLE 实验室齐国君教授团队首次提出扩散式「发散思维链」—— 一种面向扩散语言模型的新型大模型推理范式。该方法将反向扩散过程中的每一步中间结果都看作大模型的一个「思考」步骤,然后利用基于结果的强化学习去优化整个生成轨迹,最大化模型最终答案的正确率。
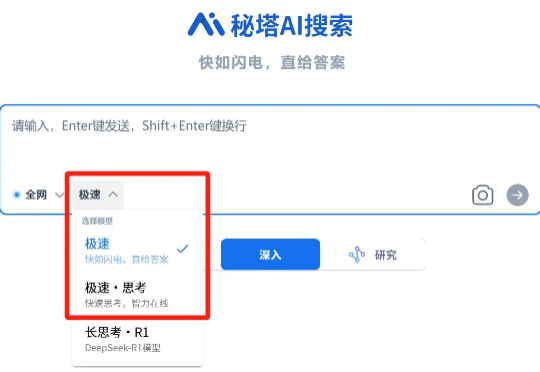
是的,秘塔AI搜索推出了全新“极速”模型。通过在GPU上进行kernel fusion,以及在CPU上进行动态编译优化,我们在单张H800 GPU上实现了最高400 tokens/秒的响应速度,大部分问题2秒内就能答完。
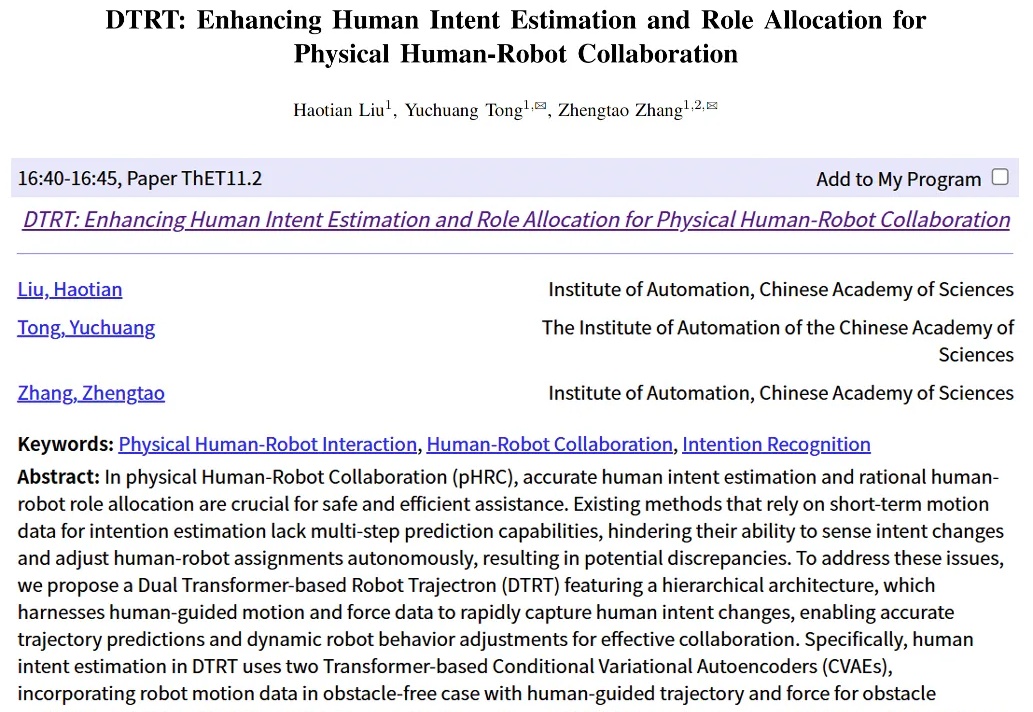
近日,机器人与自动化领域全球顶会 ICRA 2025 在美国亚特兰大开幕。
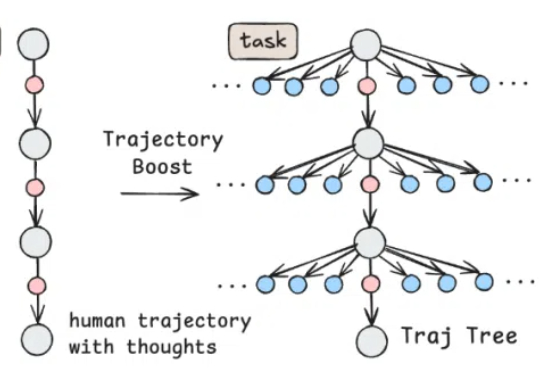
自 Anthropic 推出 Claude Computer Use,打响电脑智能体(Computer Use Agent)的第一枪后,OpenAI 也相继推出 Operator,用强化学习(RL)算法把电脑智能体的能力推向新高,引发全球范围广泛关注。