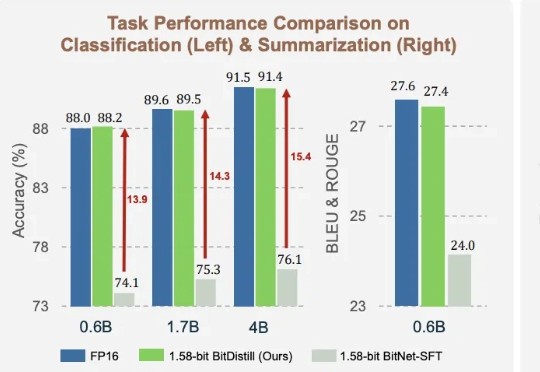
1.58bit不输FP16!微软推出全新模型蒸馏框架,作者全是华人
1.58bit不输FP16!微软推出全新模型蒸馏框架,作者全是华人1.58bit量化,内存仅需1/10,但表现不输FP16? 微软最新推出的蒸馏框架BitNet Distillation(简称BitDistill),实现了几乎无性能损失的模型量化。
来自主题: AI技术研报
7920 点击 2025-10-20 14:35

 搜索
1.58bit量化,内存仅需1/10,但表现不输FP16? 微软最新推出的蒸馏框架BitNet Distillation(简称BitDistill),实现了几乎无性能损失的模型量化。
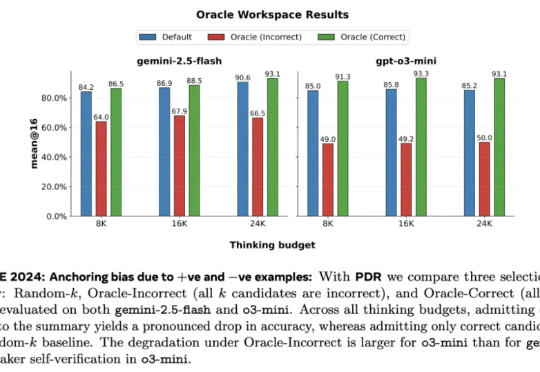
Meta 超级智能实验室、伦敦大学学院、Mila、Anthropic 等机构的研究者进行了探索。从抽象层面来看,他们将 LLM 视为其「思维」的改进操作符,实现一系列可能的策略。研究者探究了一种推理方法家族 —— 并行 - 蒸馏 - 精炼(Parallel-Distill-Refine, PDR),
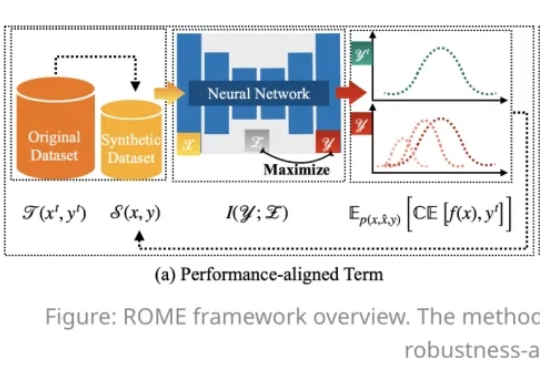
在人工智能模型规模持续扩大的今天,数据集蒸馏(Dataset Distillation,DD)方法能够通过使用更少的数据,达到接近完整数据的训练效果,提升模型训练效率,降低训练成本。
数学题, 一直是检验 AI 实力的 “硬核考场” —— 公式推导、逻辑链条、抽象思维缺一不可 。最近,我好了几天时间对国内外 7 款大厂模型展开了一场 “数学高考 ”,用阿里全球数学竞赛 + 中国奥赛真题实测它们的智商上限。
TimeDistill通过知识蒸馏,将复杂模型(如Transformer和CNN)的预测能力迁移到轻量级的MLP模型中,专注于提取多尺度和多周期模式,显著提升MLP的预测精度,同时保持高效计算能力,为时序预测提供了一种高效且精准的解决方案。
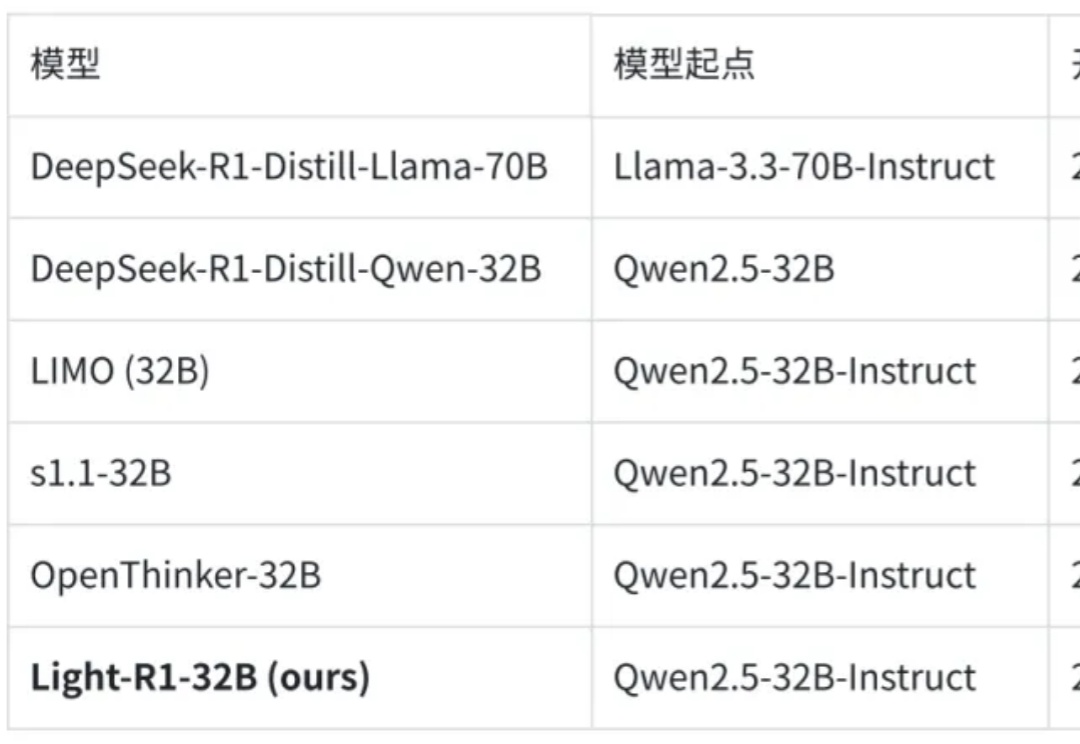
2025 年 3 月 4 日,360 智脑开源了 Light-R1-32B 模型,以及全部训练数据、代码。仅需 12 台 H800 上 6 小时即可训练完成,从没有长思维链的 Qwen2.5-32B-Instruct 出发,仅使用 7 万条数学数据训练,得到 Light-R1-32B
单目深度估计新成果来了!西湖大学AGI实验室等提出了一种创新性的蒸馏算法,成功整合了多个开源单目深度估计模型的优势。在仅使用2万张无标签数据的情况下,该方法显著提升了估计精度,并刷新了单目深度估计的最新SOTA性能。
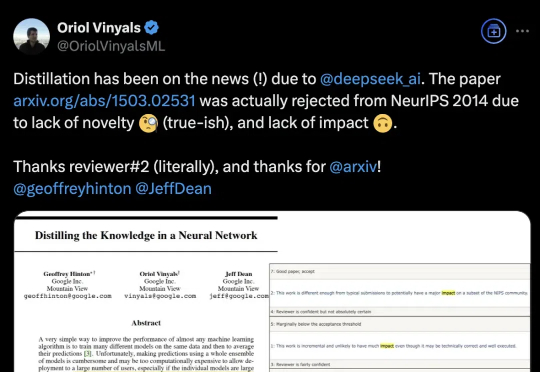
DeepSeek带火知识蒸馏,原作者现身爆料:原来一开始就不受待见。称得上是“蒸馏圣经”、由Hinton、Oriol Vinyals、Jeff Dean三位大佬合写的《Distilling the Knowledge in a Neural Network》,当年被NeurIPS 2014拒收。
自回归训练方式已经成为了大语言模型(LLMs)训练的标准模式, 今天介绍一篇来自阿联酋世界第一所人工智能大学MBZUAI的VILA实验室和CMU计算机系合作的论文,题为《FBI-LLM: Scaling Up Fully Binarized LLMs from Scratch via Autoregressive Distillation》
早在 2020 年,陶大程团队就发布了《Knowledge Distillation: A Survey》,详细介绍了知识蒸馏在深度学习中的应用,主要用于模型压缩和加速。随着大语言模型的出现,知识蒸馏的作用范围不断扩大,逐渐扩展到了用于提升小模型的性能以及模型的自我提升。