MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
来自主题: AI资讯
8337 点击 2026-10-03 10:30

 搜索
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
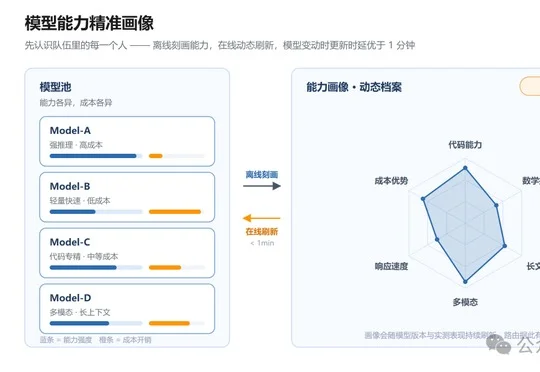
不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
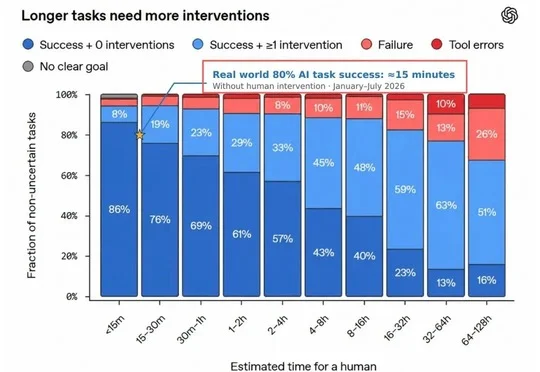
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。
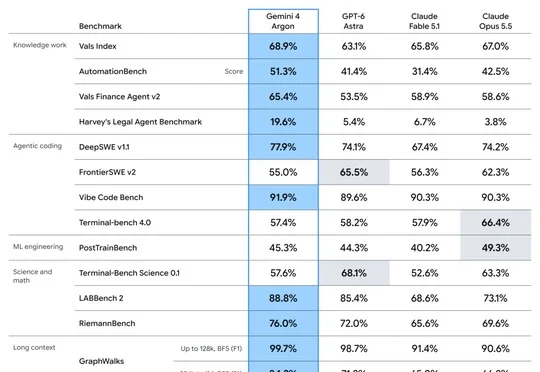
机器之心编辑部 刚刚,Google 宣布推出新一代前沿模型 Gemini 4 Argon。 Google 将 Argon 定位为面向复杂、长周期工作流的模型,重点覆盖软件工程、法律与金融等企业知识工作
北京AI基础设施公司九章云极向港交所递交上市申请,2025年收入同比增长177.7%达10.98亿元,累计交付超31000 PFLOPS算力,正推进Token工厂战略。
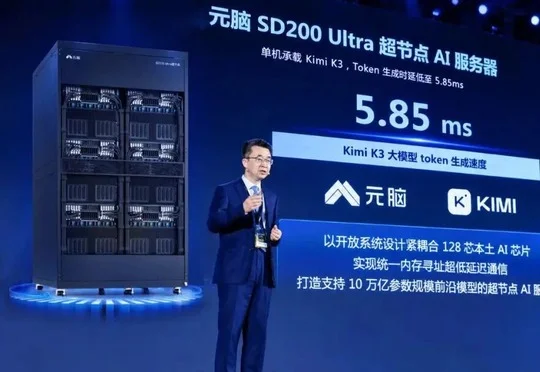
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
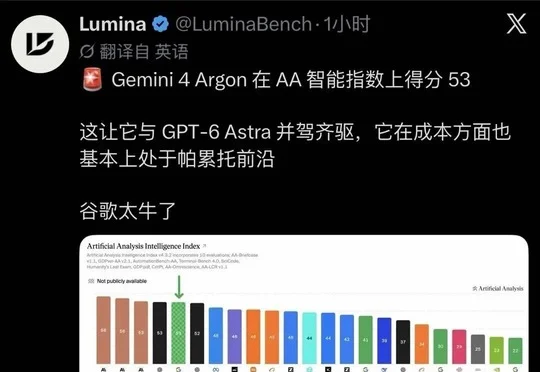
谷歌正式发布前沿AI模型Gemini 4 Argon,其在Text Arena排名第一、Vals RSI指数超越GPT-6 Astra达30%,单任务成本仅1.99美元,单次输出上限升至100万Token,并在谷歌内部以Rust安全语言重写了80万行系统内核代码。
IDC与浪潮信息联合发布的《2026年中国人工智能计算力发展评估报告》显示,全球活跃企业Agent数量预计将从2026年的7940万个增长至2030年的22.16亿个,带动Token消耗和算力需求爆发式增长,AI基础设施正围绕Agent长链路运行进行系统性重构。
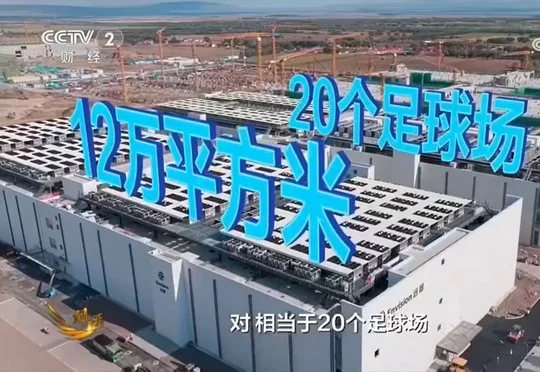
远景科技集团创始人张雷在央视《对话》节目中提出"AI土豆论",指出从绿电到普惠Token需闯破误区、建预测、提效率、可复制四道系统关,相关方案已在总规划容量超2GW的远景乌兰察布星河基地首次落地。
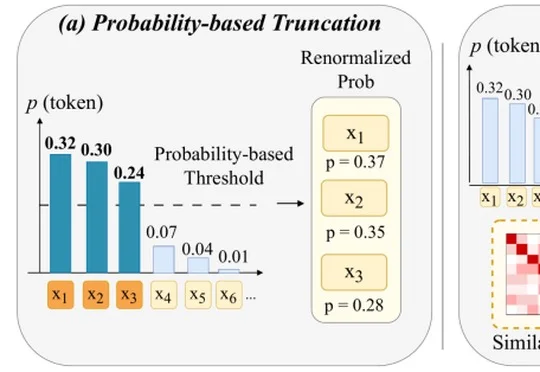
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。