Writing-Zero: 打破 AI 写作天花板, 让 AI 写作更像"人"
Writing-Zero: 打破 AI 写作天花板, 让 AI 写作更像"人"近年来, 大语言模型 (LLM) 在数学、编程等 "有标准答案" 的任务上取得了突破性进展, 这背后离不开 "可验证奖励" (Reinforcement Learning with Verifiable Rewards, RLVR) 技术的加持。RLVR 依赖于参考信号, 即通过客观标准答案来验证模型响应的可靠性。
搜索
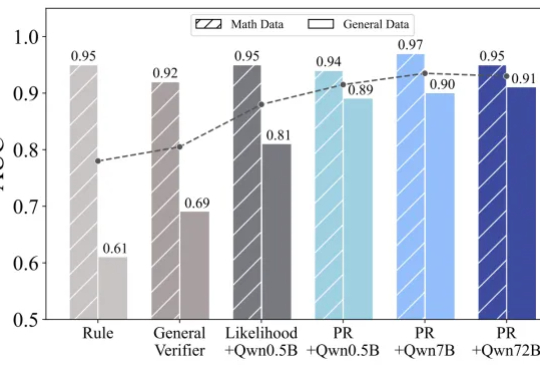
近年来, 大语言模型 (LLM) 在数学、编程等 "有标准答案" 的任务上取得了突破性进展, 这背后离不开 "可验证奖励" (Reinforcement Learning with Verifiable Rewards, RLVR) 技术的加持。RLVR 依赖于参考信号, 即通过客观标准答案来验证模型响应的可靠性。
2025年7月21日,斯坦福大学学习加速器(Stanford Accelerator for Learning)发布名为《AI+学习差异:设计无边界的未来》(AI+ Learning Differences: Designing a Future with No Boundaries)白皮书,强调AI可以成为支持有学习差异的学生的有力工具,但前提是其开发要以他们的需求和意见为核心。
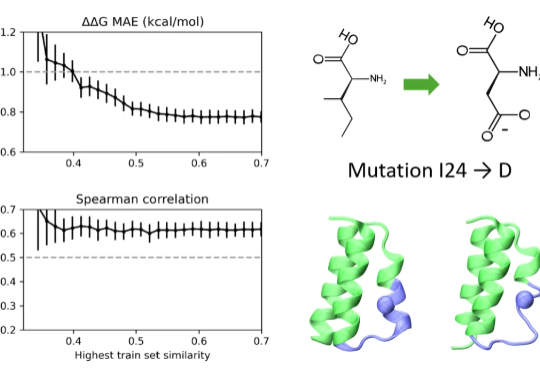
7 月 10 日,微软研究院 AI for Science 团队在《Science》杂志发表了题为「Scalable emulation of protein equilibrium ensembles with generative deep learning」的研究成果。
Deepseek 的 R1、OpenAI 的 o1/o3 等推理模型的出色表现充分展现了 RLVR(Reinforcement Learning with Verifiable Reward
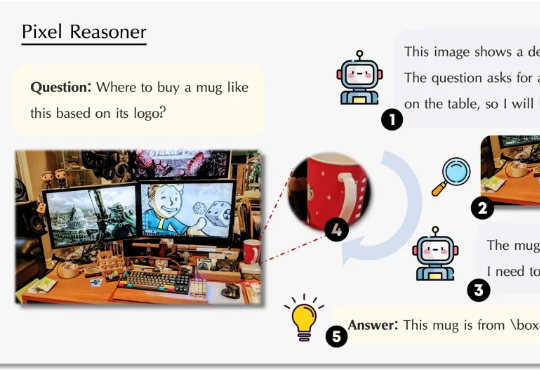
视觉语言模型(VLM)正经历从「感知」到「认知」的关键跃迁。 当OpenAI的o3系列通过「图像思维」(Thinking with Images)让模型学会缩放、标记视觉区域时,我们看到了多模态交互的全新可能。
在人类的认知过程中,视觉思维(Visual Thinking)扮演着不可替代的核心角色,这一现象贯穿于各个专业领域和日常生活的方方面面。
2025年上半年,Agent成为大模型领域讨论最多的主题之一。
搅起波澜的 flowith 是个目前只有 10 人的年轻团队。生于 1996 年的创始人 Derek(倪正民)已是团队里最年长的;另外一位创始人 Zion( 吴熠宸)生于 1998 年;最年轻的成员则是 00 后。
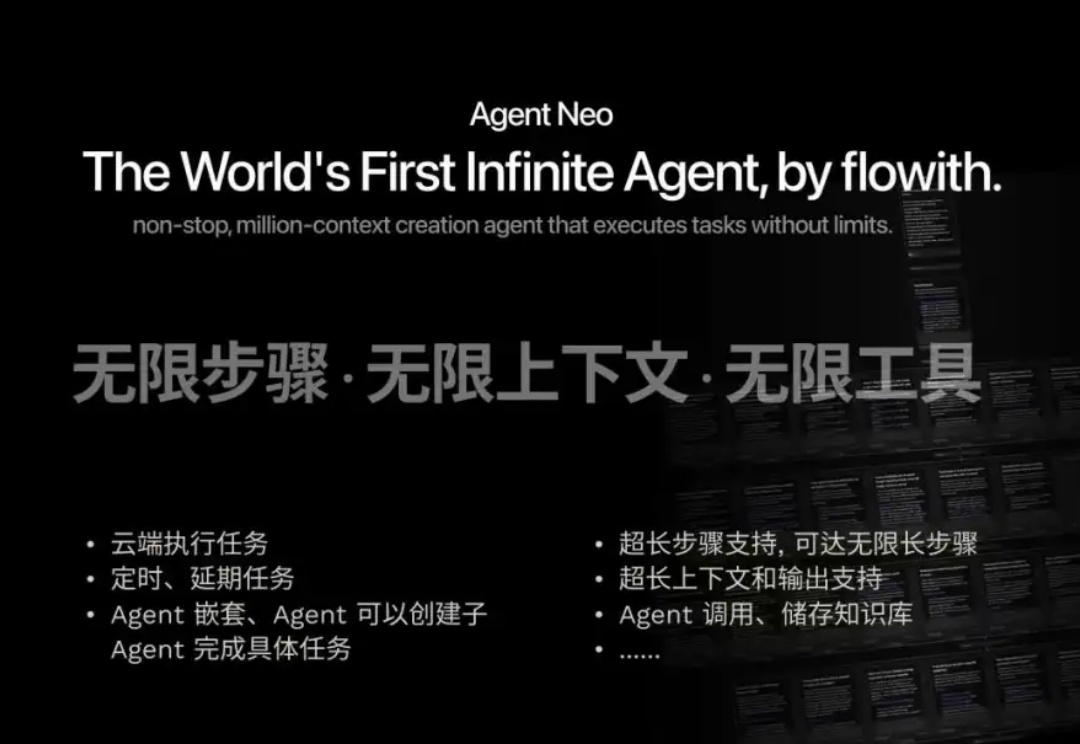
Flowith 发布了它们最新的 Agent,Neo,这是世界上第一个能够做到无限上下文,无限推理步骤的 Agent,并且它还拥有着无限输出的能力。
AI不再相信人类 关于 Agent, flowith 给出了自己的答案 —— Neo