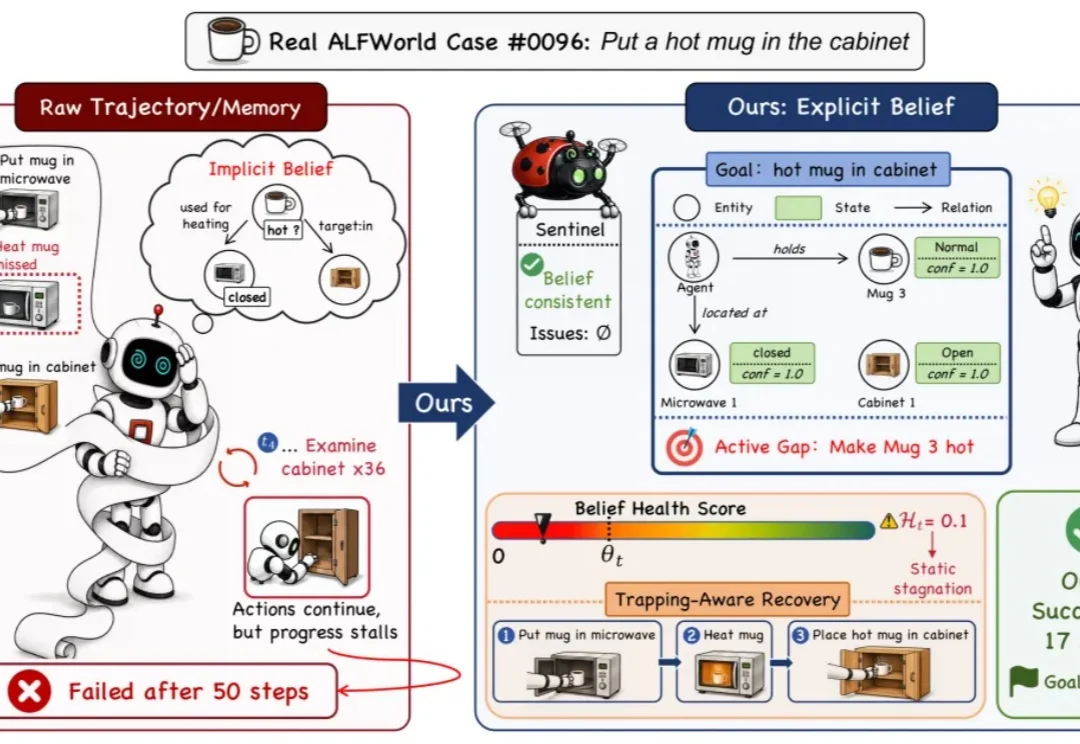
Agent一直在行动,任务为何没有进展?PoS识别并打破Belief Trapping
Agent一直在行动,任务为何没有进展?PoS识别并打破Belief Trapping任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
来自主题: AI技术研报
7663 点击 2026-10-14 11:17

 搜索
任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
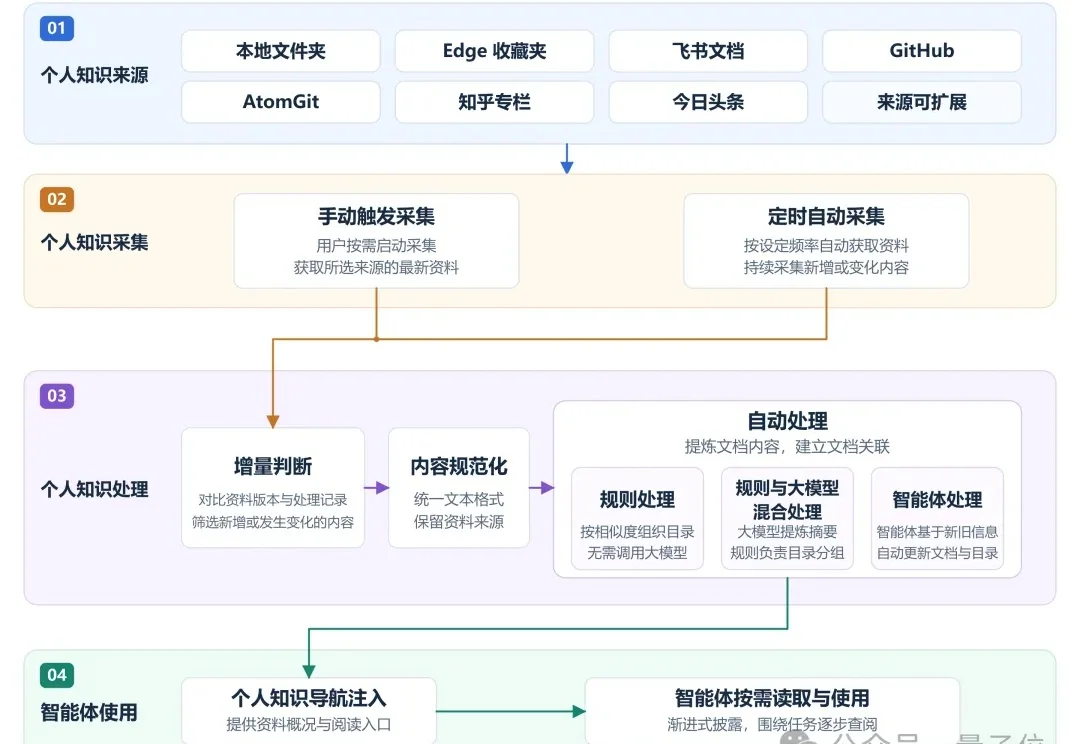
让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
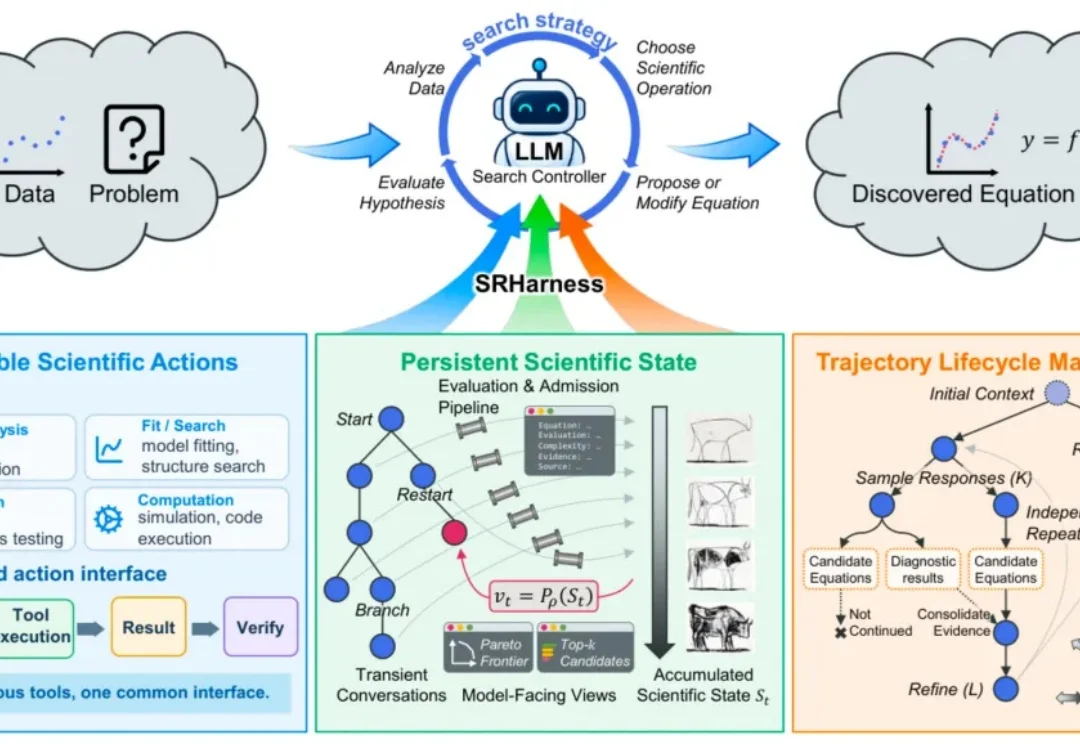
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
最近,我和朋友们共识了一件事:这波 Personal Agent 浪里,最值得用的就是 Grok Bot。
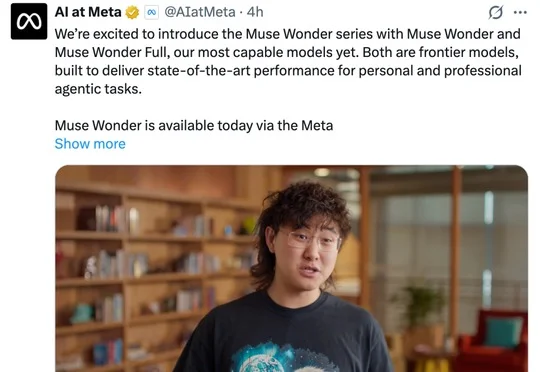
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
国庆前,海外各家大厂的Personal Agent产品下饺子一样出现。
A2A 商业马拉松,刚开跑。
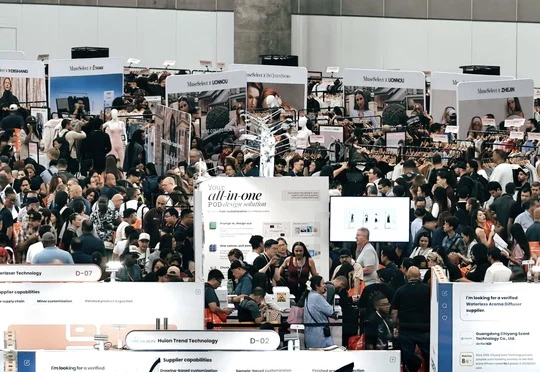
阿里国际站总裁张阔表示,模型榜单成绩提升未同步转化为电商任务体验,他将Agent竞争力概括为Model×Harness×Context,Accio Work基于107项开源电商任务的评测显示,前沿模型无人干预通过率仅约61%。
腾讯的Personal Agent产品要来了。
近期,全球顶尖 AI 实验室正在密集释放一个信号:AI 正在从帮助人类完成任务,走向参与自身的研发与改进。