DeepSeek没有“小”更新|实测DeepSeek新模型“许愿式编程”
DeepSeek没有“小”更新|实测DeepSeek新模型“许愿式编程”永远不要相信 DeepSeek 的 “a minor update” (小更新)。
来自主题: AI产品测评
9067 点击 2026-10-20 11:55

 搜索
永远不要相信 DeepSeek 的 “a minor update” (小更新)。
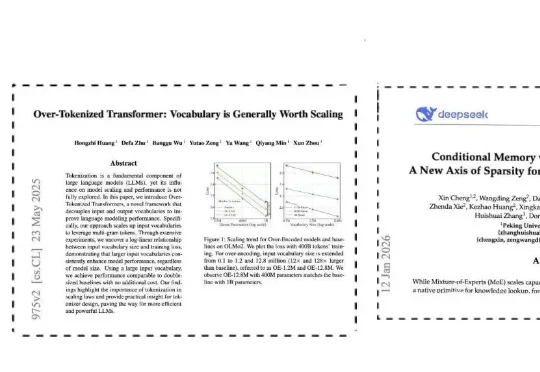
第一篇论文来自字节SEED团队, 打了一些基础; 《Over-Tokenized Transformer》。 论文标题看上去在讨论“过度分词”。 而重点必然是在第二篇上—— DeepSeek公司的学术成果Engram。 《Conditional Memory via Scalable Lookup》 也就是Engram模块所出处的论文。
DeepSeek最新开源的模型,已经被硅谷夸疯了!
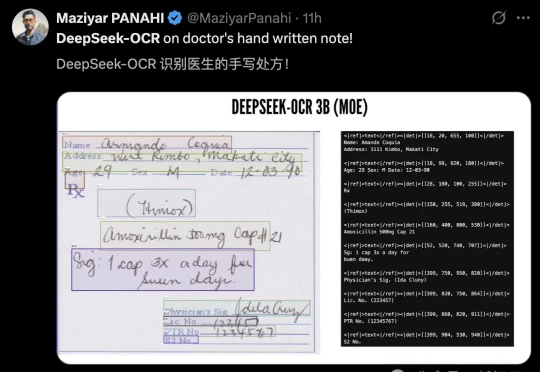
AI新突破!DeepSeek-OCR以像素处理文本,压缩率小于1/10,基准测试领跑。开源一夜4.4k星,Karpathy技痒难耐,展望视觉输入的通用性。
刚发V3.1“最终版”,DeepSeek最新模型又来了!DeepSeek-V3.2-Exp刚刚官宣上线,不仅引入了新的注意力机制——DeepSeek Sparse Attention。还开源了更高效的TileLang版本GPU算子!
自从 GPT-5 发布后,DeepSeek 创始人梁文锋就成了 AI 圈最「忙」的人。
时隔不到一个月,DeepSeek又一次震动全球AI圈。去年 12 月,DeepSeek推出的DeepSeek-V3在全球AI领域掀起了巨大的波澜,它以极低的训练成本,实现了与GPT-4o和Claude Sonnet 3.5等顶尖模型相媲美的性能,震惊了业界。
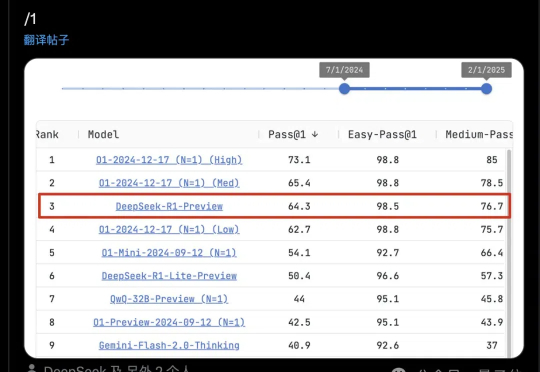
DeepSeek版o1,有消息了。还未正式发布,已在代码基准测试LiveCodeBench霸榜前三,表现与OpenAI o1的中档推理设置相当。注意了,这不是在DeepSeek官方App已经能试玩的DeepSeek-R1-Lite-Preview(轻量预览版)。
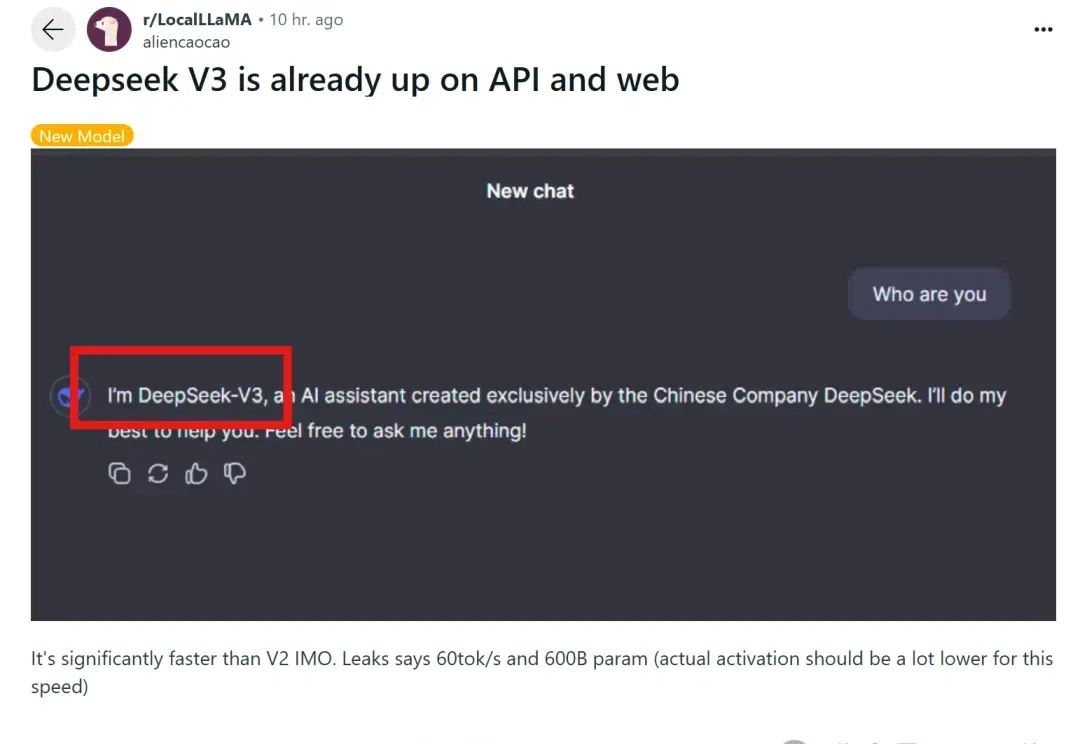
还没等到官宣,Deepseek-v3竟意外曝光了?!