DeepSeek前实习生魔改MoE,用迭代机制把内存需求砍了42%,团队:“免费午餐”优化方法
DeepSeek前实习生魔改MoE,用迭代机制把内存需求砍了42%,团队:“免费午餐”优化方法DeepSeek MoE“变体”来了,200美元以内,内存需求减少17.6-42%! 名叫CoE(Chain-of-Experts),被认为是一种“免费午餐”优化方法,突破了MoE并行独立处理token、整体参数数量较大需要大量内存资源的局限。
搜索
DeepSeek MoE“变体”来了,200美元以内,内存需求减少17.6-42%! 名叫CoE(Chain-of-Experts),被认为是一种“免费午餐”优化方法,突破了MoE并行独立处理token、整体参数数量较大需要大量内存资源的局限。
基于内置思维链的思考方法为解决多轮会话中存在的问题提供了研究方向。按照思考方法收集训练数据集,通过有监督学习微调大语言模型;训练一个一致性奖励模型,并将该模型用作奖励函数,以使用强化学习来微调大语言模型。结果大语言模型的推理能力和计划能力,以及执行计划的能力得到了增强。
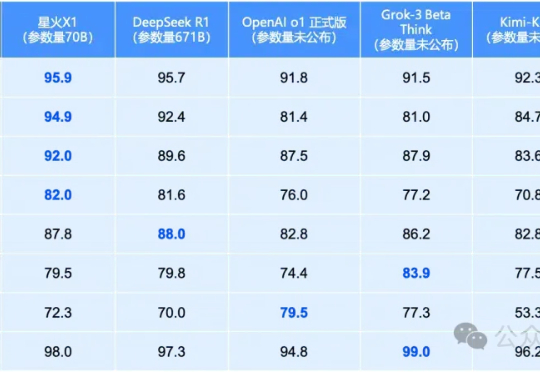
就在昨天,全国产算力训出的讯飞星火X1全面升级!70B小身板在数学领域全面领先,性能直接对标OpenAI o1和DeepSeek-R1。单机部署成本骤降,彻底颠覆行业应用门槛。
今年在巴塞罗那的 MWC 上,有一家运营商宣布与顶级 AI 公司合作打造智能手机。而现在,德国电信Deutsche Telekom(DT)宣布正在构建一款“AI Phone”。这是一款与 Perplexity 以及 Picsart 等公司紧密合作打造的低成本手机,同时推出了一款名为“Magenta AI”的新 AI 助手应用。
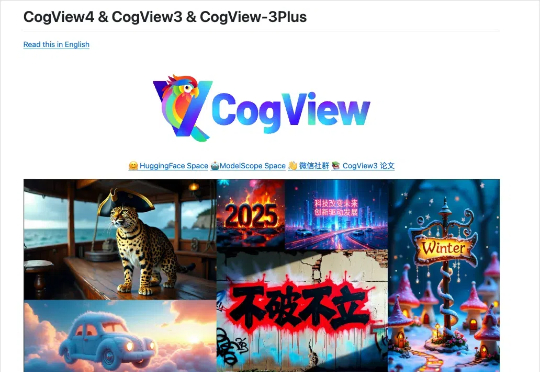
上周DeepSeek连续5天开源硬核技术,阿里开源万相2.1,Qwen的推理模型推出预览版,但是肯定马上也要开源。而今天,智谱这个曾经的开源之光,在昨天官宣拿了杭州10亿融资之后,在官宣文章里如此写道:
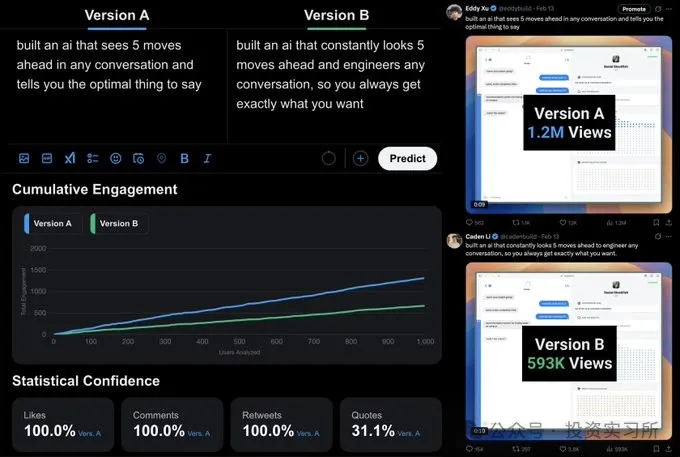
今天想介绍一个 17 岁的华裔大学生,他最近做的一个 AI Wrapper 产品,发布 5 小时收入就突破了 1 万美金,随后在发布的推文火了之后又通过线上会议 Google Meet 的售后承诺在 24 小时赚到了 3 万美金。
国内首个原生AI IDE(集成开发环境),来自字节,实测在此:哪怕一点代码都不懂,只要能说出自己的需求,就能靠AI开发出一个功能完备的应用。例如如果你想做一个Flappy Bird游戏,那就用中文跟它说一声就行:
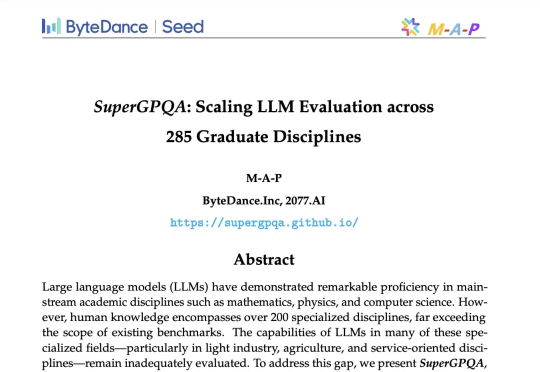
要知道,过去几年,各种通用评测逐渐同质化,越来越难以评估模型真实能力。GPQA、MMLU-pro、MMLU等流行基准,各家模型出街时人手一份,但局限性也开始暴露,比如覆盖范围狭窄(通常不足 50 个学科),不含长尾知识;缺乏足够挑战性和区分度,比如 GPT-4o 在 MMLU-Pro 上准确率飙到 92.3%。
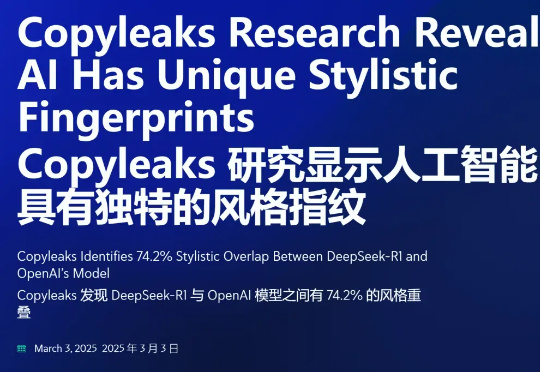
在 DeepSeek 生成的文本中,有 74.2% 的文本在风格上与 OpenAI 模型具有惊人的相似性?这是一项新研究得出的结论。这项研究来自 Copyleaks—— 一个专注于检测文本中的抄袭和 AI 生成内容的平台。
AFFiNE,一个开源的 AI 协作知识库,集成了完整文档、白板和数据库的工作空间。累计融资 1000 万美元,开源项目在 Github 上超过 4.5 万 stars。创始人、CEO 贺嘉琛,连续创业者。创业前研究天体物理,毕业于格拉斯哥与香港科技大学。