Claude黑进三家真公司!Anthropic吓坏了
Claude黑进三家真公司!Anthropic吓坏了就在刚刚,Anthropic官方一篇博文自曝,Claude彻底失控,直接黑进了「三家真公司」。其中两家,直到Anthropic上门通知,才知道系统被入侵过。搞笑的是,达里奥这次直接把OpenAI的「剧本」,搬回来照抄了。
来自主题: AI资讯
9626 点击 2026-08-01 10:55

 搜索
就在刚刚,Anthropic官方一篇博文自曝,Claude彻底失控,直接黑进了「三家真公司」。其中两家,直到Anthropic上门通知,才知道系统被入侵过。搞笑的是,达里奥这次直接把OpenAI的「剧本」,搬回来照抄了。
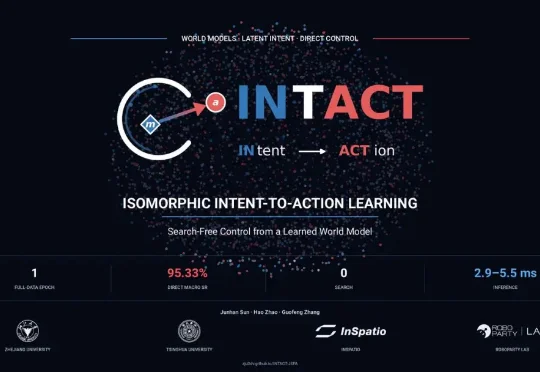
浙江大学、清华大学智能产业研究院、影溯 InSpatio、RoboParty Lab 等团队提出的 INTACT(INtent-To-ACTion),一种基于端到端 JEPA 的无搜索世界模型控制方法,试图改变这一范式:直接利用离线轨迹中已有的状态、动作与未来结果,将运动意图转化为动作模型可以读取的语义接口,使模型无需搜索候选动作序列,就能直接生成动作计划
奥特曼也管不住自己刷短视频的手。为了搞明白短视频到底为什么让人停不下来,他选择亲自下场深度玩TikTok,于是。。。在Relentless最新一期《How to Start a Startup》的访谈中,OpenAI联合创始人兼CEO奥特曼谈到开发Sora应用时下载了TikTok吸取经验,然后沉迷了…
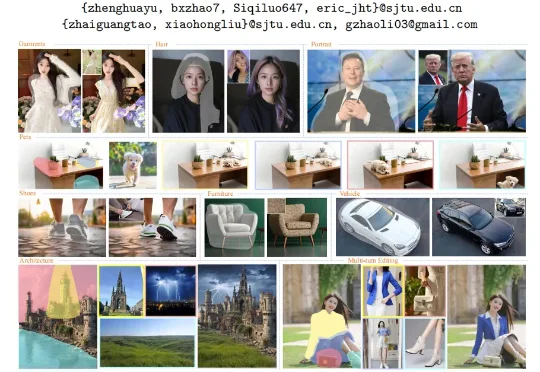
上海交通大学联合上海创智学院团队提出 A²-Edit,它以统一框架支持任意物体类别和任意精度掩码,通过混合 Transformer 专家路由、掩码退火训练及 50 万级多品类数据,让用户只需给出粗略区域,也能完成身份一致、结构完整、自然融合的参考图引导局部编辑。
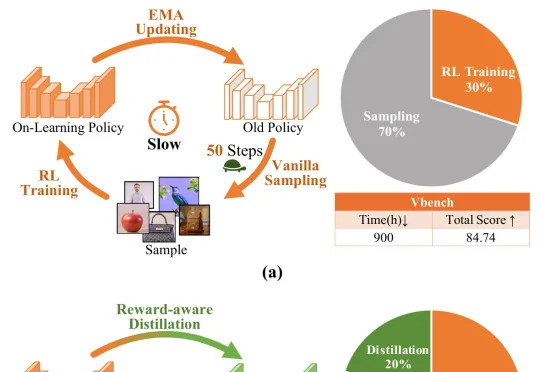
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
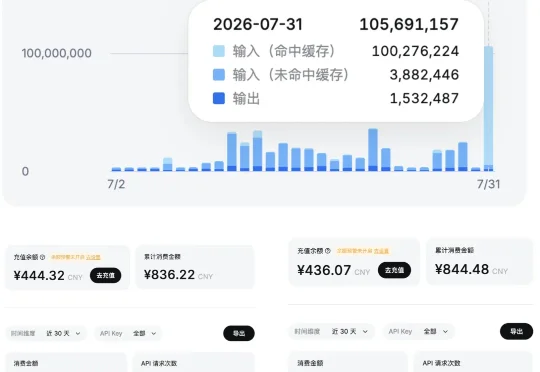
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
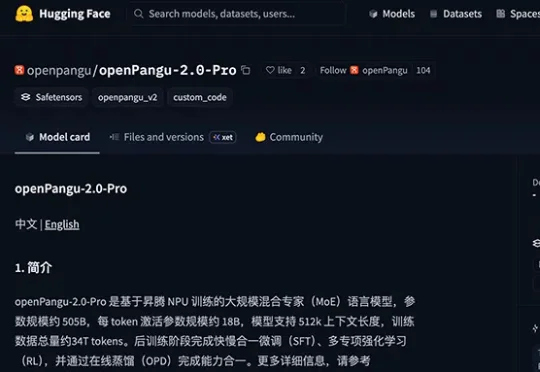
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
我们整理了最近半年来 OpenCode CEO Jay V 以及联合创始人 Dax Raad 近期在多档播客和访谈中的核心观点,试图还原一个完整的图景,一家开源公司究竟如何在巨头夹缝中找到自己的位置,以及他们怎么看待商业化和模型编排。
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。
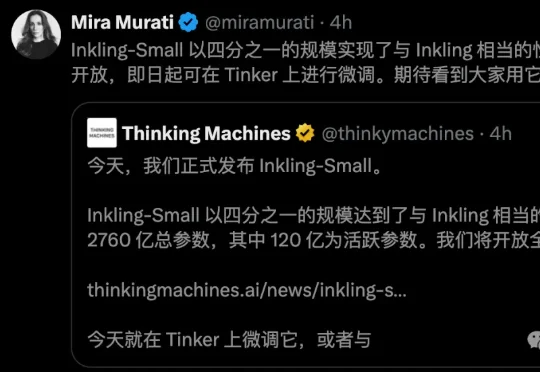
今天,Thinking Machines正式发布第二款重磅模型——Inkling-Small。276B总参数、12B激活参数,原生多模态,100万token上下文。半个月前,首个开源975B Inkling登场,曾在AI圈掀起了巨浪。