打通感知-理解-交互链路,全栈视频理解大模型VideoChat3开源了
打通感知-理解-交互链路,全栈视频理解大模型VideoChat3开源了视频是描述物理世界的重要数据形态,更是人类与物理世界交互的重要载体,视频理解大模型是让 AI 从数字世界走向物理世界最基础、最原生的组成部分。
来自主题: AI技术研报
8524 点击 2026-07-23 10:37

 搜索
视频是描述物理世界的重要数据形态,更是人类与物理世界交互的重要载体,视频理解大模型是让 AI 从数字世界走向物理世界最基础、最原生的组成部分。
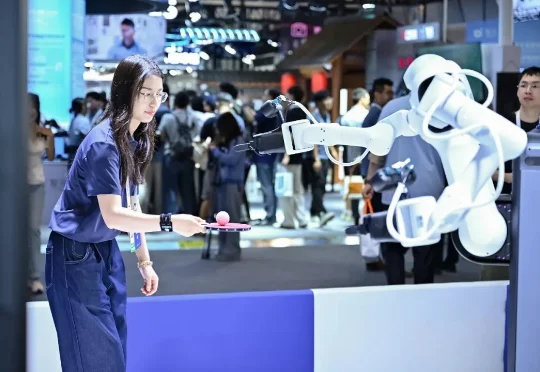
苏度科技联合创始人、董事长苏昊是ImageNet的核心作者之一,师从李飞飞。这家公司走了一条与硅谷主流“纯大脑黑盒大模型”不太一样的路:软硬件协同设计,上下分层架构,上层负责任务规划与环境理解,下层负责具体物体操作;Sim-to-Real作为核心训练范式,让机器人在虚拟世界里经历几百万年的进化,再迁移到现实。
这家初创公司已与Georgia Power 签订合同,为位于Effingham County的这一数据中心综合体锁定了3.2GW的电力供应,这一规模可能使该设施跻身OpenAI迄今为止最大的数据中心之列。预计从2028年起将有数百兆瓦电力投入使用,其余开发工作将持续到2032年。1GW的电力足以在任意时刻为约75万户美国家庭供电。
“AI教母”李飞飞创办的World Labs正式宣布收购美国机器人仿真初创公司SceniX。这笔交易是World Labs成立以来的首笔公开收购,也标志着这家以“空间智能”为旗帜的明星创企,正式将业务边界从3D世界生成推进到物理机器人训练领域。
刚刚,字节也坐不住了,推出了 Trae Work 官方知识库教程。我让 Agent 查了下,这个知识库目前大约有 46w 字,85 篇文档。 不得不说,不愧是字节,写文档还是很有一手的!
这家公司是Fireworks AI,按现在流行的话说,Fireworks AI是一家Token工厂。既不训练前沿大模型,也不做面向消费者的AI应用,只做推理,帮企业把开源模型微调好、托管好,然后按调用量收钱。今年GTC大会上,黄仁勋和Lin Qiao有场对谈,老黄直言,“In a lot of ways, you're the TSMC of AI factories.”
袁博地的答案是否定的。从清华大学接触计算机视觉,到 UC Berkeley 攻读 AI 博士,再到 Google X 负责机器人的视觉系统,袁博地过去十多年的研究几乎始终围绕 Pixel 展开:从图像识别,到 GAN、Diffusion,再到图像和视频生成,技术范式不断变化,研究对象却始终指向同一件事——如何让机器理解和生成视觉世界。
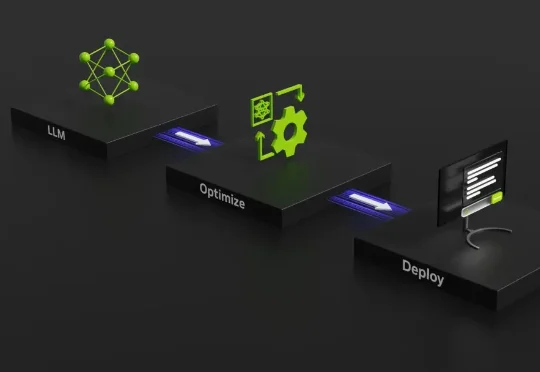
就在最近,英伟达亲自下场,发布了一篇名为《AI Model Co-Design: Hardware-Friendly LLM Design》的技术博客。整篇文章洋洋洒洒,其实就想点醒行业一件事:别光顾着堆算力了,来看看你们是怎么把顶级显卡逼成“磨洋工”的吧。
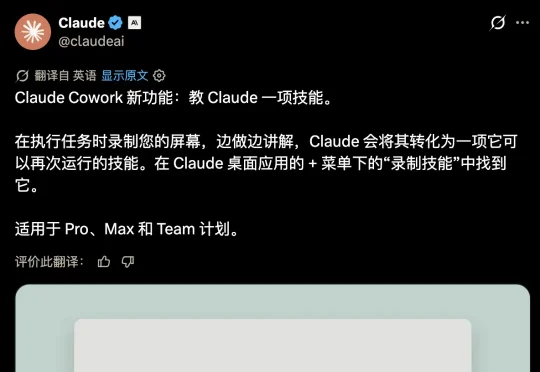
现在,你可以通过录屏 + 语音讲解的方式,彻底把自己蒸馏成 Skill 了。7 月 21 日,Anthropic 在 Claude 桌面端 Cowork 的 + 菜单里加了一项「Record a Skill」:录屏,一边操作一边用语音讲解,录完后 Claude 自动把演示转化成一个可复用的 Skill。
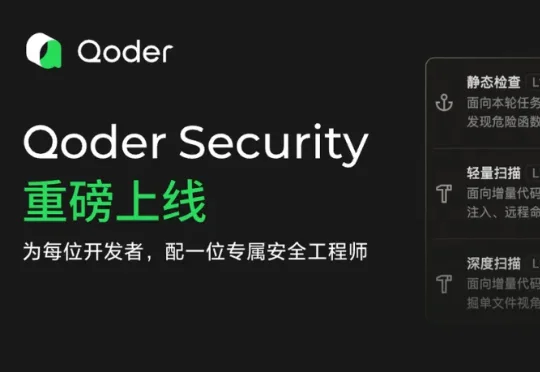
刚刚,阿里旗下的Qoder正式推出了Qoder Security,直击AI Coding的安全风险问题。在这个工具中,代码安全内生于 Qoder,贯穿从编码到提交的每一步。Qoder Security的发布,让Qoder成为国内首个交付「编码会话内三层安全护航 + 发现问题同会话修复」能力Agentic Coding产品。