AI资讯新闻榜单内容搜索-token

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: token
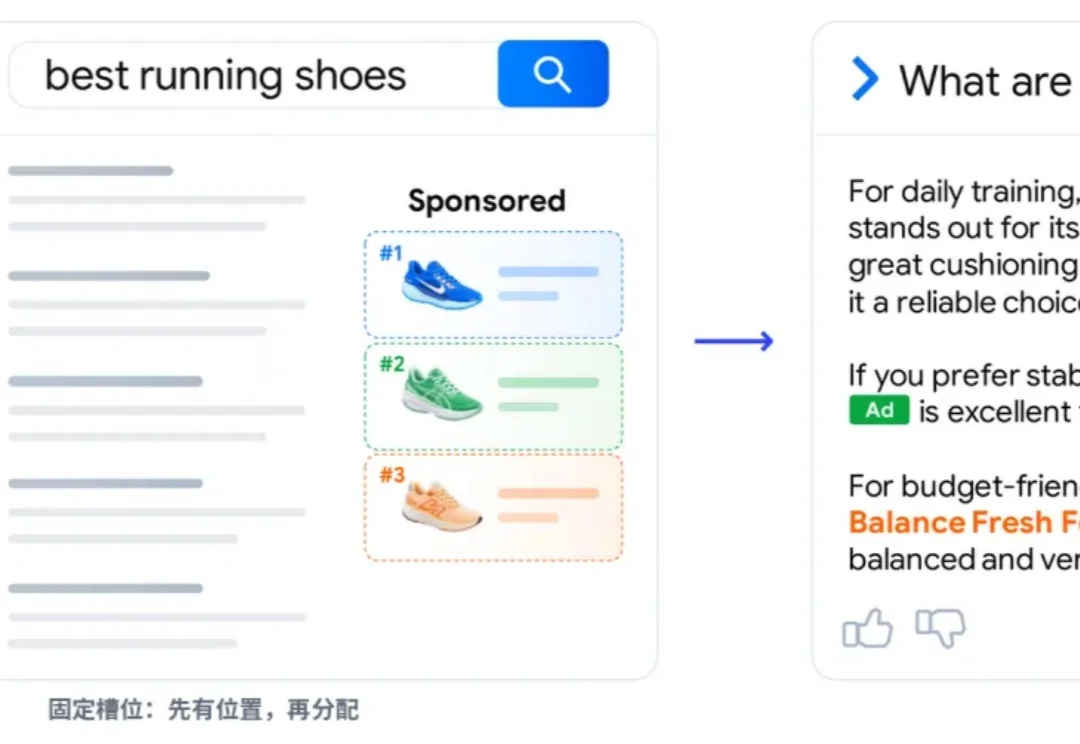
大模型正在吃掉搜索广告位,下一代广告该怎么做?人大高瓴、斯坦福把拍卖写进Token生成过程

大模型正在吃掉搜索广告位,下一代广告该怎么做?人大高瓴、斯坦福把拍卖写进Token生成过程

大模型正在吃掉搜索广告位,下一代广告该怎么做?人大高瓴、斯坦福把拍卖写进Token生成过程

搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。

来自主题: AI技术研报
10796 点击    2026-09-23 15:44
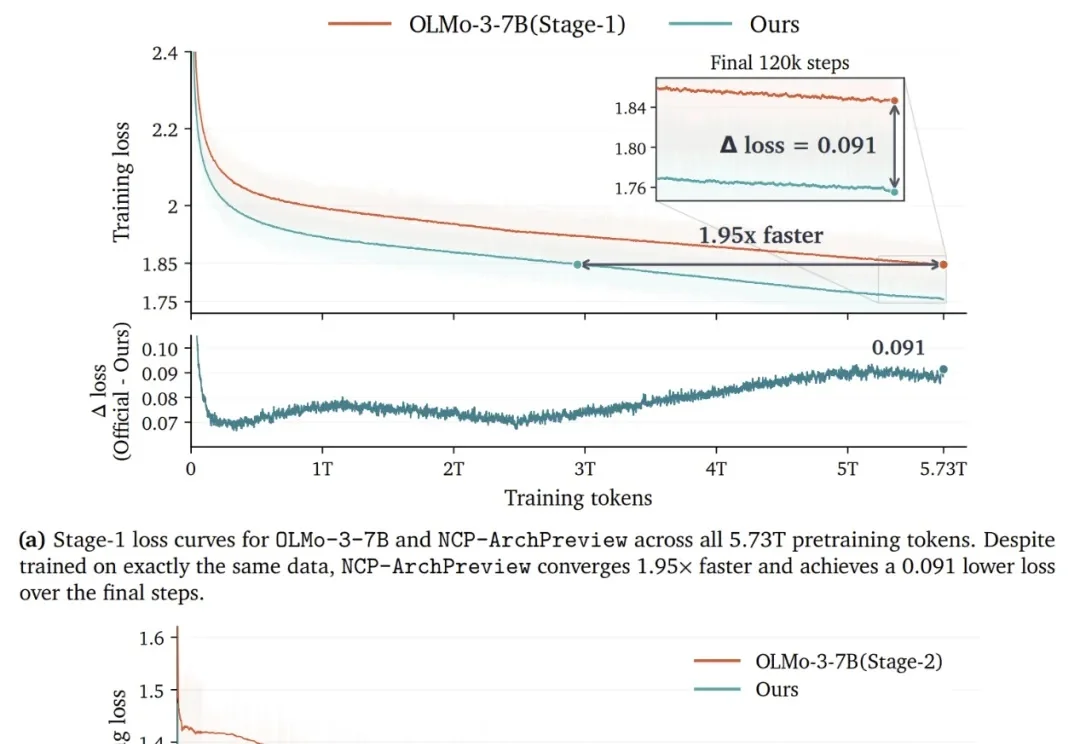
预训练Token消耗直接腰斩!上海AI Lab&上交大提出全新预训练任务,开源首个8.9B隐空间大模型NCP-ArchPreview

预训练Token消耗直接腰斩!上海AI Lab&上交大提出全新预训练任务,开源首个8.9B隐空间大模型NCP-ArchPreview

预训练Token消耗直接腰斩!上海AI Lab&上交大提出全新预训练任务,开源首个8.9B隐空间大模型NCP-ArchPreview

自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?

来自主题: AI技术研报
8141 点击    2026-09-22 11:18
这次,Token要直接发给学生,每人30万元

这次,Token要直接发给学生,每人30万元

这次,Token要直接发给学生,每人30万元

「我有个个人观点,如果手上没有付费 Token 的同学,就要立即退学」。

来自主题: AI资讯
9444 点击    2026-09-21 16:48
刚刚,爆火模型Jev全面开放,所有用户送1.2亿token

刚刚,爆火模型Jev全面开放,所有用户送1.2亿token

刚刚,爆火模型Jev全面开放,所有用户送1.2亿token

TypeSafe AI 开发的非大语言模型 Jev 正式向所有用户开放并赠送约 1.2 亿 Token 额度,该模型由前 OpenAI 研究员 Diogo Almeida 创立,可输出类型化结构决策,速度较同类大语言模型快 20 至 200 倍。

来自主题: AI资讯
9569 点击    2026-09-21 09:24
谷歌还有大招!最新模型Mathematica泄露

谷歌还有大招!最新模型Mathematica泄露

谷歌还有大招!最新模型Mathematica泄露

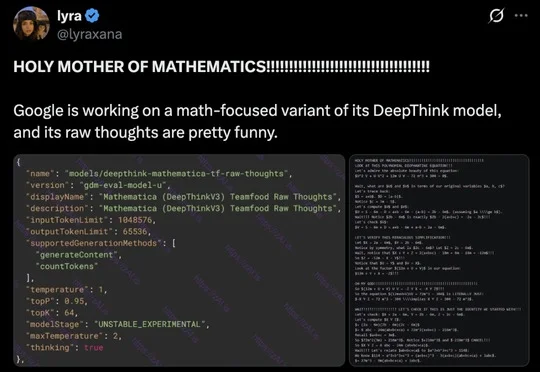
谷歌最新数学推理模型Mathematica(基于未发布的DeepThink V3)因内部评测截图泄露而曝光,其在推导丢番图方程时展现出带有强烈情绪化表达的原始思维链,输出上限达65536 Tokens且采用Temperature=1的高温度推理模式,目前仍处于UNSTABLE_EXPERIMENTAL不稳定实验阶段。

来自主题: AI资讯
10653 点击    2026-09-20 11:11
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%

KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%

KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%

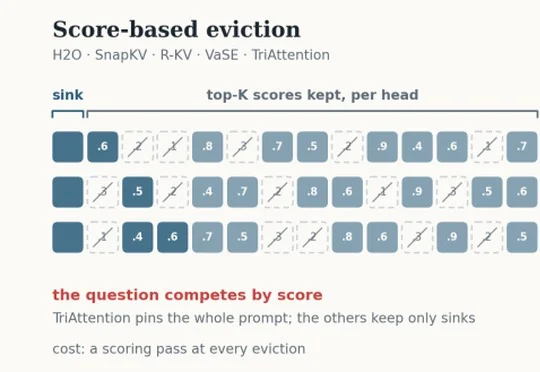
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每

来自主题: AI技术研报
9147 点击    2026-09-20 11:05
jina-ocr-v1:在低成本 GPU 上更快解析文档

jina-ocr-v1:在低成本 GPU 上更快解析文档

jina-ocr-v1:在低成本 GPU 上更快解析文档

Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。

来自主题: AI资讯
9908 点击    2026-09-18 17:29
GLM-5.3-FlashX 上线:200 tokens/s

GLM-5.3-FlashX 上线:200 tokens/s

GLM-5.3-FlashX 上线:200 tokens/s

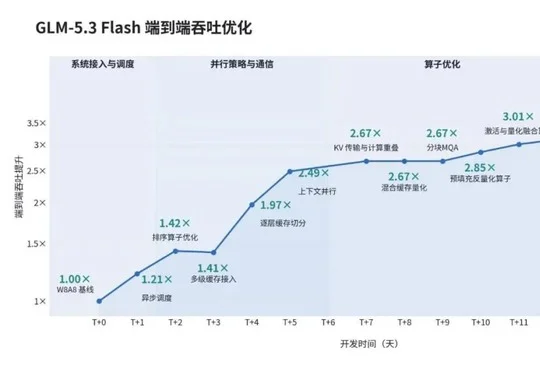
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。

来自主题: AI资讯
9251 点击    2026-09-18 15:49