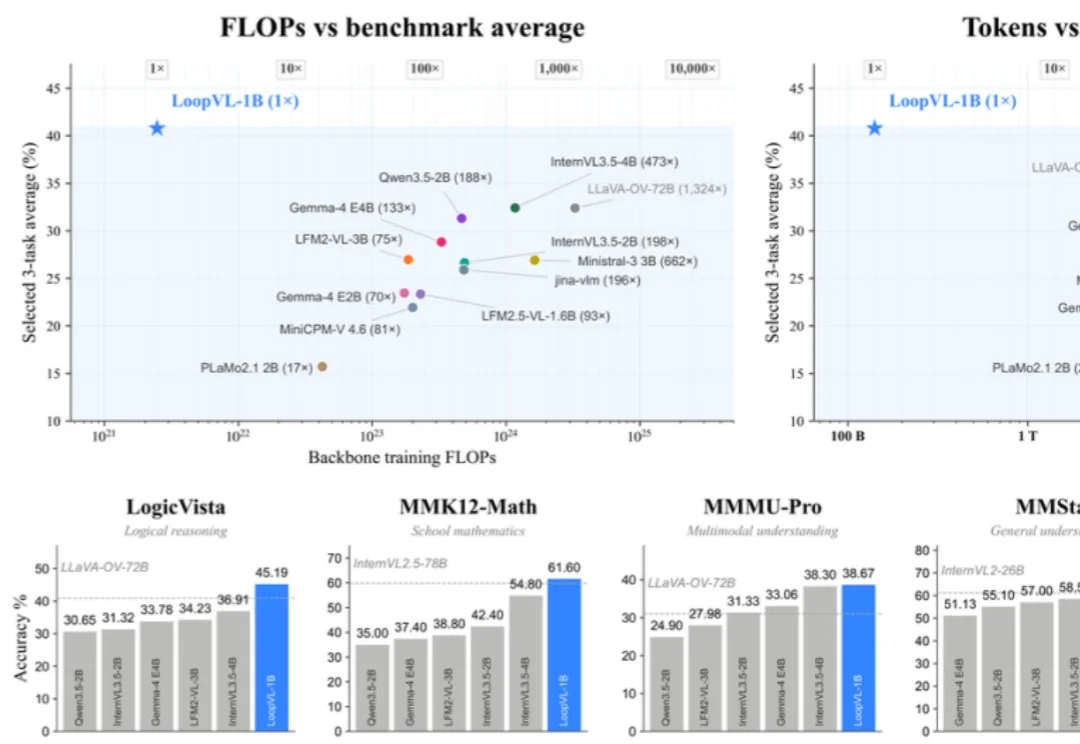
Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL
Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
来自主题: AI技术研报
8282 点击 2026-10-20 11:24

 搜索
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
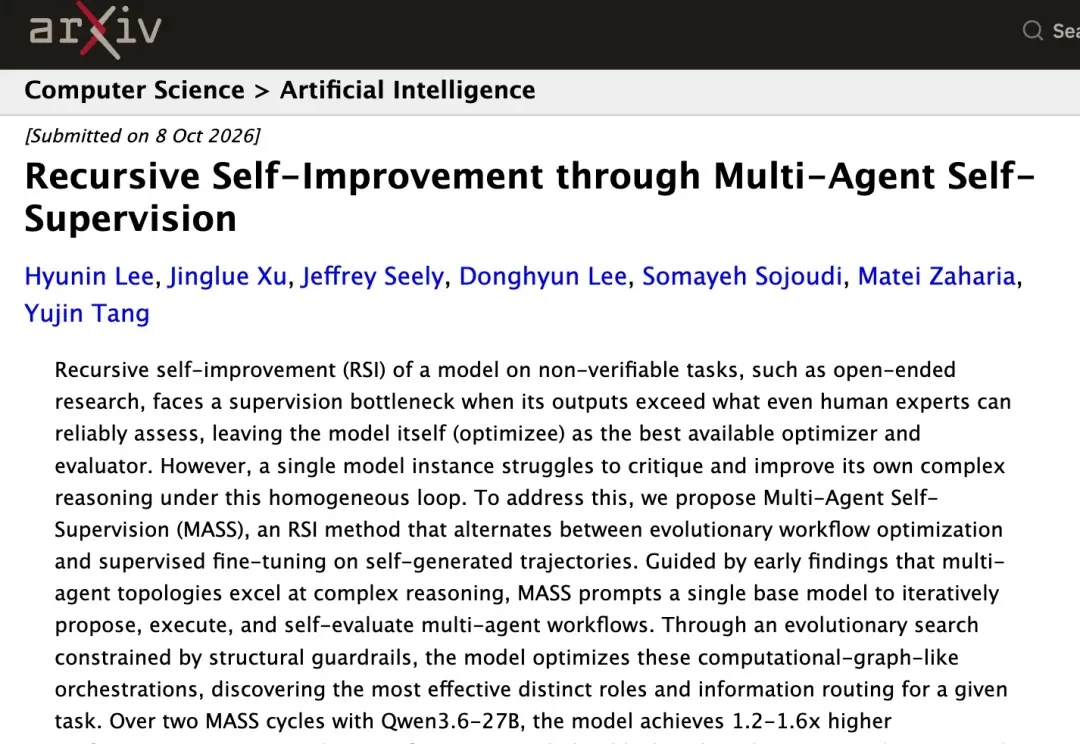
由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。
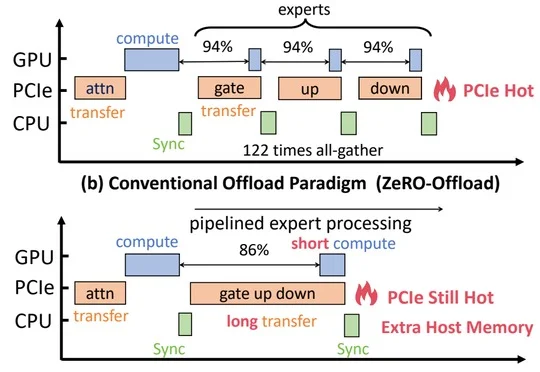
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
啥,DeepSeek又开始给机器人公司投钱了?!
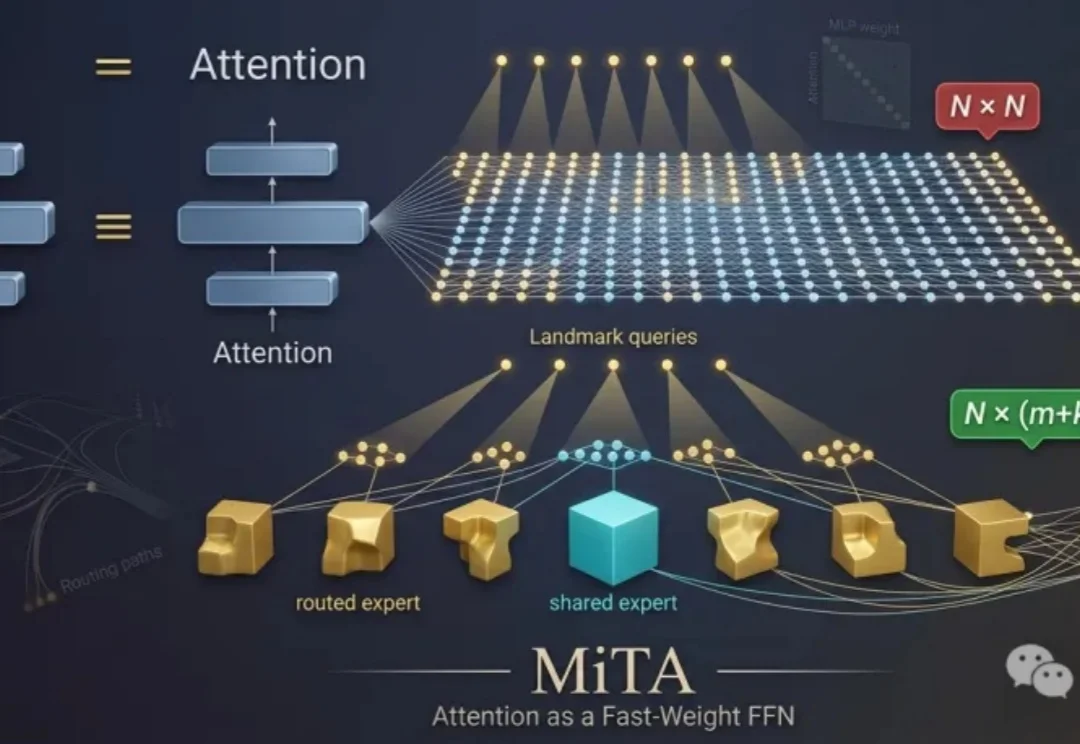
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
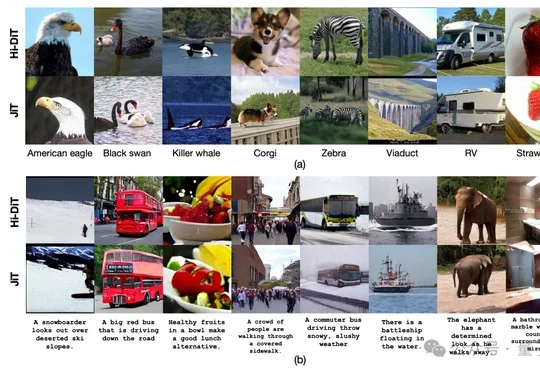
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
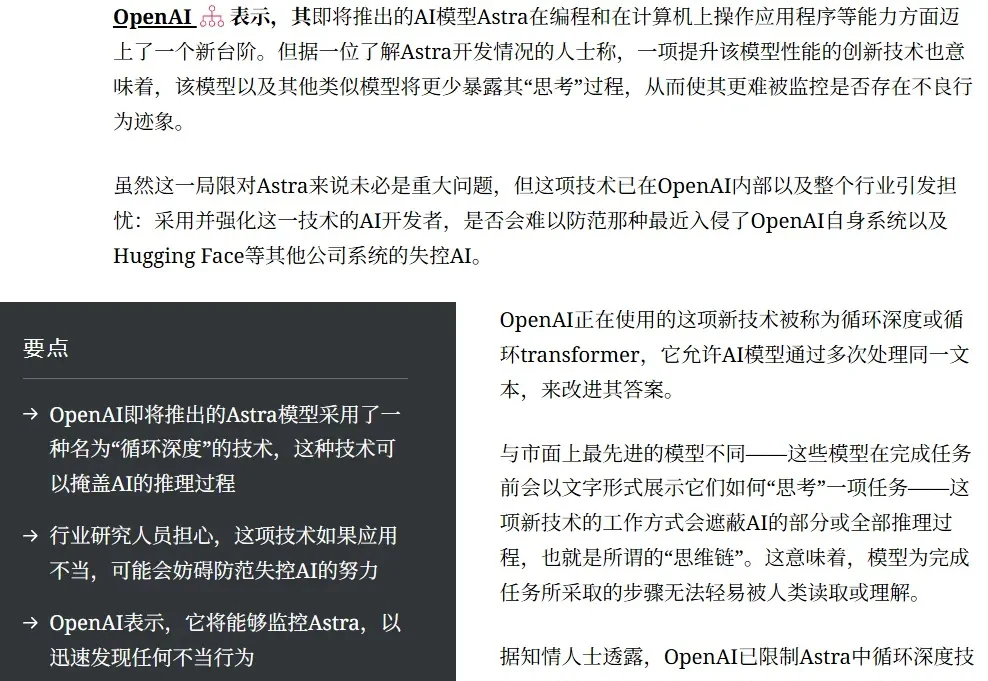
过去两周里,「循环深度」这个词变成了 AI 安全讨论的焦点。
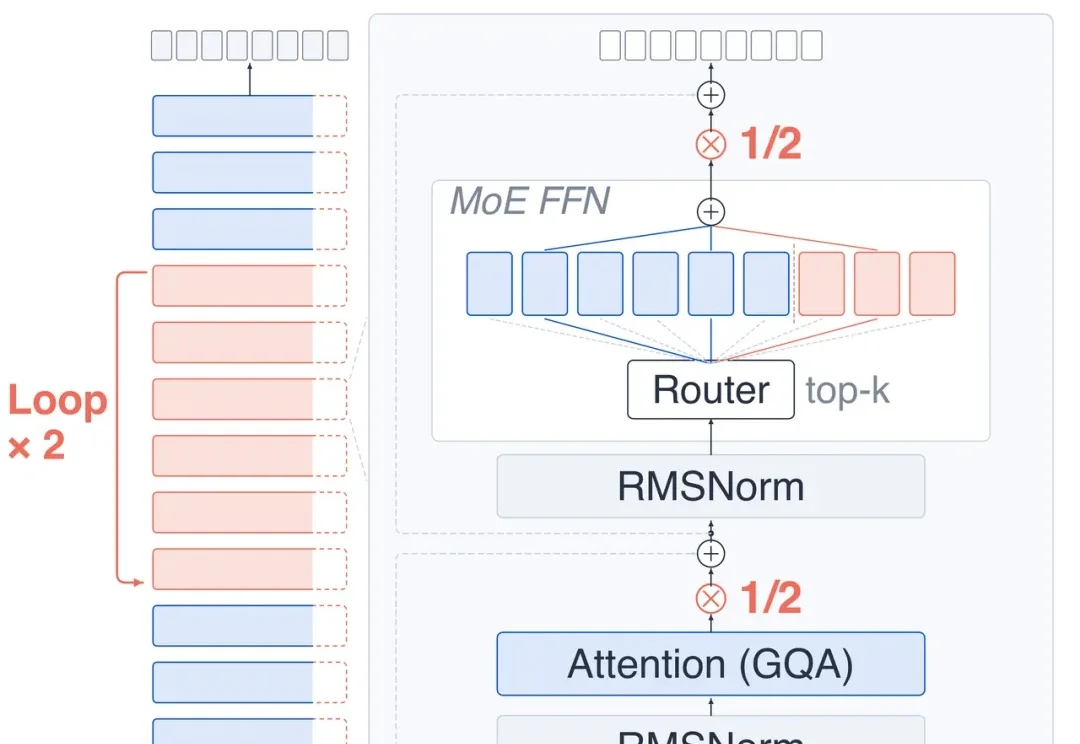
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
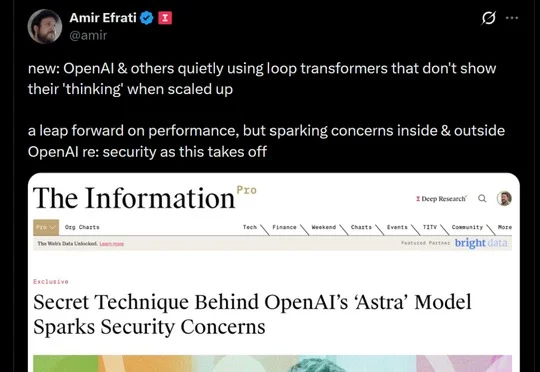
GPT-6 Astra采用循环深度技术带火循环Transformer,阿里早在11个月前便布局MeSH和SpiralFormer两篇论文,分别针对循环内部的计算冗余和信息粒度问题提出解决方案,为下一代高效大模型架构探路。
文章以1955年麦卡锡等四人提交达特茅斯会议提案为起点,回顾人工智能学科诞生70年来的关键节点——符号主义与连接主义的兴衰、两次AI寒冬的成因与转机、2012年深度学习崛起、Transformer架构与ChatGPT引发的产业变革,指出AI发展是一条反复冲高与摔落的锯齿线,每一次寒冬皆因承诺跑得比能力快。