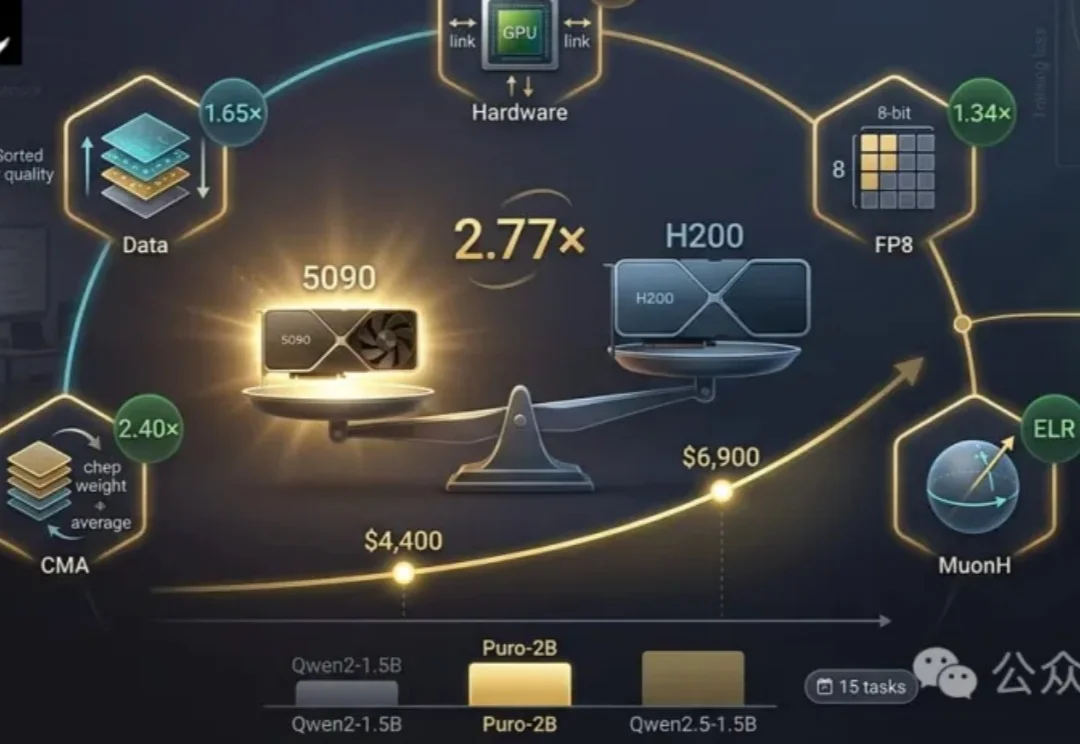
小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元
小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
来自主题: AI技术研报
10541 点击 2026-10-16 11:26

 搜索
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
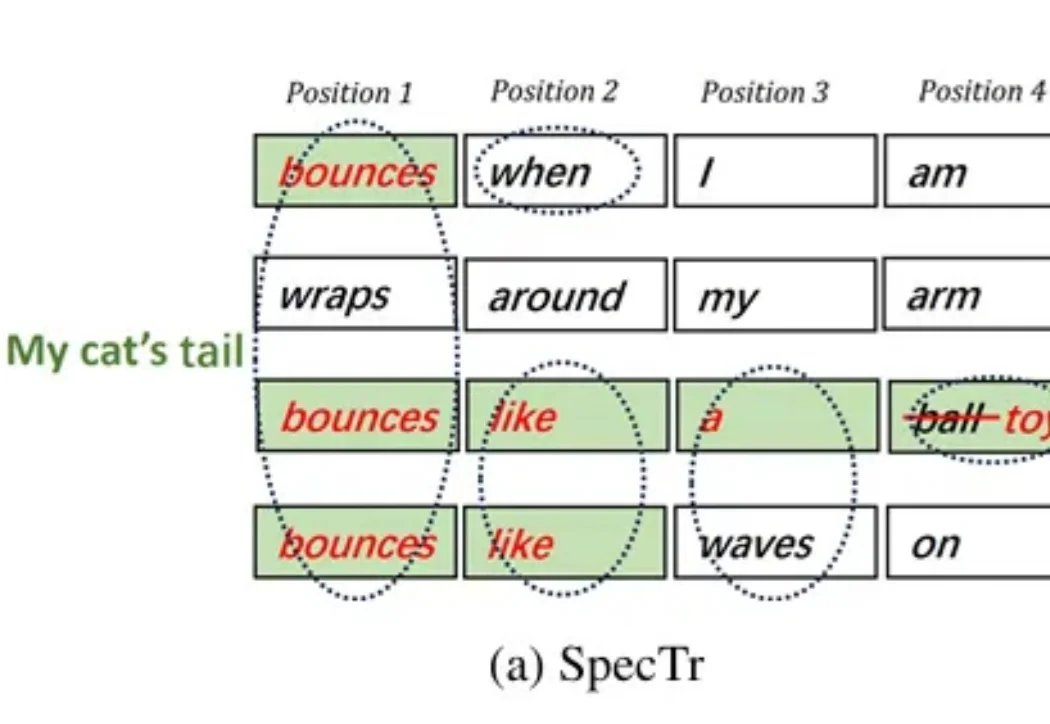
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
不er,A\你穿越回来的啊??
天闹地麻,绷住怎么会是惩罚。
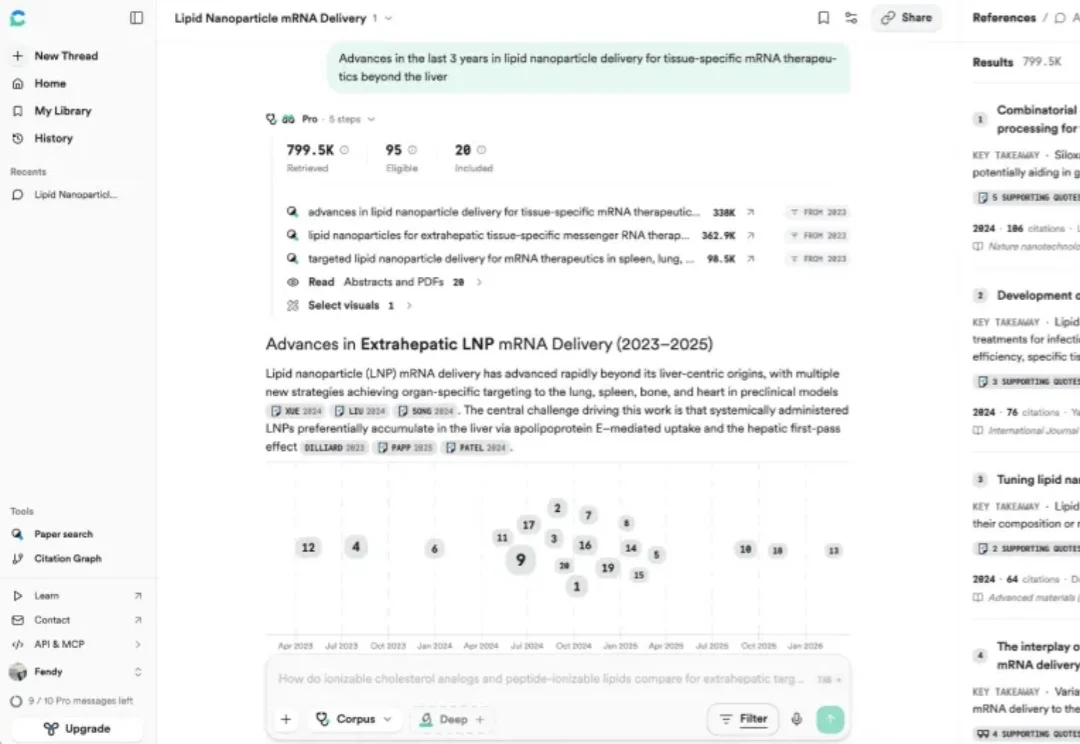
同样的一个问题,在不同学科中的表达与关键词,往往天差地别。
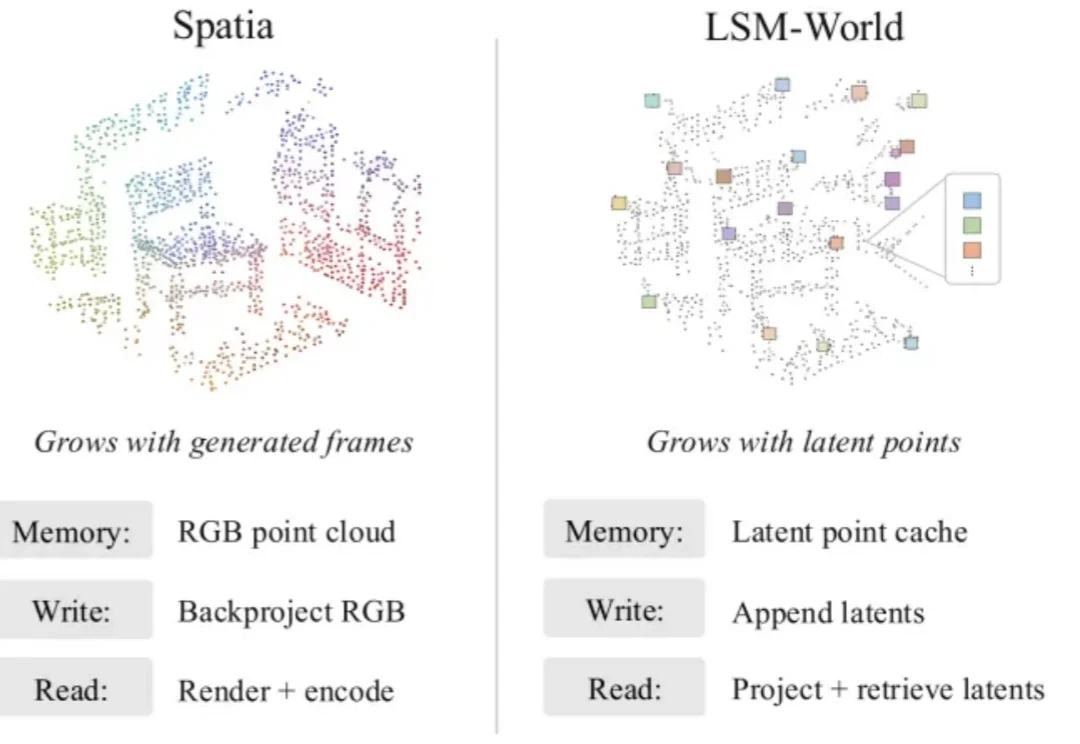
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
包馄饨,对大多数人来说很简单:一手托皮,一手挑馅,对折,捏边,收口。很少有人意识到,这个过程里手掌始终在承托一张随时会变形的面皮,手指在不断感受馅料和面皮的回弹,两只手还要在恰当的时机交接。
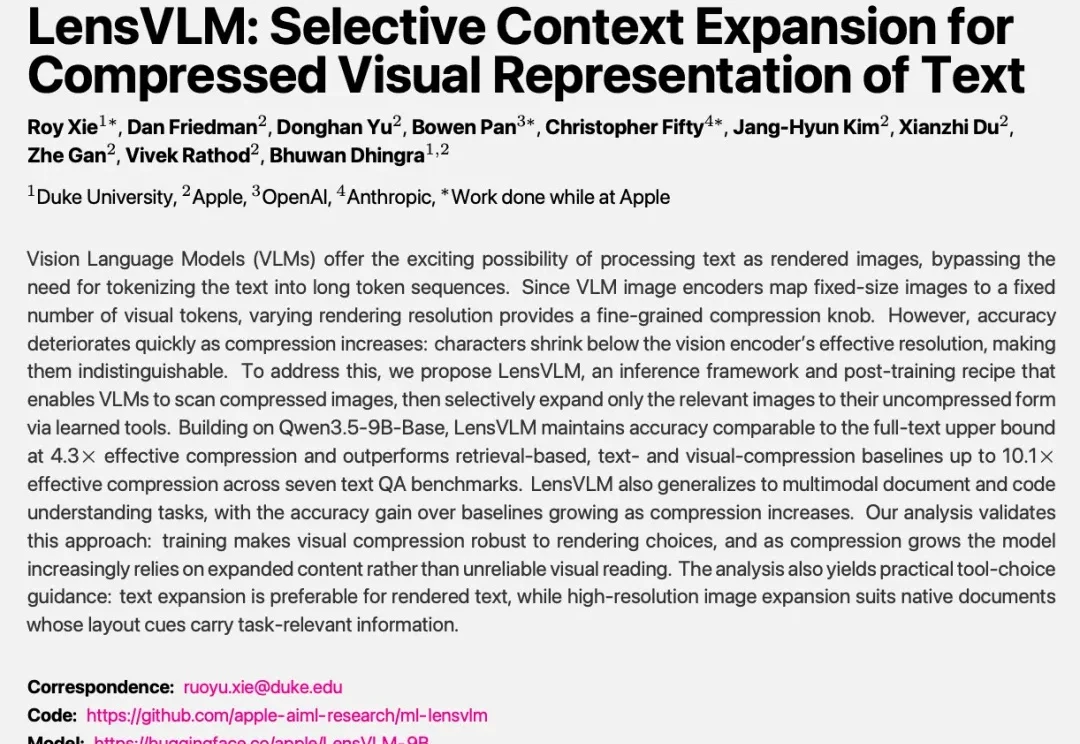
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
近期,AI 在数学研究领域的进展引发广泛关注。OpenAI 等机构接连公布 AI 解决数学问题的新成果,也让数学界开始重新思考:当 AI 能够参与甚至独立完成复杂数学证明,数学家的价值将如何体现?数学研究的范式、人才培养方式又将发生哪些变化?
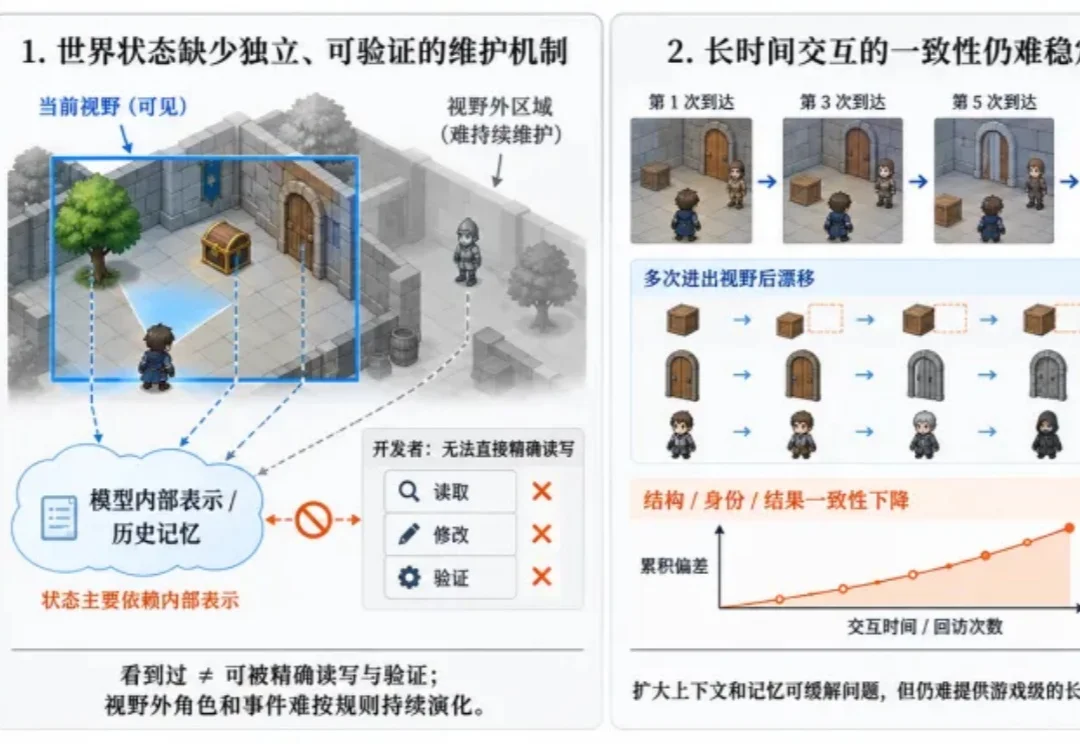
不er,印象中非常吃算力的「游戏世界模型」,居然就这样被塞进一张RTX 5090里了?!