算力成本大降!马尔可夫思考机来了,LLM推理成本直接降为线性
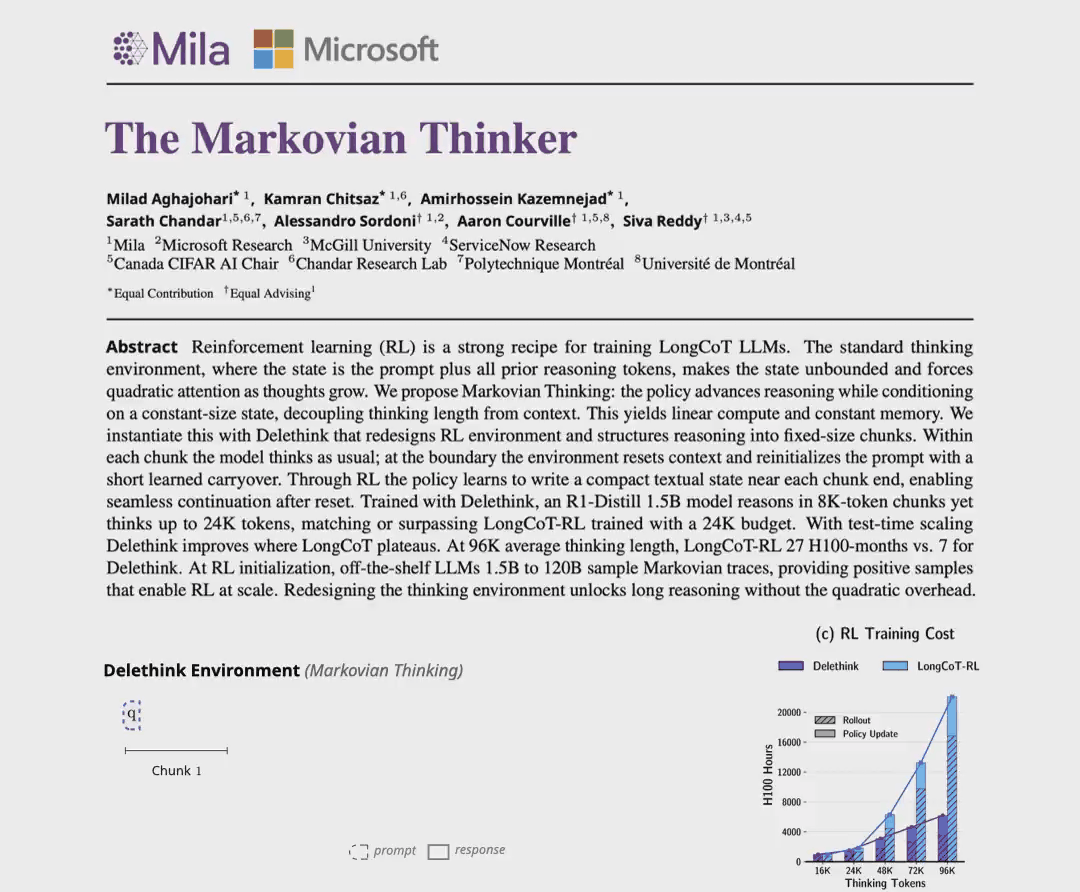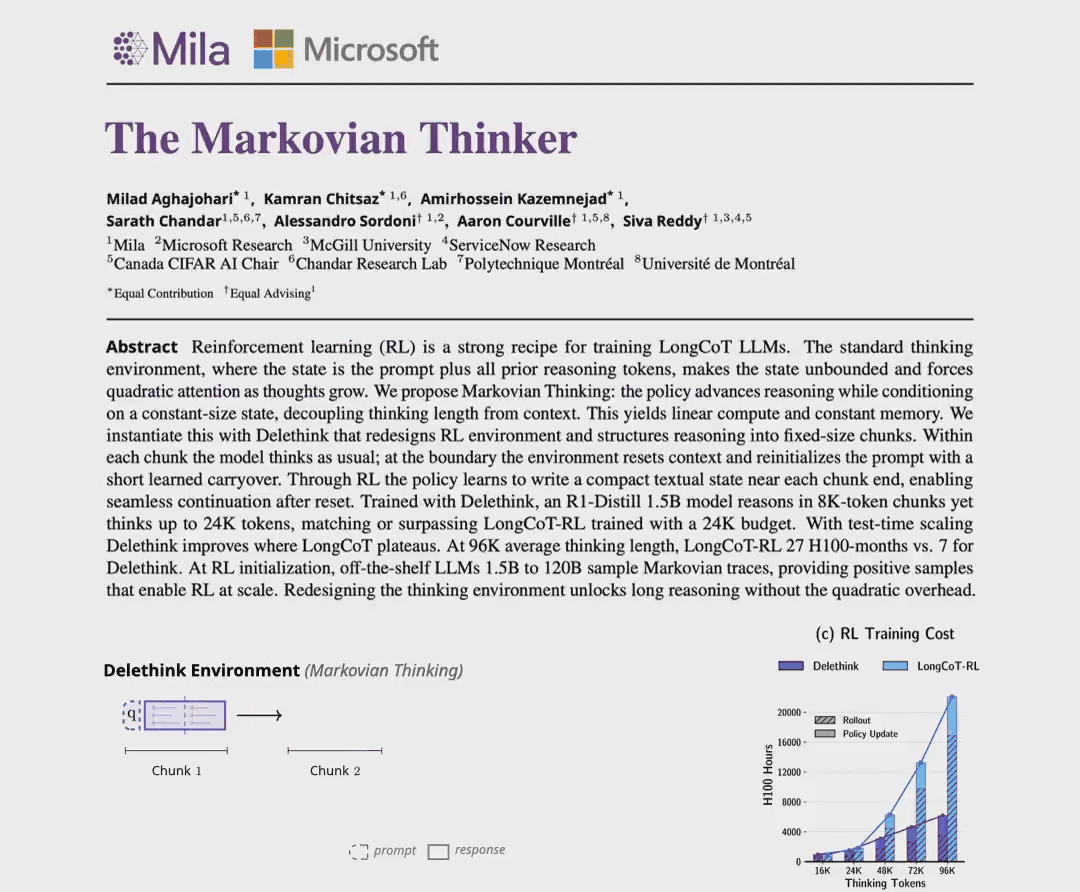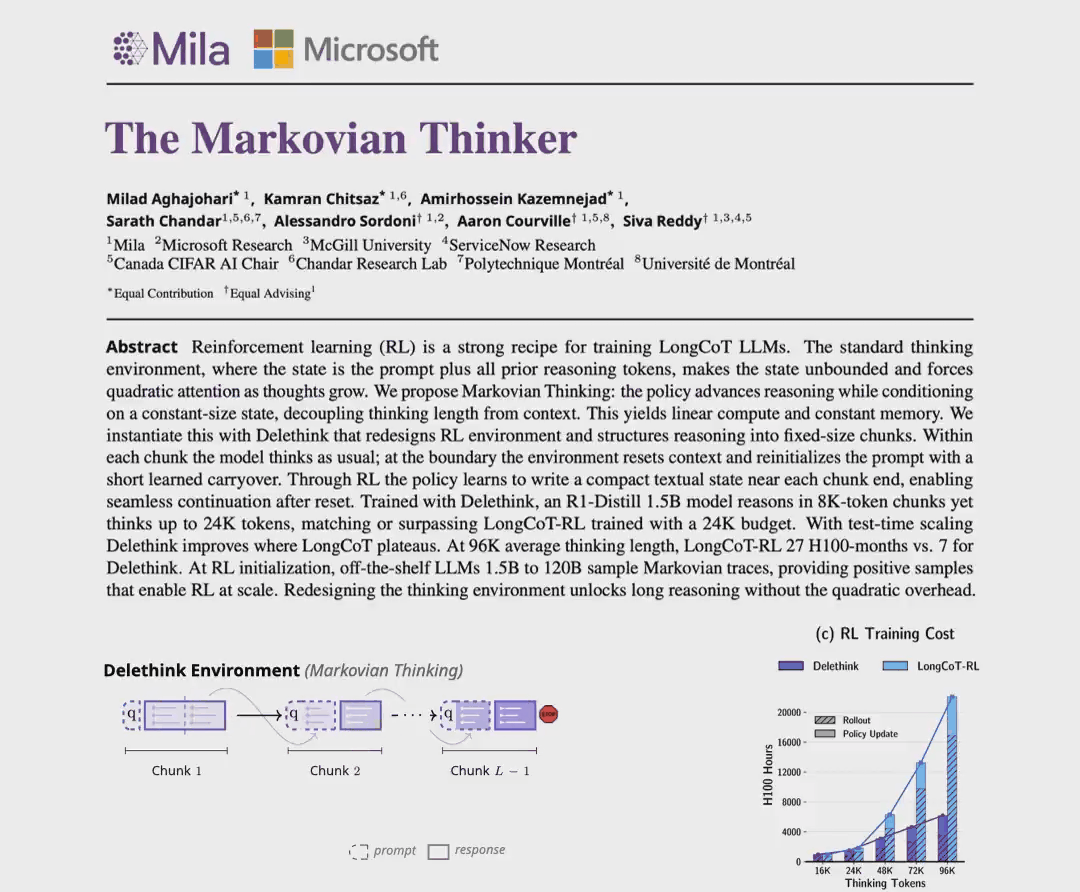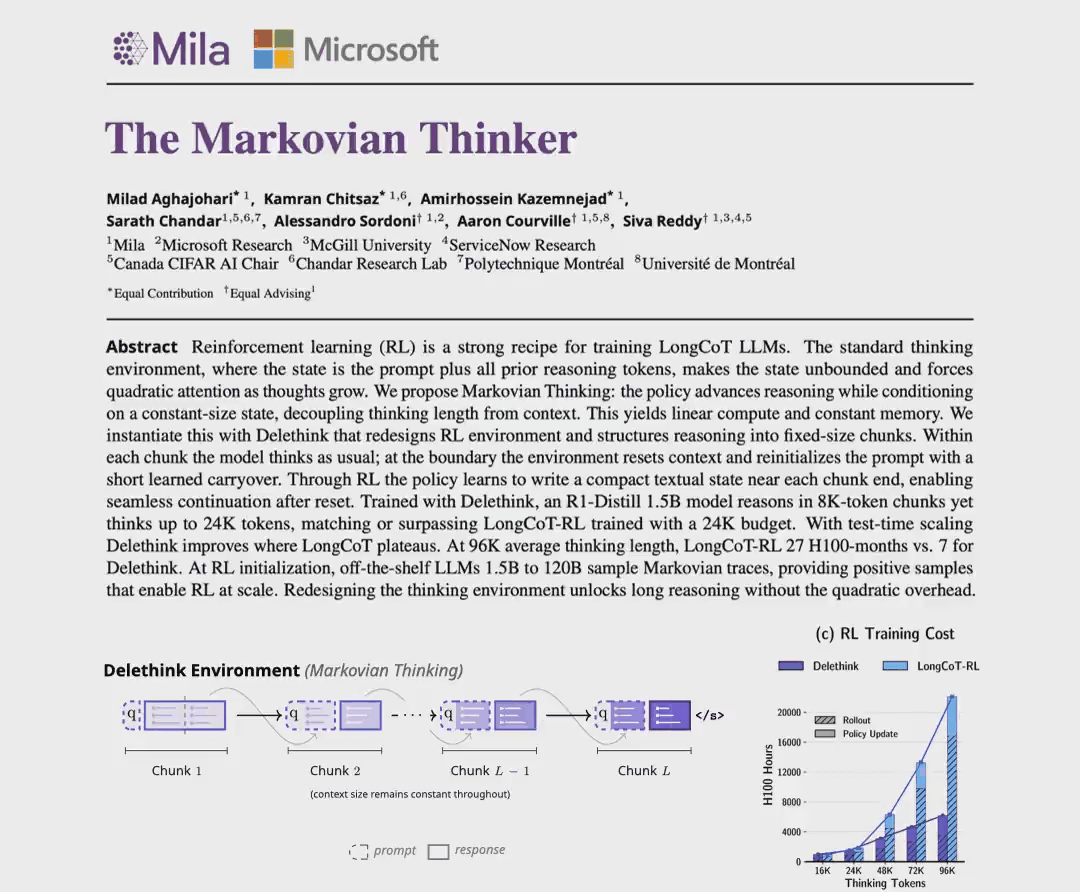
算力成本大降!马尔可夫思考机来了,LLM推理成本直接降为线性Mila 和微软研究院等多家机构的一个联合研究团队却另辟蹊径,提出了一个不同的问题:如果环境从一开始就不会造成计算量的二次级增长呢?他们提出了一种新的范式,其中策略会在基于一个固定大小的状态上进行推理。他们将这样的策略命名为马尔可夫式思考机(Markovian Thinker)。
来自主题: AI技术研报
10190 点击 2025-10-11 11:31

 搜索
Mila 和微软研究院等多家机构的一个联合研究团队却另辟蹊径,提出了一个不同的问题:如果环境从一开始就不会造成计算量的二次级增长呢?他们提出了一种新的范式,其中策略会在基于一个固定大小的状态上进行推理。他们将这样的策略命名为马尔可夫式思考机(Markovian Thinker)。
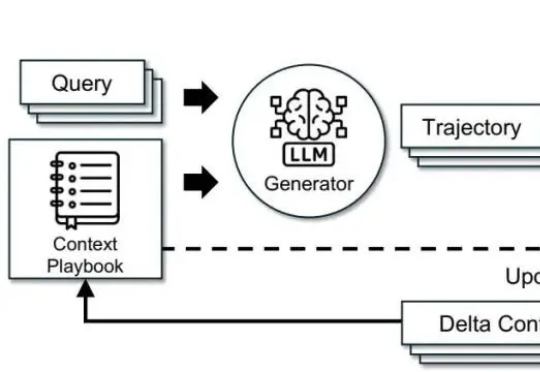
调模型不如“管上下文”。这篇文章基于 ACE(Agentic Context Engineering),把系统提示、运行记忆和证据做成可演化的 playbook,用“生成—反思—策展”三角色加差分更新,规避简化偏置与上下文塌缩。在 AppWorld 与金融基准上,ACE 相较强基线平均提升约 +10.6% 与 +8.6%,适配时延降至约 1/6(-86.9%),且在无标注监督场景依然有效。
“事实证明,不焦虑的人做不好 AI 应用。” 文丨程曼祺 “明年可能是 to C 应用的元年。”9 月 28 日,Lovart 创始人陈冕告诉我们。 第二天,“元年” 被加速——OpenAI 发布 S
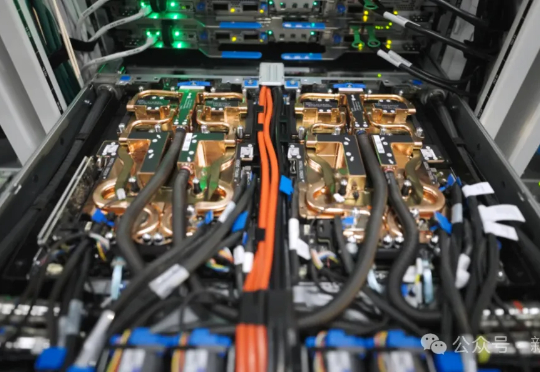
为了争夺有限的GPU,OpenAI内部一度打得不可开交。2024年总算力投入70亿美元,但算力需求依旧是无底洞。恰恰,微软发布了全球首台GB300超算,专供OpenAI让万亿LLM数天训完。

“我明明有这么多想法,为什么就是动不起来?”直到那晚,我听到技术博主余一聊起 “AIasMe” 这个概念,那天我像往常样刷播客,听到了一期访谈节目,她在节目里聊到一个想法:“如果我能创造一个虚拟的自己,一个用AI驱动的自我分身,它能不能陪我一起整理内心的混乱、沉淀思绪?”。。那一瞬间,我几乎是立刻按下了暂停键。
来自加州大学圣地亚哥分校(UCSD)的华人学者Wanda Hou,与加州大学伯克利分校以及Google Quantum AI合作,在谷歌的Sycamore与Willow超导量子处理器上完成了一次别开生面的实验。

Augie最大的优势就是,能够实现跨平台。也就是说,Augie打造的AI员工可以在不同的系统平台里来回操作。这意味着,人工不用再在五六个系统之间来回切换,Augie自己就能完成很多原本依赖人力的工作。
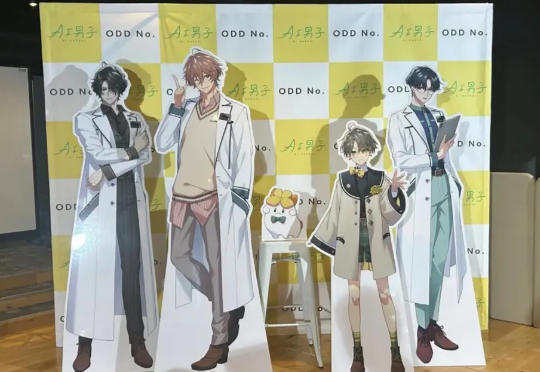
前不久,我们在收集新闻时,发现一款名为「AI 男子」的女性向 AI 陪伴项目正式上线,主要理念是“创造一个可以与自己喜欢的人交谈的世界”。「AI 男子」由日本公司 Odd Number 打造,上线初始便在 X、Instagram 和 TikTok 等主流社媒全面布局。
整场访谈中,Altman 展现出一种难得的坦诚。他承认 OpenAI 在某些测试上输给了竞争对手, 承认提前发布 Sora 是为了让社会接受假视频的冲击, 承认「AI slop」(AI 垃圾) 确实是个问题——但话锋一转,他补充道:人类自己也一直在制造烂活儿。
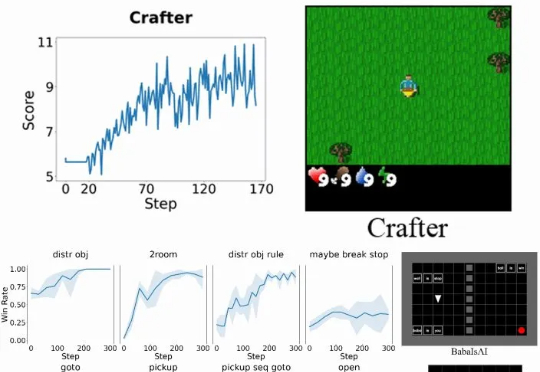
具体而言,Verlog 是一个多轮强化学习框架,专为具有高度可变回合(episode)长度的长时程(long-horizon) LLM-Agent 任务而设计。它在继承 VeRL 和 BALROG 的基础上,并遵循 pytorch-a2c-ppo-acktr-gail 的成熟设计原则,引入了一系列专门优化手段,从而在任务跨度从短暂交互到数百回合时,依然能够实现稳定而高效的训练。