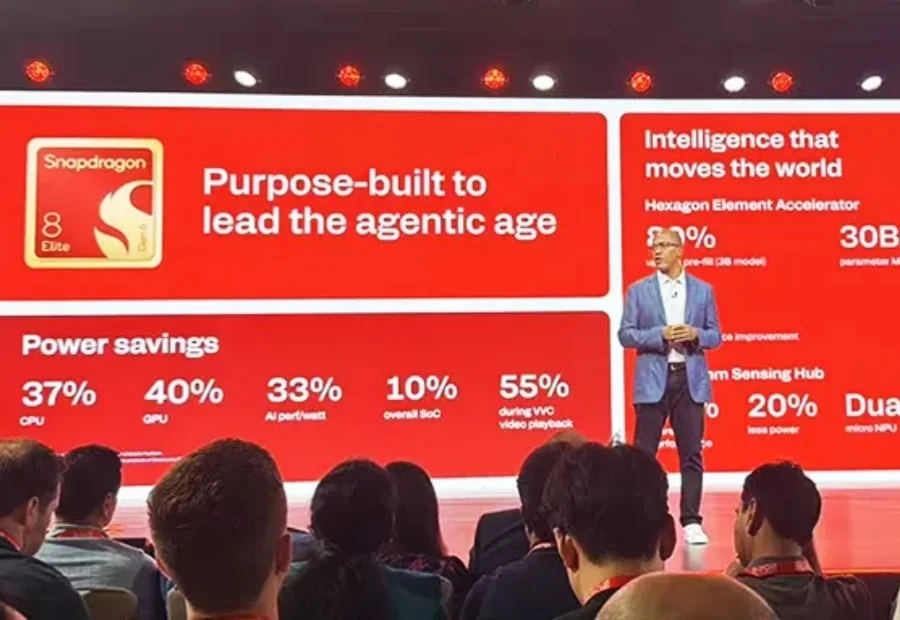
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
来自主题: AI资讯
6576 点击 2026-09-23 10:19

 搜索
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
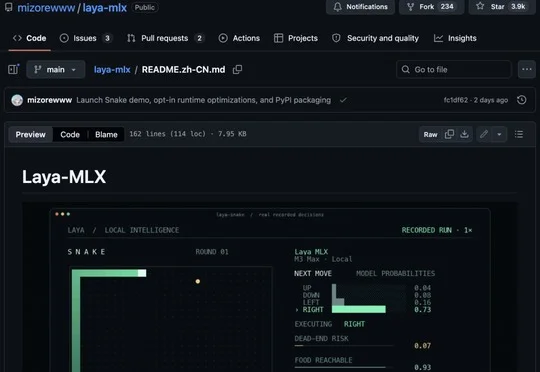
开发者mizorewww将开源决策模型Laya移植到Apple MLX框架,推出本地版Laya-MLX,可在Apple Silicon Mac上以低于1GB内存运行并摆脱PyTorch与云端API依赖,421M版本峰值内存943.6MiB、322M多语言版本687.6MiB。
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
坚持 1 晚通宵,烧掉 2 亿 Token,用上 3D 打印,掏出 4 千账单,购置 512GB 内存 Mac Studio,Vibe Coding 到 6 神无主,7 荤 8 素,最终获得 0 个用户......
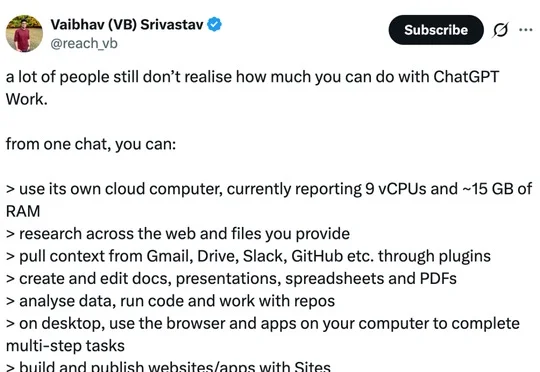
ChatGPT Work于8月25日上线云浏览器登录功能,背后的云电脑配有约9个虚拟CPU和15GB内存,可在网页和手机端自动登录网站处理订狗粮、保险报销等任务,而密码对AI不可见,标志着该智能体首次跨越登录墙真正替用户办完事。
寅谱试图用一种“以存换算”的思路破题:不是让硬盘SSD替代GPU计算,而是用更低成本的SSD承接温冷(指访问频率极低和中等)的AI大模型数据、复用已经完成的中间结果,减少显存及内存压力、GPU等待和重复Prefill(预填充)。
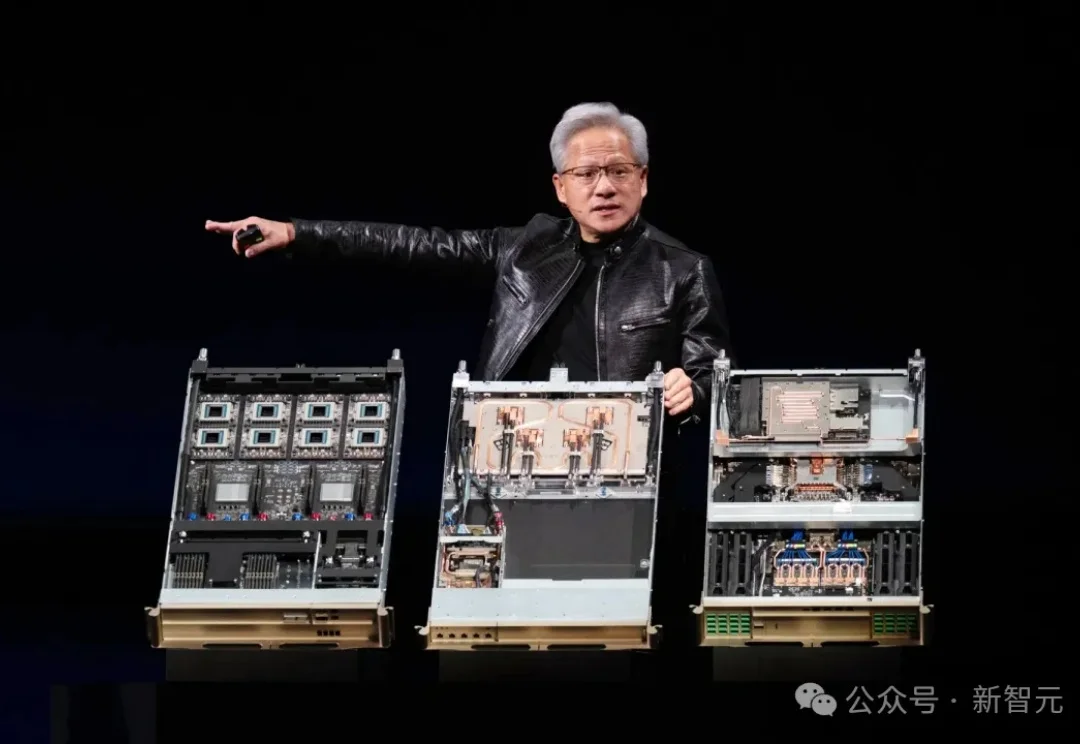
一台AI服务器,涨价超过15%!
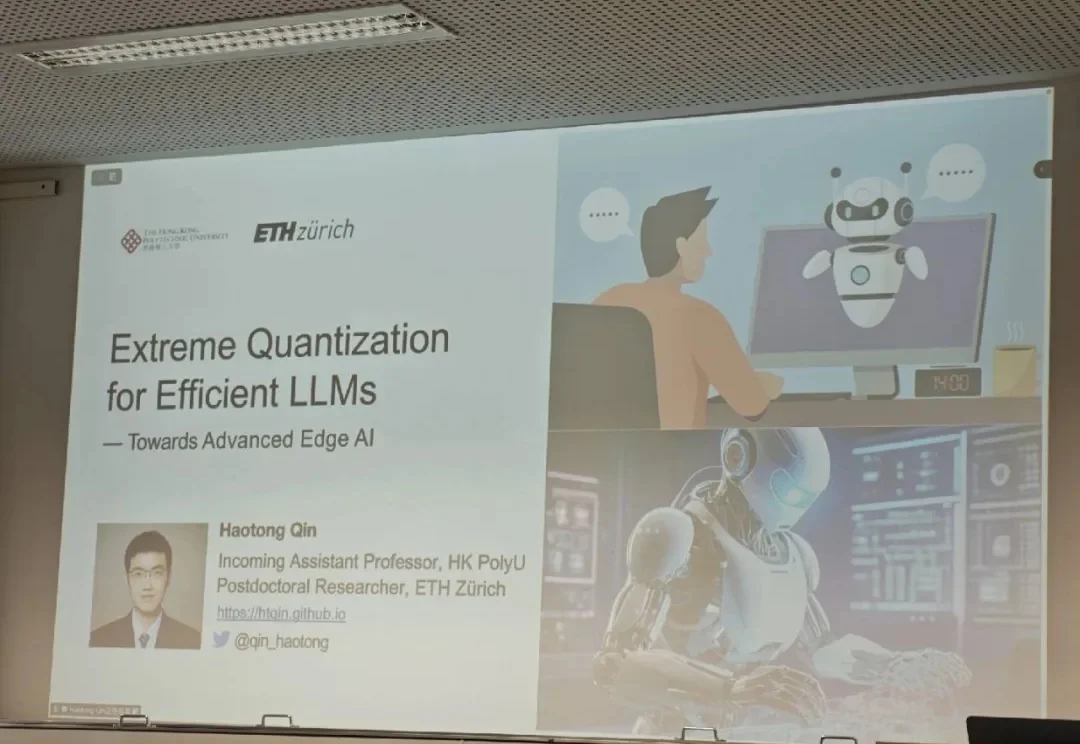
面对大模型规模与硬件内存之间高达20倍的算力鸿沟,不重训的“1比特量化”如何把千亿参数的硅基大脑塞进微型设备?
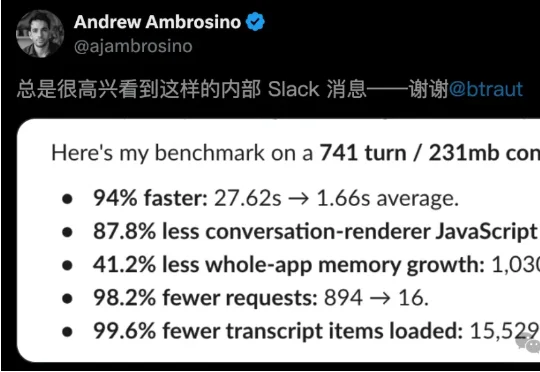
OpenAI接连放大招!今天,一条OpenAI内部Slack消息爆出,ChatGPT将迎来一次「史诗级」的性能大换血。从硬核测试数据来看,这次ChatGPT前端性能的优化幅度,夸张到近乎「不真实」:应用加载速度直接飙升94%,堆内存增长减少87.8%,整体内存占用砍掉41.2%。