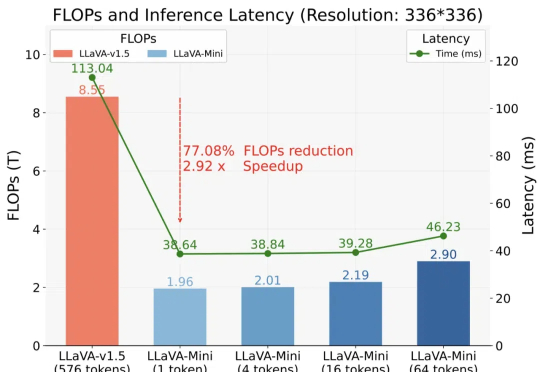
LLaVA-Mini来了!每张图像所需视觉token压缩至1个,兼顾效率内存
LLaVA-Mini来了!每张图像所需视觉token压缩至1个,兼顾效率内存以 GPT-4o 为代表的实时交互多模态大模型(LMMs)引发了研究者对高效 LMM 的广泛关注。现有主流模型通过将视觉输入转化为大量视觉 tokens,并将其嵌入大语言模型(LLM)上下文来实现视觉信息理解。
来自主题: AI技术研报
6242 点击 2025-02-06 15:26

 搜索
以 GPT-4o 为代表的实时交互多模态大模型(LMMs)引发了研究者对高效 LMM 的广泛关注。现有主流模型通过将视觉输入转化为大量视觉 tokens,并将其嵌入大语言模型(LLM)上下文来实现视觉信息理解。
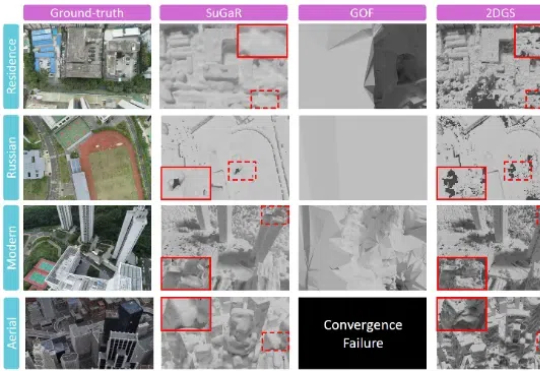
来自中科院自动化所的研究团队提出了用于大规模复杂三维场景的高效重建算法 CityGaussianV2,能够在快速实现训练和压缩的同时,得到精准的几何结构与逼真的实时渲染体验。该论文已接受于 ICLR`2025,其代码也已同步开源。
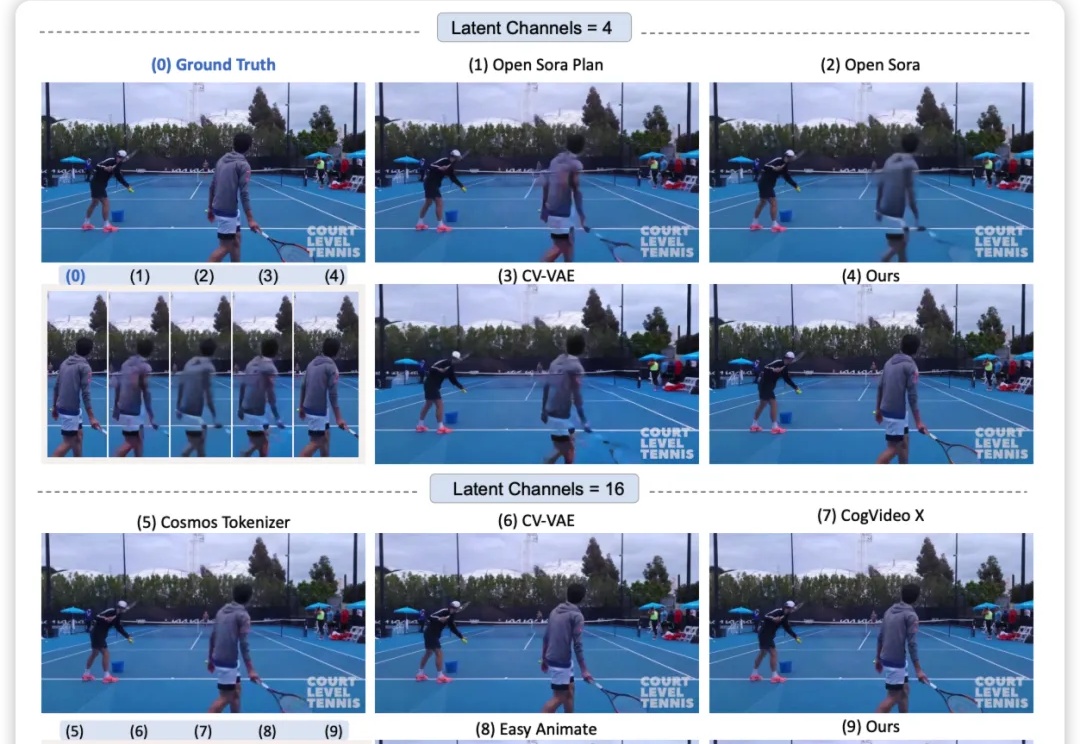
港科大团队重磅开源 VideoVAE+,提出了一种强大的跨模态的视频变分自编码器(Video VAE),通过提出新的时空分离的压缩机制和创新性引入文本指导,实现了对大幅运动视频的高效压缩与精准重建,同时保持很好的时间一致性和运动恢复。
在大语言模型(LLM)的发展历程中,思维链(Chain of Thought,CoT)推理无疑是一个重要的里程碑。
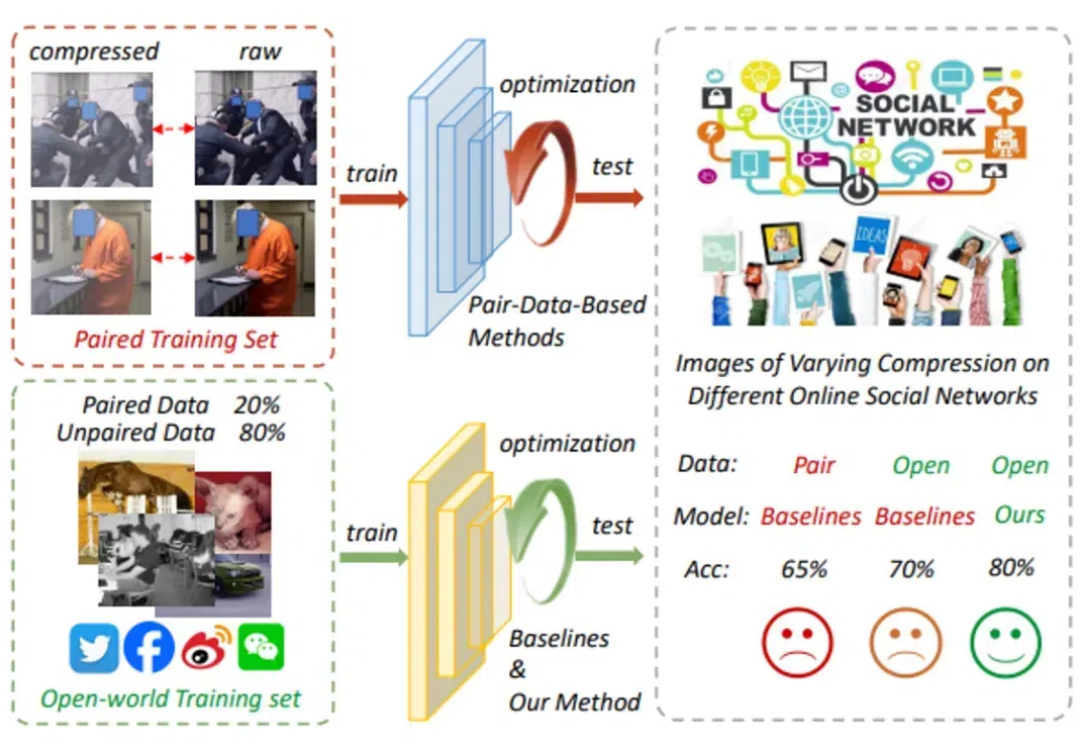
现有的深伪检测方法大多依赖于配对数据,即一张压缩图像和其对应的原始图像来训练模型,这在许多实际的开放环境中并不适用。尤其是在社交媒体等开放网络环境(OSN)中,图像通常经过多种压缩处理,导致图像质量受到影响,深伪识别也因此变得异常困难。
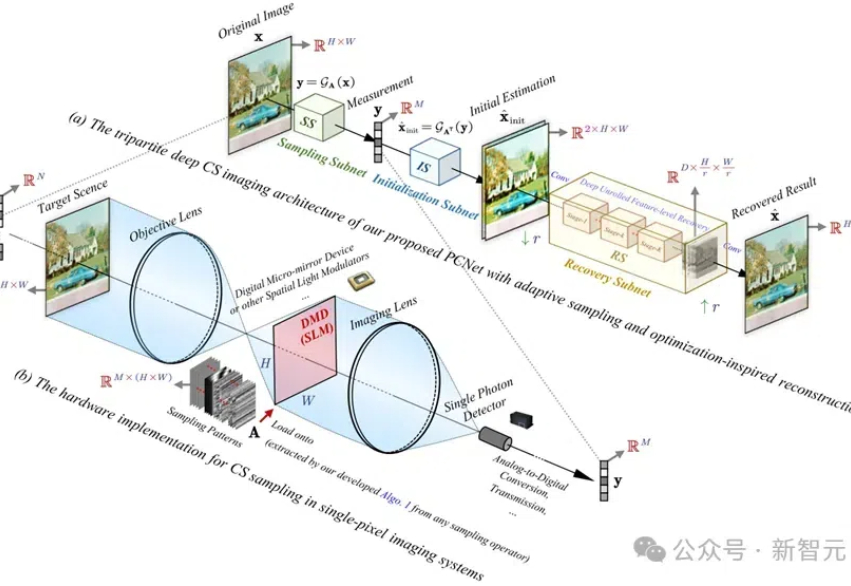
PCNet网络具有创新的协同采样算子和优化的重建网络,实验结果证明,其在图像重建精度、计算效率和任务扩展性方面均优于现有方法,为高分辨率图像的压缩感知提供了新的解决方案。
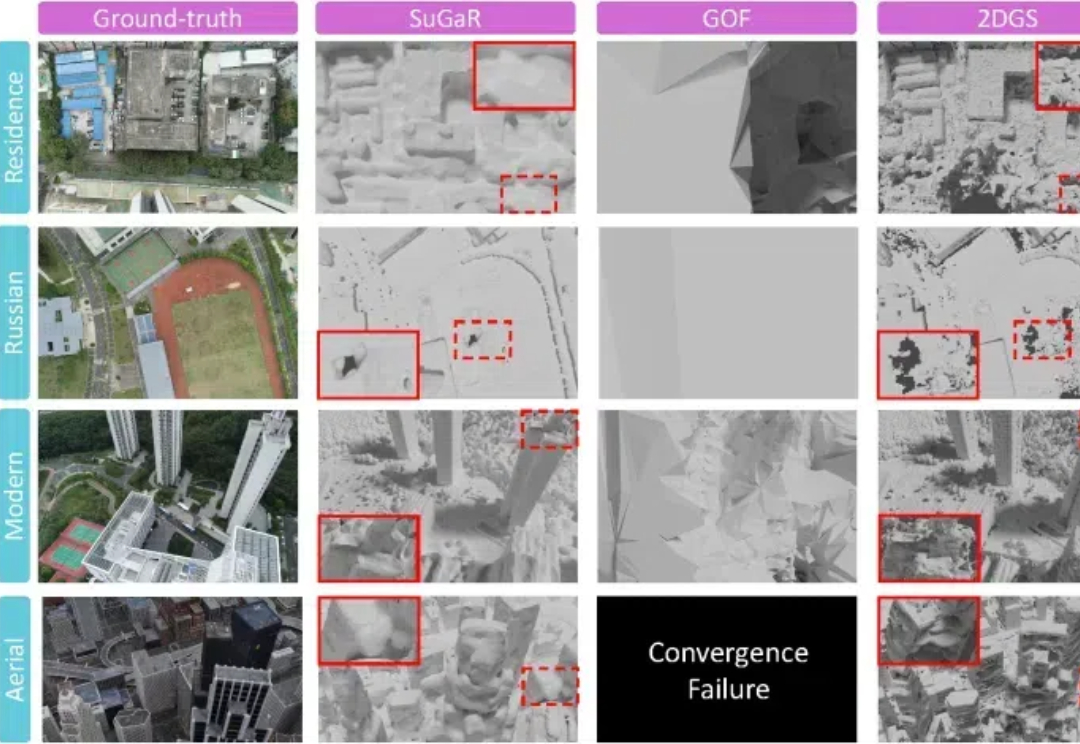
来自中科院自动化所的研究团队提出了用于大规模复杂三维场景的高效重建算法CityGaussianV2,能够在快速实现训练和压缩的同时,得到精准的几何结构与逼真的实时渲染体验。

双深科技近日获得来自上市公司富瀚微(300613.SZ)的数千万元人民币战略投资。双深科技成立于2020年,是一家致力于用AI技术颠覆传统图像和视频压缩与处理的AI创业公司。团队研发实力雄厚,核心成员均来自国内外顶尖高校,并数次在国际人工智能顶级会议CVPR夺得图像与视频编解码领域的全球冠军,奠定了公司在技术上的领先地位。
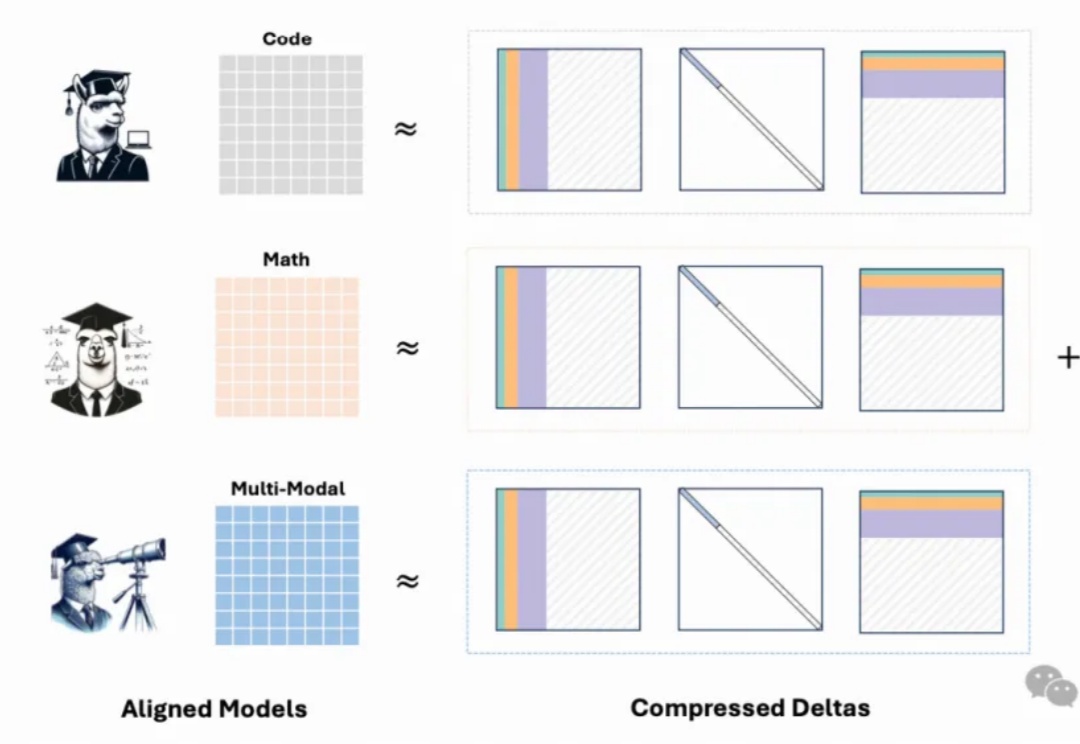
最新模型增量压缩技术,一个80G的A100 GPU能够轻松加载多达50个7B模型,节省显存约8倍,同时模型性能几乎与压缩前的微调模型相当。
近日,人形机器人公司1X公布了世界模型挑战赛的二阶段:Sampling。一同登场的还有合作伙伴英伟达新发布的Cosmos视频分词器,超高质量和压缩率助力构建虚拟世界。