谁说大象不能起舞! 重编程大语言模型实现跨模态交互的时序预测 | ICLR 2024
谁说大象不能起舞! 重编程大语言模型实现跨模态交互的时序预测 | ICLR 2024近,来自澳大利亚蒙纳士大学、蚂蚁集团、IBM 研究院等机构的研究人员探索了模型重编程 (model reprogramming) 在大语言模型 (LLMs) 上应用,并提出了一个全新的视角
来自主题: AI技术研报
9783 点击 2024-04-14 13:07

 搜索
近,来自澳大利亚蒙纳士大学、蚂蚁集团、IBM 研究院等机构的研究人员探索了模型重编程 (model reprogramming) 在大语言模型 (LLMs) 上应用,并提出了一个全新的视角

为解决大模型(LLMs)在处理超长输入序列时遇到的内存限制问题,本文作者提出了一种新型架构:Infini-Transformer,它可以在有限内存条件下,让基于Transformer的大语言模型(LLMs)高效处理无限长的输入序列。实验结果表明:Infini-Transformer在长上下文语言建模任务上超越了基线模型,内存最高可节约114倍。
它通过将压缩记忆(compressive memory)整合到线性注意力机制中,用来处理无限长上下文
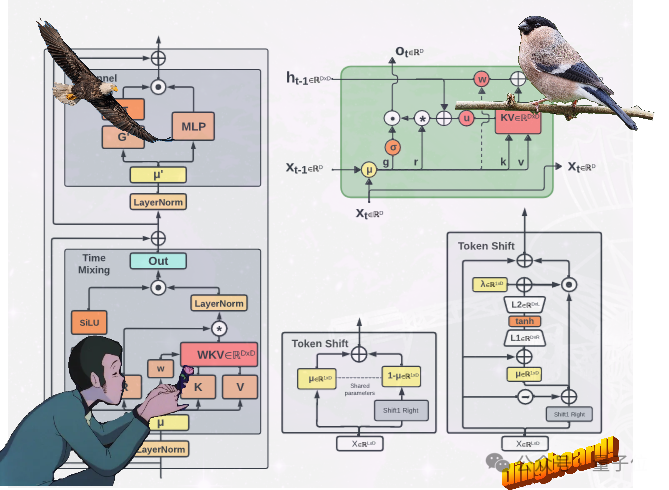
不走Transformer寻常路,魔改RNN的国产新架构RWKV,有了新进展: 提出了两种新的RWKV架构,即Eagle (RWKV-5) 和Finch(RWKV-6)。
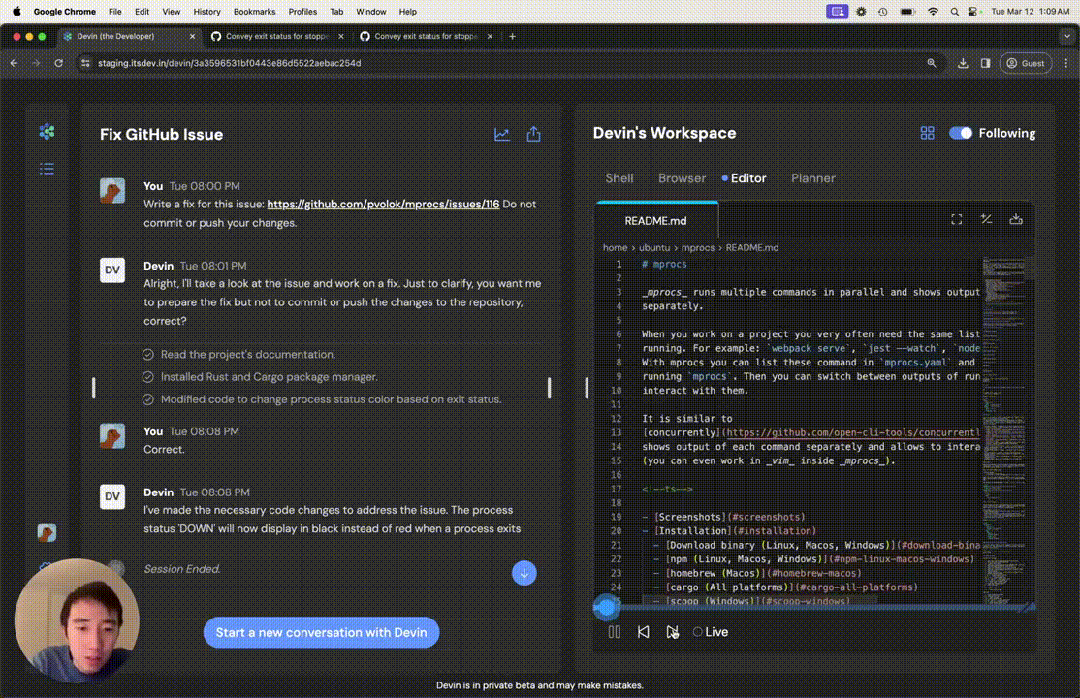
号称世界首个AI工程师Devin,7×24小时不限时打工,能够debug、训模型、构建部署应用程序,胜任各种代码任务
随着大模型的参数量日益增长,微调整个模型的开销逐渐变得难以接受。 为此,北京大学的研究团队提出了一种名为 PiSSA 的参数高效微调方法,在主流数据集上都超过了目前广泛使用的 LoRA 的微调效果。
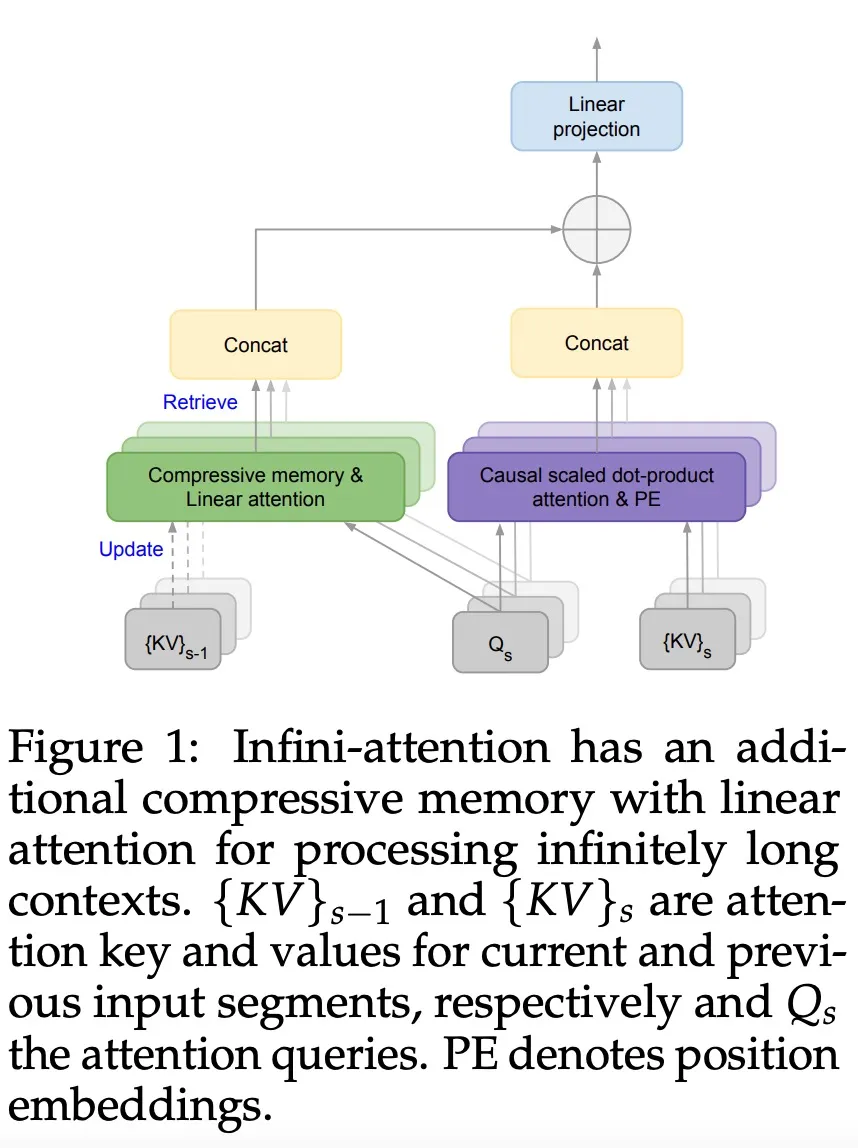
谷歌又放大招了,发布下一代 Transformer 模型 Infini-Transformer。
今天起,最新版的GPT-4 Turbo,正式向ChatGPT Plus用户开放了
大语言模型的效率,正在被这家「清华系」创业公司发展到新高度。
在实践中,人类预测的准确性依赖于「群体智慧」(wisdom of the crowd)效应,即通过聚集一群个体预测者,对未来事件的预测准确率会显著提高