NeurIPS 2026 | FlowMAS:让AI团队自己学会「排兵布阵」
NeurIPS 2026 | FlowMAS:让AI团队自己学会「排兵布阵」厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
来自主题: AI技术研报
9147 点击 2026-10-17 11:59

 搜索
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
Sharpa以22自由度Sharpa Wave灵巧手为硬件平台,通过融合人类与遥操作数据、解耦运动与接触控制及开展触觉跨本体学习,系统推进灵巧操作的数据、模型与硬件协同研究。
普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学、NVIDIA和智元研究人员提出WorldOracle,并于10月16日开放评测平台;七种模型的真实执行对照显示,其机械臂轨迹较准但物体运动易偏离,长序列预测表现也会明显退化。
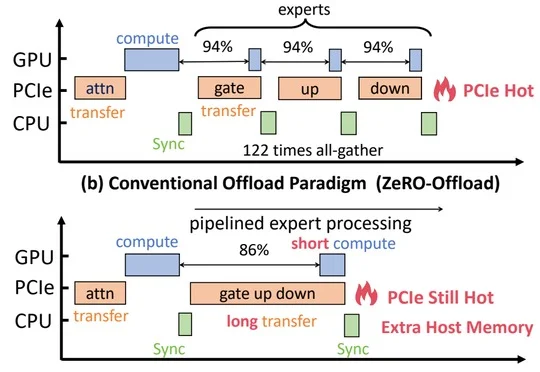
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
OpenAI前研究员Nick Cammarata与Goodfire团队发布研究称,一个320亿参数语言模型中约90%的神经元各有可解释的主要任务,表明追踪和干预神经元或能揭示AI内部规律,但该判断仍待更多检验。
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
Anthropic 内部研究模型 Claude 在不到半小时内追溯出五条 NIST 椭圆曲线种子源自以 Unix 时间戳初始化的 lrand48,但该发现未攻破 ECDSA,也未还原全部曲线设计过程。
在能力、成本、稳定性之间寻找最优解。
刚刚,Meta宣布重磅消息:Muse Spark Open正式开源。