前微软亚研院视觉专家胡瀚加入腾讯,负责混元多模态大模型
前微软亚研院视觉专家胡瀚加入腾讯,负责混元多模态大模型1 月 18 日,北京,聊聊 2025 如何加入技术开发? AI 科技评论消息称,前微软亚洲研究院视觉计算组首席研究员胡瀚,不久前加入腾讯,接替已离职的前腾讯混元大模型技术负责人之一的刘威,负责多模态大模型的研发工作。
来自主题: AI资讯
10981 点击 2025-01-09 10:22

 搜索
1 月 18 日,北京,聊聊 2025 如何加入技术开发? AI 科技评论消息称,前微软亚洲研究院视觉计算组首席研究员胡瀚,不久前加入腾讯,接替已离职的前腾讯混元大模型技术负责人之一的刘威,负责多模态大模型的研发工作。
老婆饼里没有老婆,夫妻肺片里没有夫妻,RLHF 里也没有真正的 RL。在最近的一篇博客中,德克萨斯大学奥斯汀分校助理教授 Atlas Wang 分享了这样一个观点。
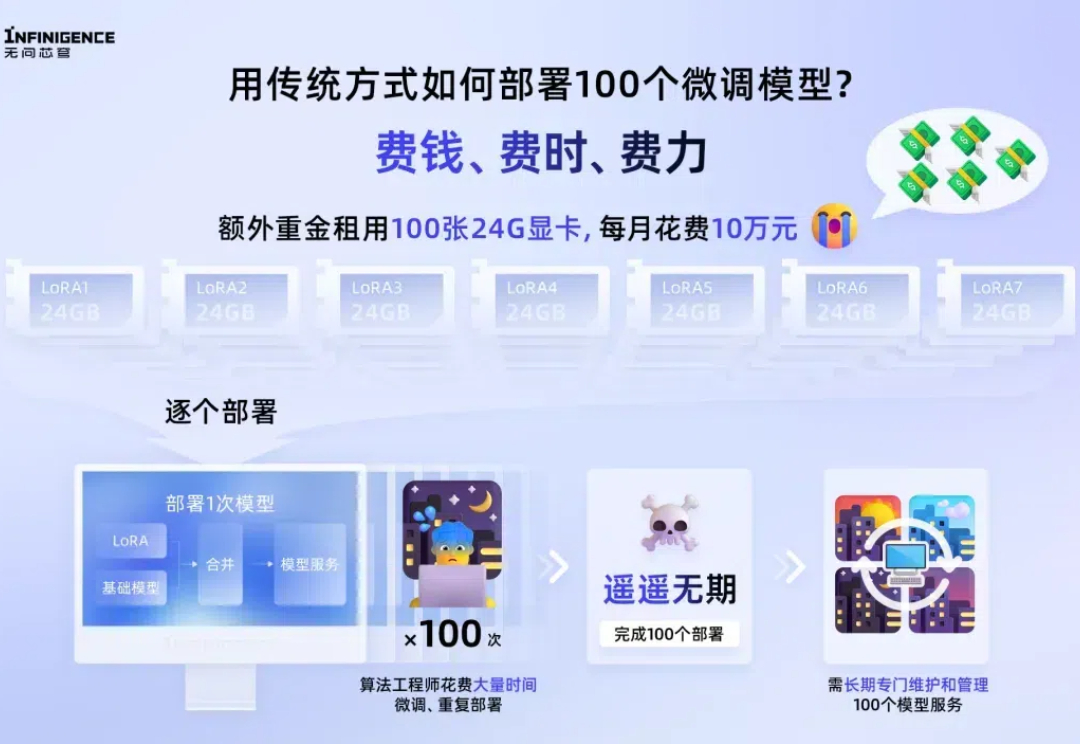
大家可能看到过很多类似的结论:针对特定任务,对开源模型进行 LoRA 微调可以干翻 GPT-4 这类闭源模型。
因为 V3 版本开源模型的发布,DeepSeek 又火了一把,而且这一次,是外网刷屏。 训练成本估计只有 Llama 3.1 405B 模型的 11 分之一,后者的效果还不如它。
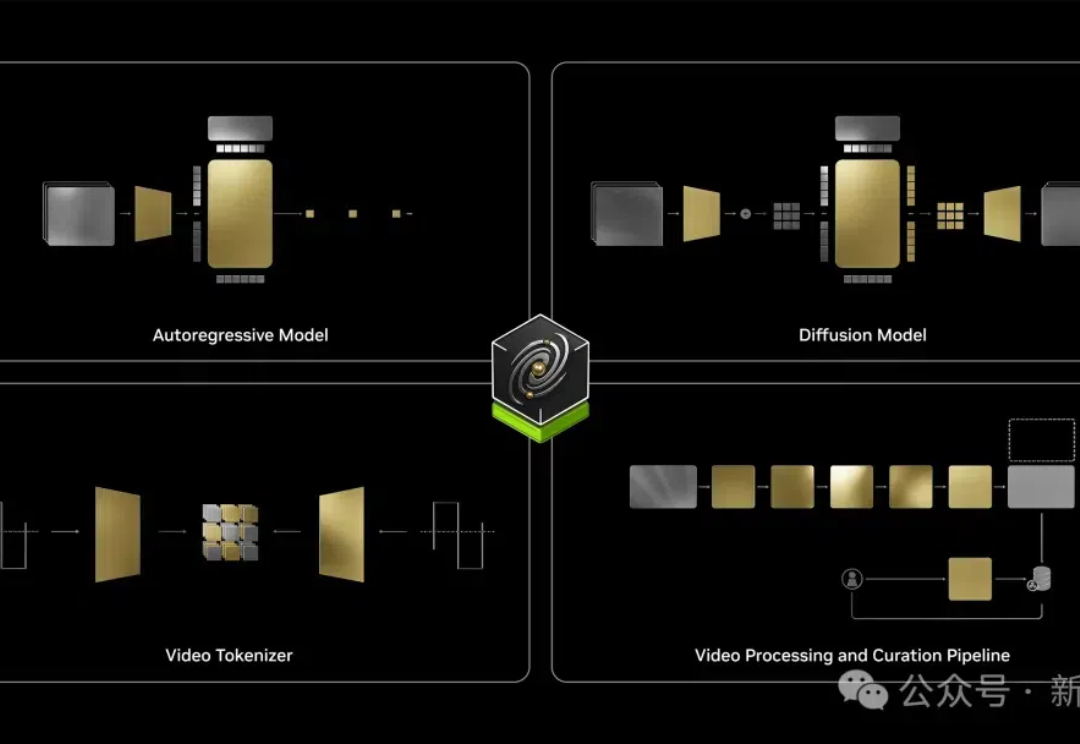
昨天,英伟达官宣了首个「世界基础模型」Cosmos。从此,物理AI数据不够的问题将有望解决!而就在刚刚,75页技术报告火热出炉,GitHub项目更是冲破了2k星。
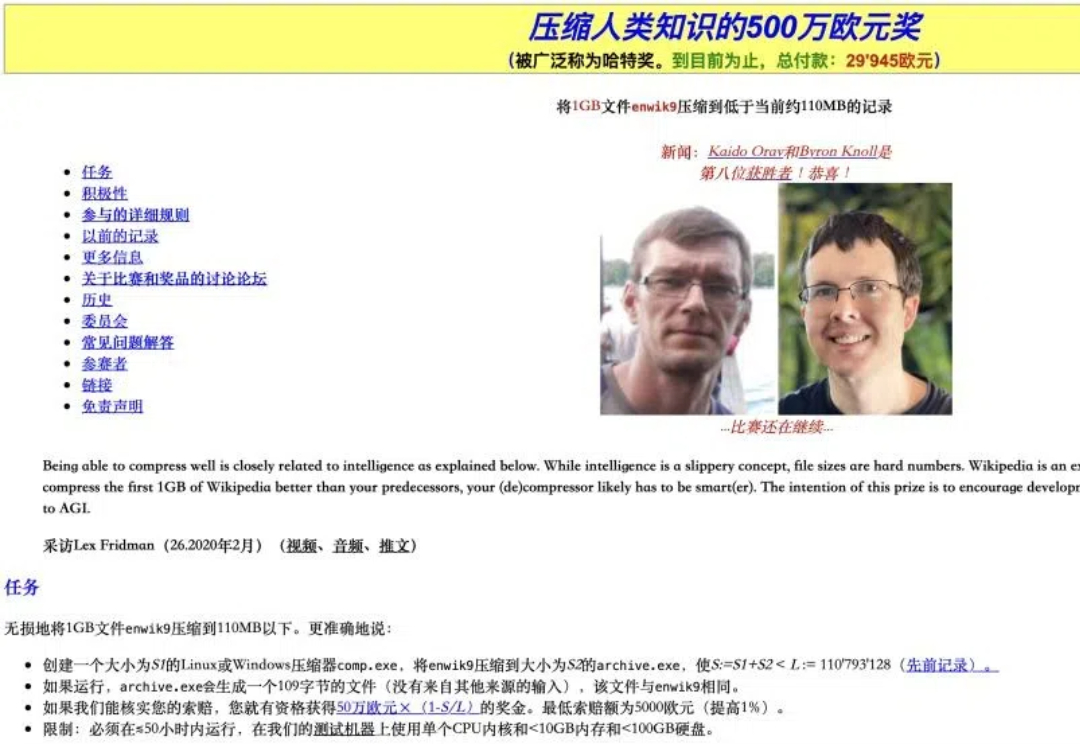
大厂为什么追求大模型? 昨天有提到,为什么要研究语言模型。
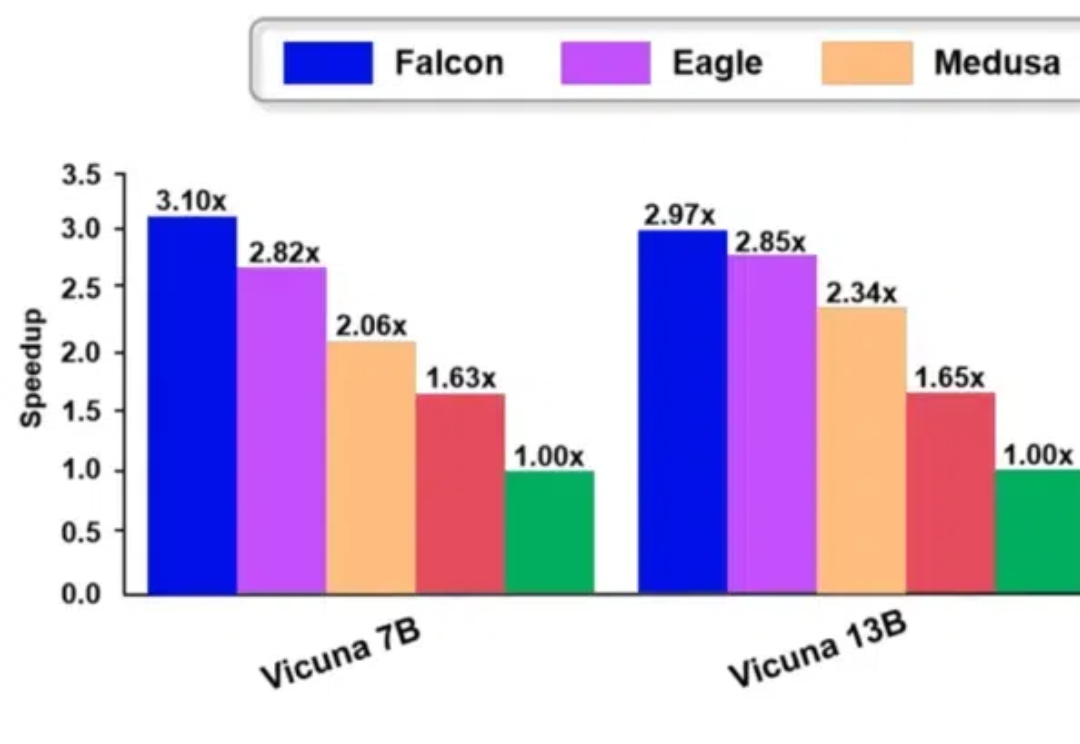
Falcon 方法是一种增强半自回归投机解码框架,旨在增强 draft model 的并行性和输出质量,以有效提升大模型的推理速度。Falcon 可以实现约 2.91-3.51 倍的加速比,在多种数据集上获得了很好的结果,并已应用到翼支付多个实际业务中。
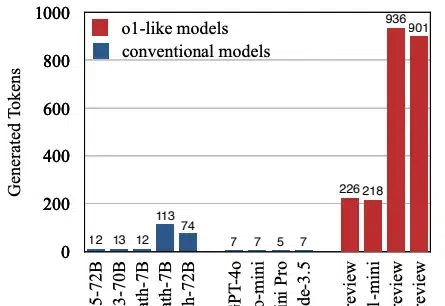
本文将介绍首个关于 o1 类长思维链模型过度思考现象。该工作由腾讯 AI Lab 与上海交通大学团队共同完成。
大模型引发的科技和创业热潮,已经迈入了第三年。
1/10训练数据激发高级推理能力!近日,来自清华的研究者提出了PRIME,通过隐式奖励来进行过程强化,提高了语言模型的推理能力,超越了SFT以及蒸馏等方法。