AI资讯新闻榜单内容搜索-模型训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型训练
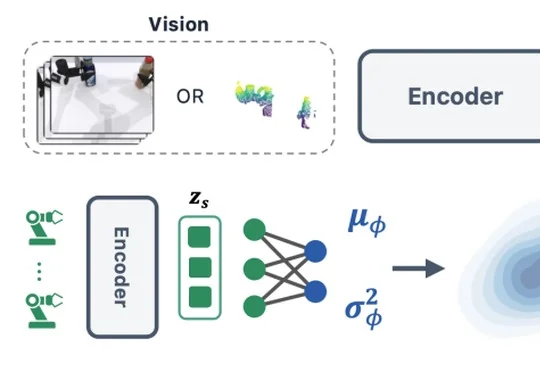
CoRL 2026|让机器人更会动,从学会「起步」开始

CoRL 2026|让机器人更会动,从学会「起步」开始

CoRL 2026|让机器人更会动,从学会「起步」开始

东南大学魏秀参团队提出LeaP(Learnable source Prior)方法,由本体感知信息驱动并联合预测动作生成起点的均值与方差,在RoboTwin仿真15项任务上平均成功率81.6%、较标准高斯基线提升25.5个百分点,相关论文已被CoRL 2026接收。

来自主题: AI技术研报
9671 点击    2026-10-04 22:01
Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

南洋理工大学安波团队最新研究指出,Agent Harness的选型应将模型、Harness与任务作为完整配置联合评估,不同任务下最佳组合会变化,原生搭配也未必优于其他可配置Harness。
来自主题: AI技术研报
9194 点击    2026-10-04 22:01
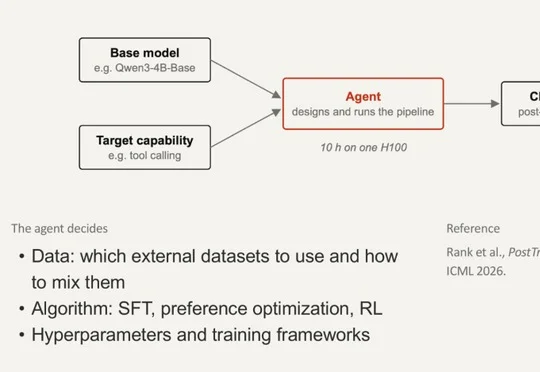
让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
来自主题: AI技术研报
9453 点击    2026-10-03 10:29
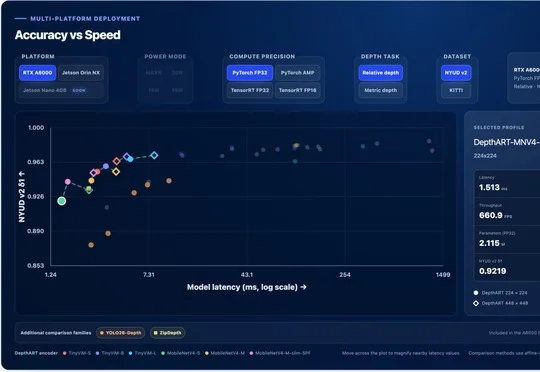
把Depth Anything砍到6M,深度估计终于能跑进Jetson

把Depth Anything砍到6M,深度估计终于能跑进Jetson

把Depth Anything砍到6M,深度估计终于能跑进Jetson

论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
来自主题: AI技术研报
9392 点击    2026-10-03 10:28
LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

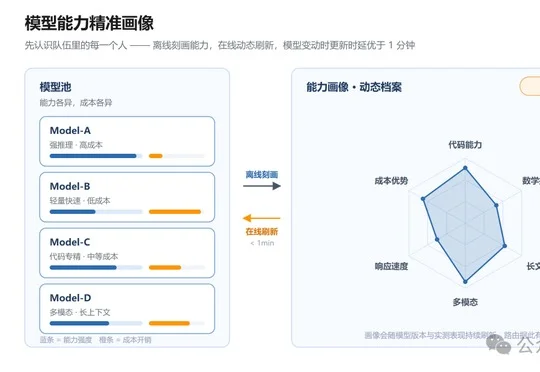
从 1200 万个候选拉取请求中,最终留下 5000 个 SWE 代码任务 —— 不足 0.05%。把「出题、答题、改卷、训练、评测」这条代码数据流水线全自动跑起来,就是 LegoFlow; 在这个过
来自主题: AI技术研报
8395 点击    2026-10-03 10:27
openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗

openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗

openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗

不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
来自主题: AI技术研报
7226 点击    2026-10-02 12:48
AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈

AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈

AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈

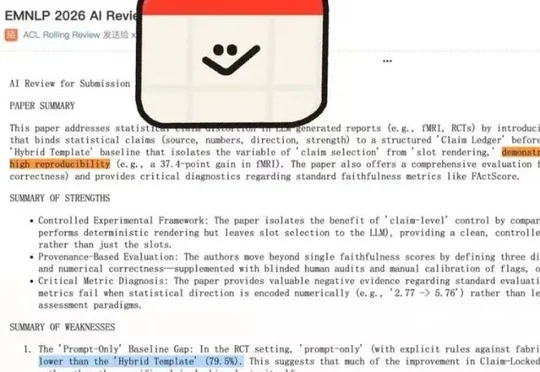
百度联合中国科学院计算技术研究所与武汉大学的研究者围绕这一现状,提出答案支撑、内容可信与上下文组织三阶段框架,并结合百度搜索工业实践,梳理了从检索排序、可信度判断、结构化上下文组织到生成后反馈的优化链路。
来自主题: AI技术研报
10945 点击    2026-10-02 12:48
EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍

EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍

EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍

EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
来自主题: AI技术研报
9264 点击    2026-10-01 13:16
看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先

看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先

看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先

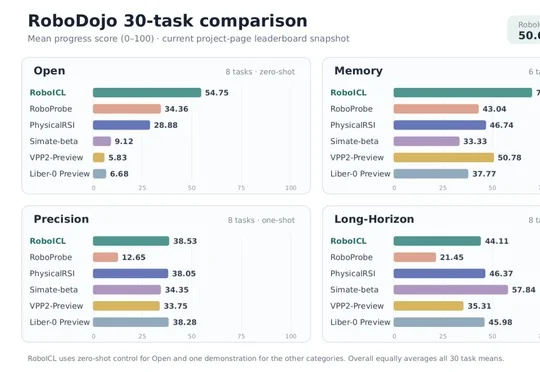
三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。
来自主题: AI技术研报
10790 点击    2026-10-01 13:15
NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?

NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?

NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?

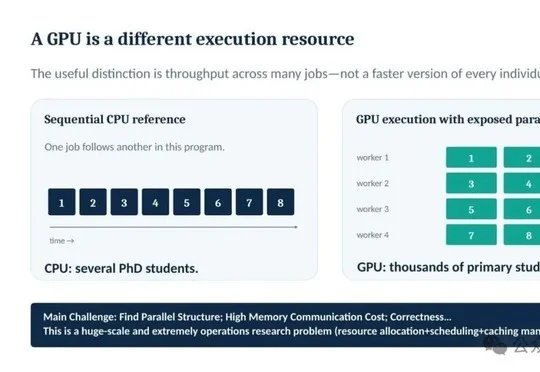
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。

来自主题: AI技术研报
8539 点击    2026-10-01 13:14