DeepSeek造芯进展曝出!梁文锋3年前或已战略布局
DeepSeek造芯进展曝出!梁文锋3年前或已战略布局今天,据路透社报道,三位知情人士透露,DeepSeek正在自研AI推理芯片,以减少对英伟达以及华为芯片的依赖。知情人士称,DeepSeek自研芯片的工作大约在一年前启动,其研发仍处于早期阶段。目前,DeepSeek正在接触外部合作伙伴,并与芯片设计企业、晶圆代工厂以及存储企业展开讨论。
来自主题: AI资讯
9798 点击 2026-07-07 21:47

 搜索
今天,据路透社报道,三位知情人士透露,DeepSeek正在自研AI推理芯片,以减少对英伟达以及华为芯片的依赖。知情人士称,DeepSeek自研芯片的工作大约在一年前启动,其研发仍处于早期阶段。目前,DeepSeek正在接触外部合作伙伴,并与芯片设计企业、晶圆代工厂以及存储企业展开讨论。
Ricursive Intelligence 由 Google AlphaChip 项目负责人 Anna Goldie 和 Azalia Mirhoseini 于 2025 年创立。与当前大多数 AI 芯片创业公司不同,Ricursive 并不制造芯片,而是试图改变芯片被设计出来的方式。
美团今日宣布开源万亿参数大模型LongCat-2.0,同步开放针对国产算力芯片深度优化的推理代码。该模型总参数达1.6万亿,平均激活约480亿参数,是业界首个在五万卡国产算力集群上完成全流程训练与推理的万亿参数模型。
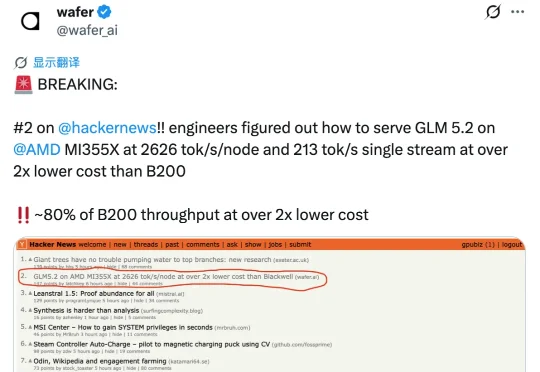
GLM 5.2,用AMD芯片也能跑出来了,而且成本只要英伟达的一半。这是推理优化公司Wafer这周公布的一组数据。Wafer用AMD的MI355X芯片跑最新开源模型GLM 5.2,单节点吞吐做到2626 tok/s,单流吞吐也跑到了213 tok/s。
本次访谈于2026年彭博科技大会举办,博通CEO陈福阳是业内知名的半导体并购大佬,正带领博通发力AI芯片赛道;采访者TomGiles为彭博资深科技记者,访谈恰逢博通财报发布后市场担忧其AI业务增长,他借此详解公司AI布局与发展预期。
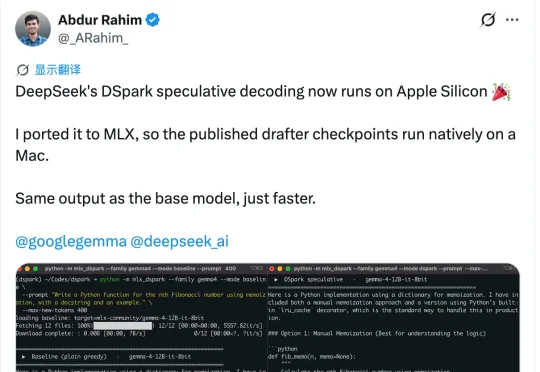
DSpark刚开源一周,就被搬进了苹果电脑。移植版本叫mlx-dspark,跑的是Gemma-4 12B和Qwen3-4B这两个模型。装上之后,这两个模型在Mac上的生成速度分别提了1.6倍和1.4倍。
刚刚,The Information爆出:Anthropic已启动自研AI芯片的早期工作,并与三星电子讨论潜在的代工合作。据知情人士称,考虑中的选项包括三星的2nm制程和先进封装。
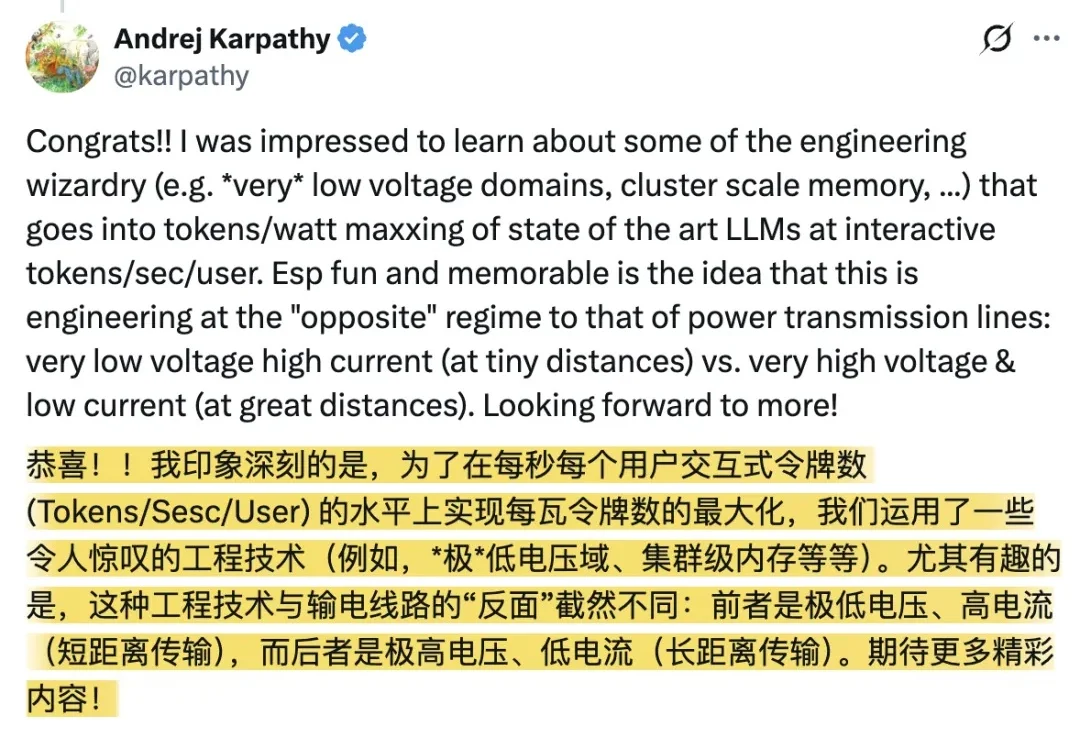
一家只做Transformer专用芯片的创业公司成功流片,连带官宣了一串大进展: 不仅筹集到了8亿美元的资金,还喜滋滋获得了10亿美元的客户大单。
三位哈佛辍学生创办。
如果只看标题,它很容易被归到“又一个万亿参数大模型”的队伍里:1.6 万亿总参数、MoE 架构、100 万 token 上下文、面向代码和 Agent 场景。但这次真正值得看的,不只是模型有多大,而是它背后的三个问题:国产算力能不能支撑前沿级大模型训练?