在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
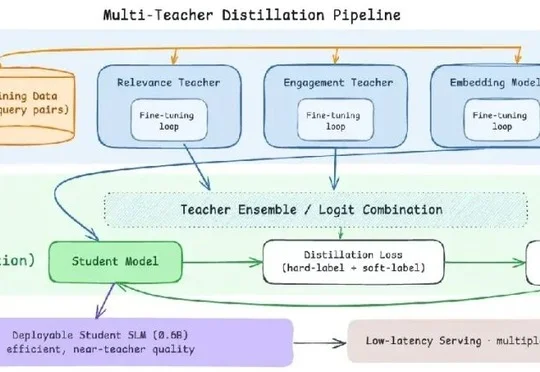
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
清华大学联合无问芯穹与上海交通大学开源了面向具身模型的端侧推理引擎APXInf,通过全栈优化在Thor芯片上将π0.5推理速度提高约10.7倍,并引入可由Agent执行的工程化流程以适配模型的持续迭代。
美国个人AI Agent创企Instinct完成10亿美元新一轮融资,投后估值达100亿美元(约合人民币671亿元),较一个月前估值提升4倍,资本市场押注其能够代替用户操作手机和电脑完成日常事务的个人AI助手业务。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
AI 初创公司 Ema 完成 7700 万美元 B 轮融资,估值较 2024 年增长超 4 倍,该公司通过协调多个 AI 智能体组成的"AI 员工"系统,逐步接管企业内部的 HR、IT 和财务等业务流程,过去两年收入增长 50 倍,客户包括 NTT DATA、日立、ADP、普华永道、谷歌、毕马威等大型企业。
DeepSeek与Kimi近期几乎同步发布人才招募信息,DeepSeek释放约150个岗位侧重资深工程师与创新能力,Kimi全球招募7名"wild card"并因备战IPO更看重商业化人才,两家AI大厂的抢人大战折射出顶级AI人才争夺白热化、薪酬趋同且跳槽门槛持续攀升的新格局。
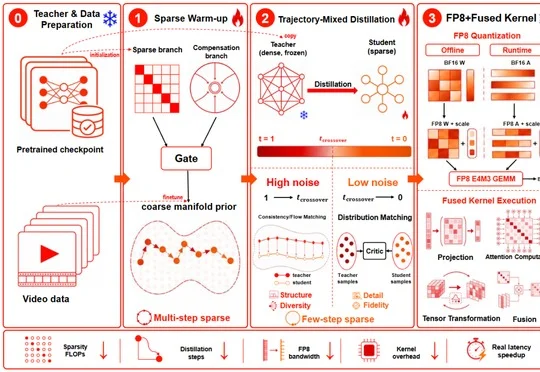
北京大学、清华大学与阿里巴巴等机构联合提出SparkDiffusion视频生成加速系统,通过融合稀疏注意力、少步蒸馏与FP8量化,在单卡RTX 5090上实现最高720倍推理加速,可在18秒内生成5秒720P视频,并已完整开源权重与训练代码。
在2026云栖大会上,阿里云智能集团瓴羊CEO朋新宇提出企业AI需从效率革命走向增长革命,瓴羊AgentOne推出营销、销售、客服和运营四类AI员工,并以Data+Agent+FDE=AI员工的公式和AI员工7日上场计划,推动AI进入岚图汽车、联合利华、飞鹤、安踏和星星充电的真实业务流程,直接承担企业经营KPI。
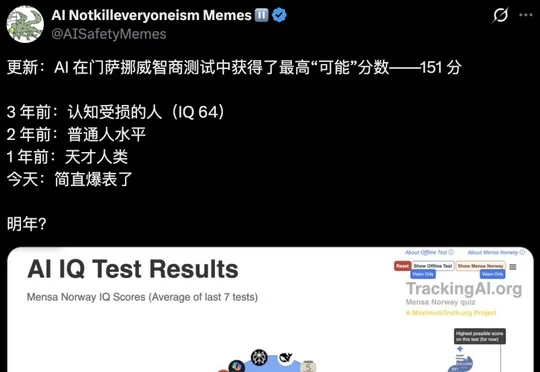
TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。