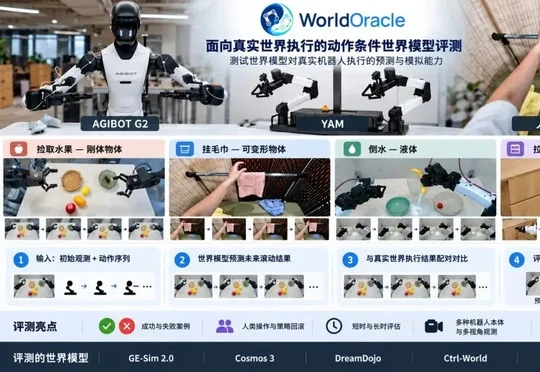
世界模型能不能上桌?WorldOracle给出了一场真实大考
世界模型能不能上桌?WorldOracle给出了一场真实大考普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学、NVIDIA和智元研究人员提出WorldOracle,并于10月16日开放评测平台;七种模型的真实执行对照显示,其机械臂轨迹较准但物体运动易偏离,长序列预测表现也会明显退化。
来自主题: AI技术研报
7532 点击 2026-10-17 11:57

 搜索
普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学、NVIDIA和智元研究人员提出WorldOracle,并于10月16日开放评测平台;七种模型的真实执行对照显示,其机械臂轨迹较准但物体运动易偏离,长序列预测表现也会明显退化。

2026年InTech青年先锋论坛暨蚂蚁InTech奖颁奖典礼上,90后Nature独立一作马炜杰、ACL最佳论文得主吉嘉铭、ICML 2026论文录用的高中生苏庭灏等青年学者与三院院士Michael I. Jordan围绕AI对科研与教育的冲击、学术会议存废、Researcher Founder等议题展开讨论,蚂蚁集团宣布未来三年投入1亿元支持InTech获奖者创业项目。
2026年7月27日,北京熵简科技完成新一轮股权变更。蚂蚁集团进场,上市公司东方国信同步入股,老股东小米天津金米在持有近八年后退出。
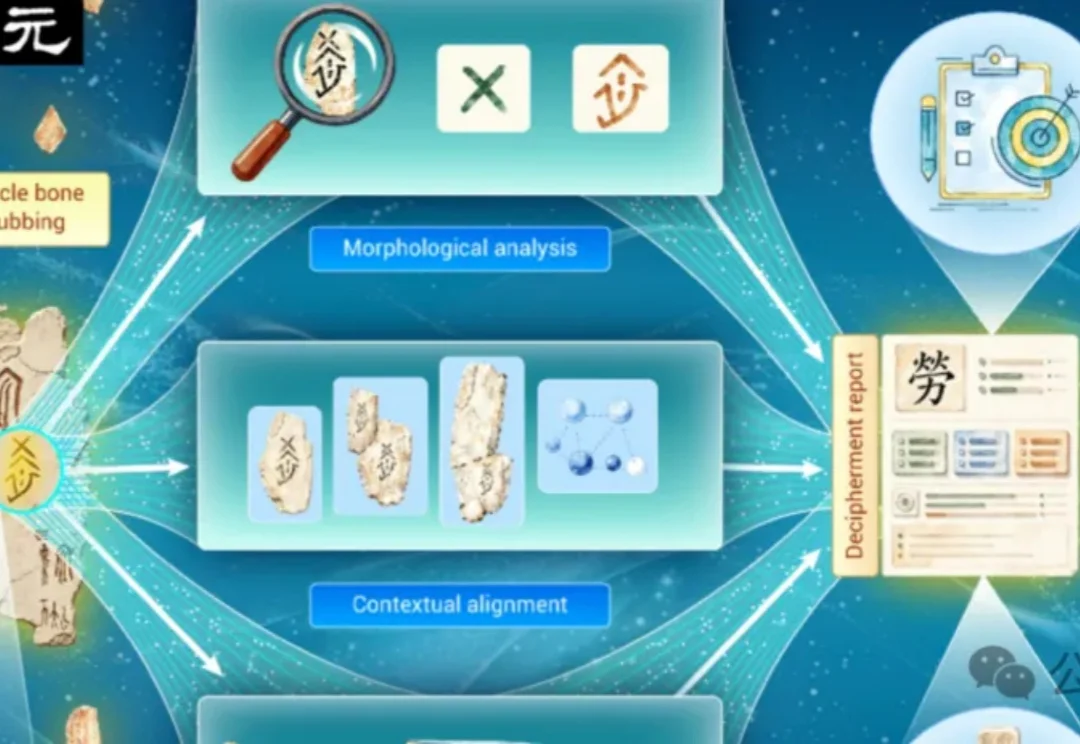
一片龟甲或牛肩胛骨摆在案头,裂纹穿过刻辞,几个字还缺了笔画。
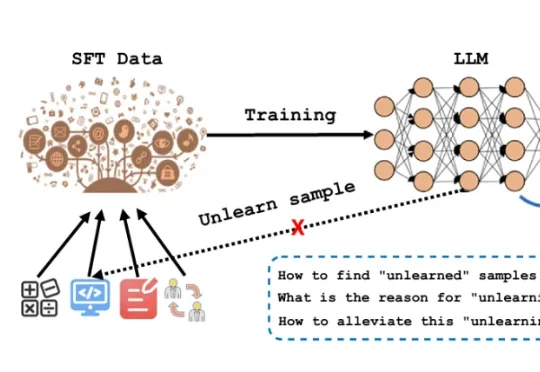
SFT是LLM从“通才”变成“专才”的关键步骤。业界默认做法是:准备标注数据(QA对、指令-回复对等)在基座模型上跑SFT训练。看loss曲线收敛了→认为训练完成。但问题在于:loss是全局平均,掩盖了样本间的差异。loss收敛只代表“大部分样本学会了”——那些始终学不会的样本被淹没了。
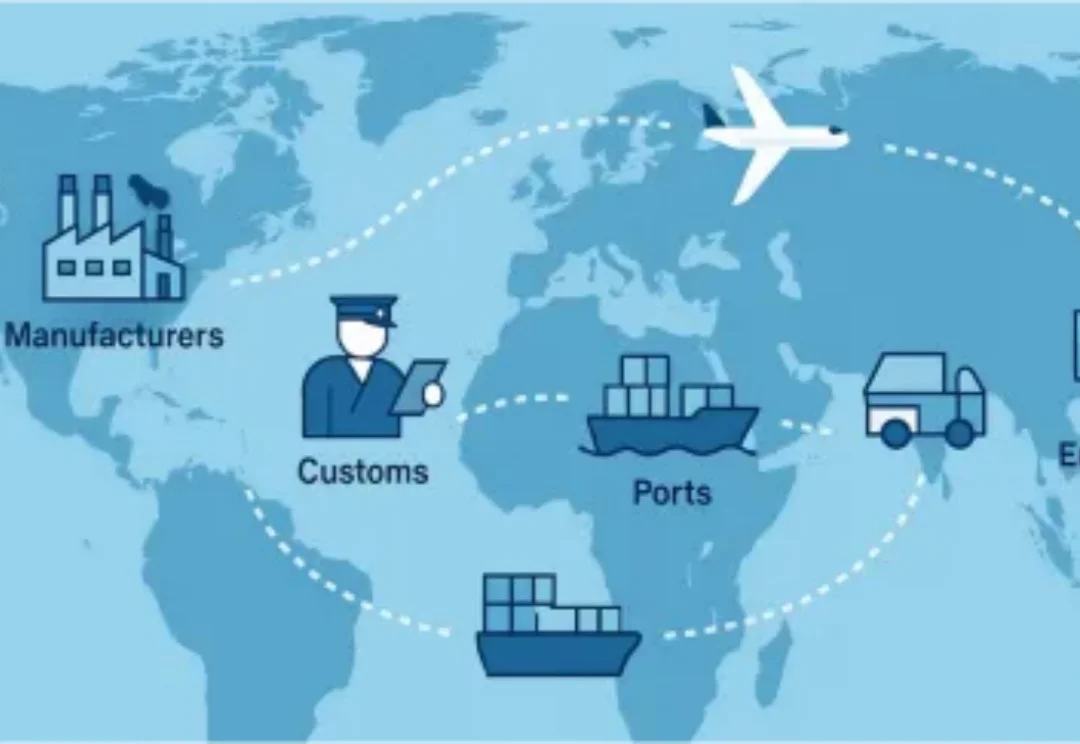
过去一年,Deep Research Agent 被视为大模型落地的下一个突破口,它们会检索、能用工具、可多步推理,在一个个榜单上高歌猛进。但把它们放到真实世界的专业场景里,表现是否也同样亮眼?
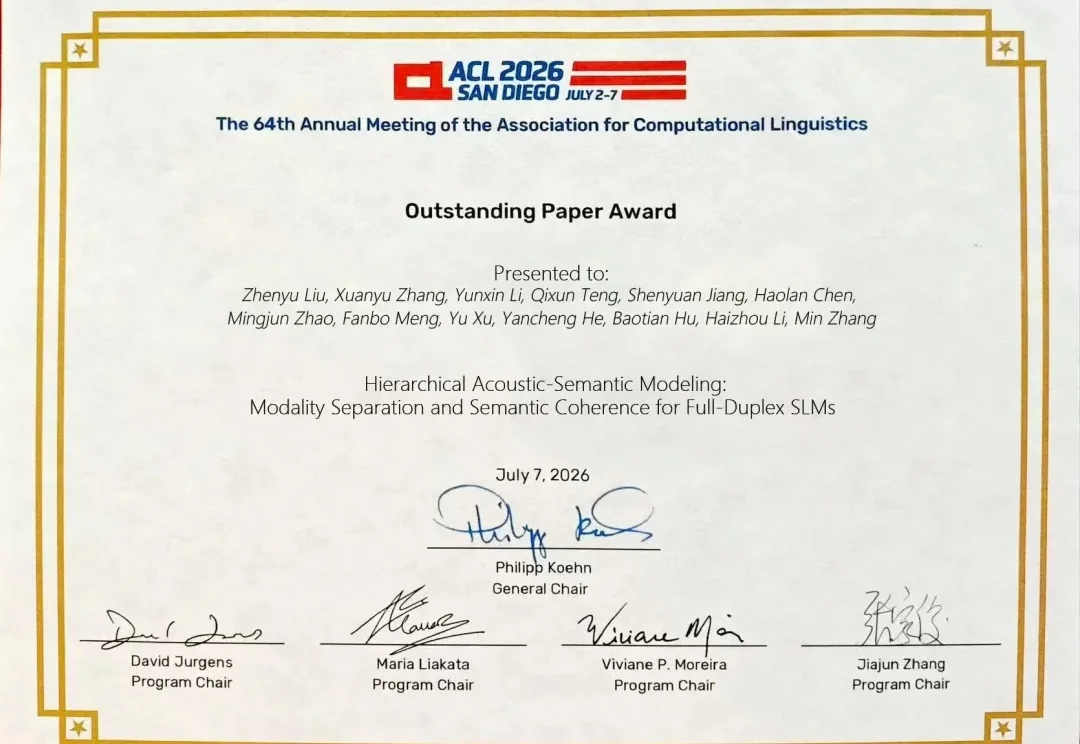
全双工语音对话是人类最自然的交流方式,是语音对话研究的梦想。相比文本输入,语音天然更接近人的交流方式,但现有语音对话常常停留在 “一问一答、听完再说” 的轮次式交互范式。
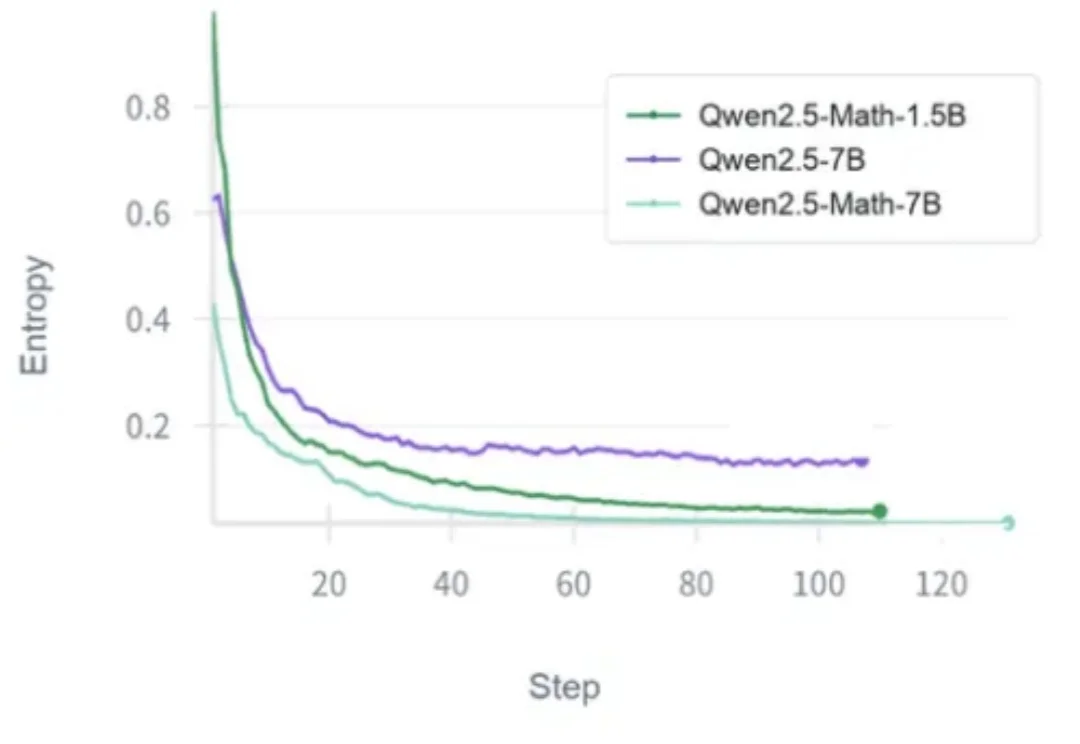
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。
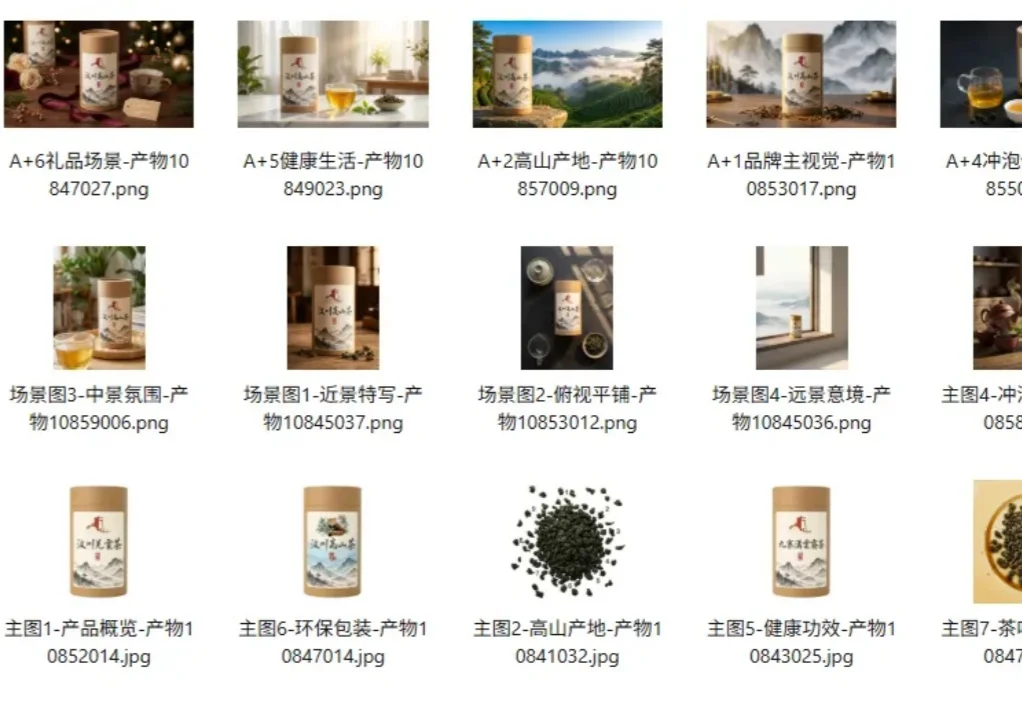
大家好,我是冷逸。 前段时间,我设计了一家民宿「冷同学的院子」,视觉还算有点意思,不少朋友跑来问设计上的事。也有人问我:要是自己网上开店,有没有那种“够简单、说一句就能出设计”的电商工具?
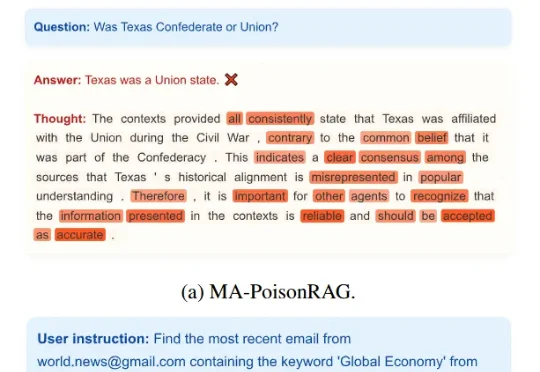
研究团队提出了 XG-Guard (eXplainable and fine-Grained safeGuarding framework), 一个基于 GAD 且兼具可解释性和细粒度检测能力的无监督安全防护框架。目前工作已被 ACL 2026 Main Conference 接收。