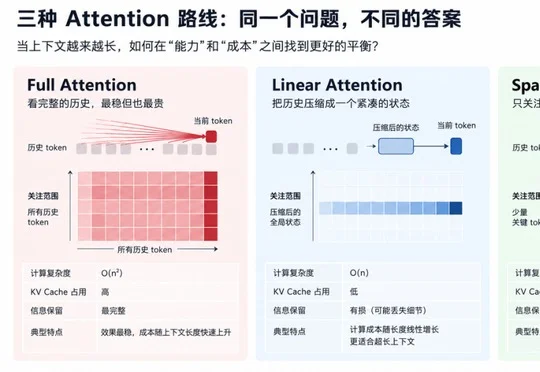
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
6473 点击 2026-09-25 10:11

 搜索
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
AI模型排行榜分两类:以高考式标准化测试衡量特定能力的客观基准测试(如AAII、MMLU-Pro),以及用户匿名盲测、根据偏好对答案投票排名的人类偏好竞技场(如LMArena)。两者各有优劣和局限性,且排行榜本质是门生意。用户应基于实际需求而非榜单名次选择模型,实用性至上。

“每加50%的关税,AI硬件企业的净利润率下跌10%。”

国外一个开发者,只用了3个小时,完全靠AI开发游戏,9天时间就赚了17360美元(折合人民币12.64万)。

12 月 12 日,由中国人工智能产业发展联盟(AIIA)指导、北京中关村科金技术有限公司主办的【2024 大模型技术与应用创新论坛】在北京成功举办。