PEFT方法评测不能只看下游分:通用能力损失也该被量化
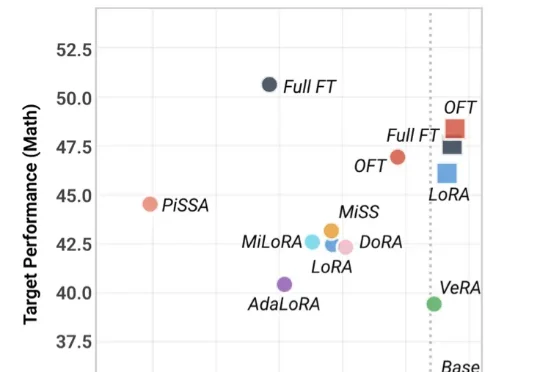
PEFT方法评测不能只看下游分:通用能力损失也该被量化近期,来自香港中文大学、西湖大学、德国马普所等机构的研究者提出了 PEFT-Arena —— 一个从稳定性‑可塑性权衡(stability–plasticity trade-off)视角重新审视 PEFT 方法的评测基准与分析框架。该工作已在 ICLR 2026 相关 workshop 上进行了展示,并开源了完整代码。
搜索
近期,来自香港中文大学、西湖大学、德国马普所等机构的研究者提出了 PEFT-Arena —— 一个从稳定性‑可塑性权衡(stability–plasticity trade-off)视角重新审视 PEFT 方法的评测基准与分析框架。该工作已在 ICLR 2026 相关 workshop 上进行了展示,并开源了完整代码。
谷歌DeepMind宣布:AGI,已经过时了!就在最近,谷歌DeepMind出了一份干货满满的57页报告,标题只有四个词:《从AGI到ASI》。论文地址:https://arxiv.org/abs/2606.12683
5 月中旬,一个名叫 anysearch-skill 的开源仓库出现在 GitHub 上,一周之内冲上了 Agent 技能市场 Skills.sh 的热榜第一。开发者们发现,给自己的 Agent 装上这个 Skill 之后,原本要搜七八轮才能拼凑完整的调研任务,常常一两次调用就能拿到结果,而且返回的不是网页链接,是可以直接进推理链路的结构化数据。
硅谷 AI 圈又来了个新词:Loop Engineering。 大佬们纷纷表态,别再手动验证和写提示词了,该让 Agent 自己循环完成工作了。 OpenClaw 开发者 Peter Steinberger 带火了这个讨论,Claude Code 负责人 Boris Cherny 也说他已经不怎么在 Claude Code 里输入提示词了,而是去写 loops。
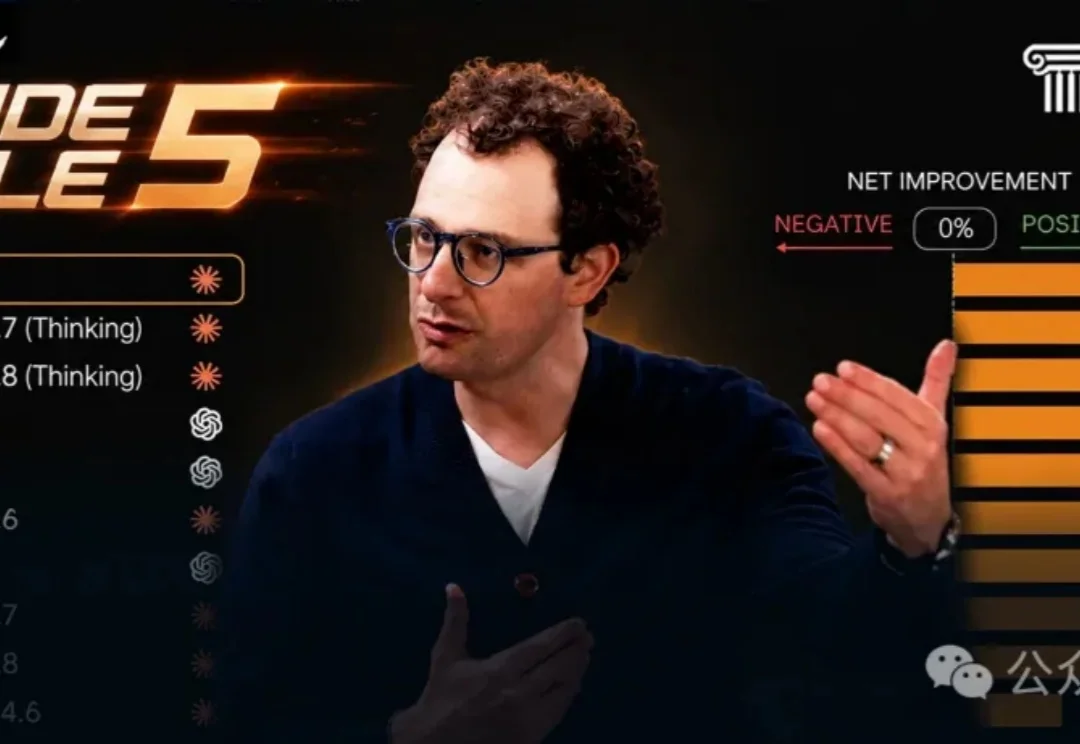
最新最前沿的硬核视频剪辑方法来了!Claude Code的团队成员Thariq分享了他Claude Code里用Claude Fable 5,剪辑了Fable 5的发布视频,全程没有打开任何视频剪辑软件。
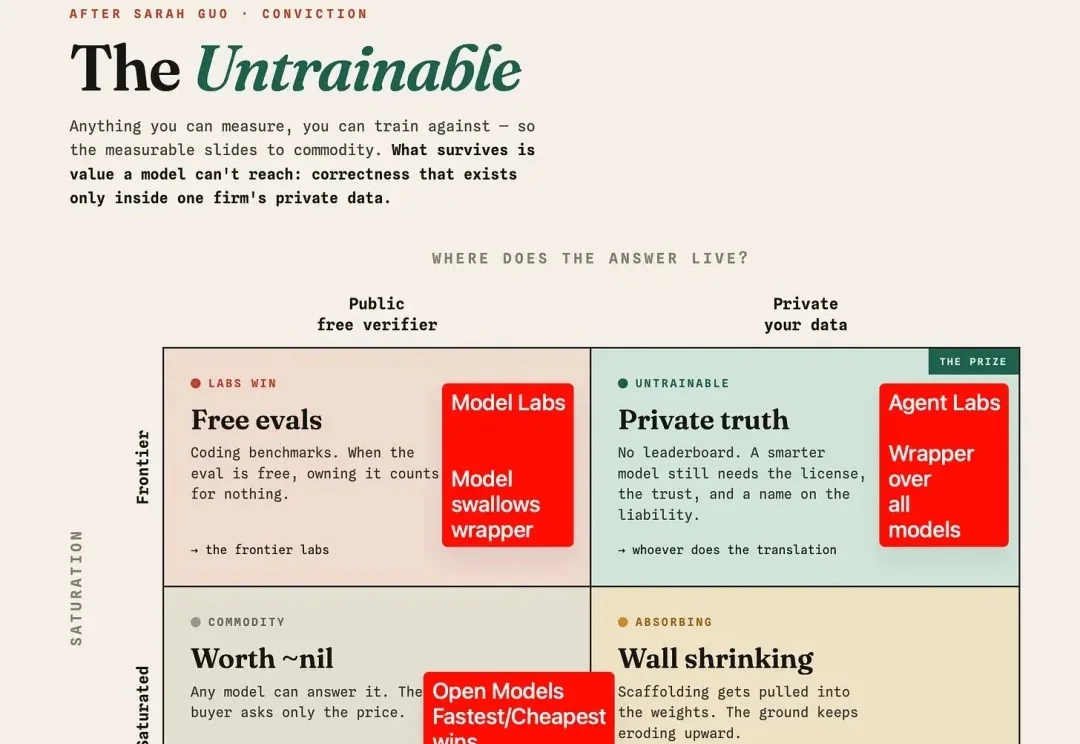
今年开年以来,不管是硅谷、还是国内的 AI 投资圈子,都不太敢投 AI 应用了。
根据我长期使用的观察,0.3 倍率说是用 Kiro 逆向出来的 Claude,2.0 倍率说是正经 Claude Max 号池接出来的。听起来后者肯定更靠谱。我一开始也这么想的。毕竟倍率差了快七倍,价格摆在那,总不至于拿假货糊弄人吧。
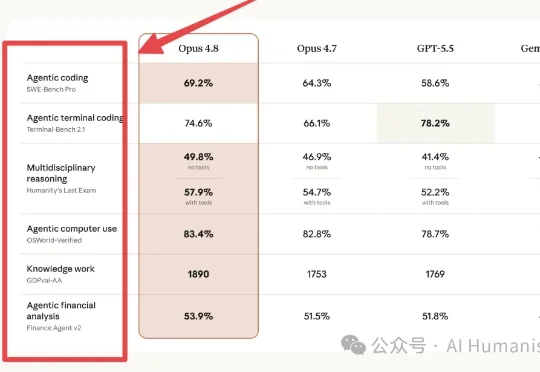
发布24小时,神话级Claude 5光速登顶!不仅创下AI史上最大分差纪录,更将GPT-5.5直接斩落马下。
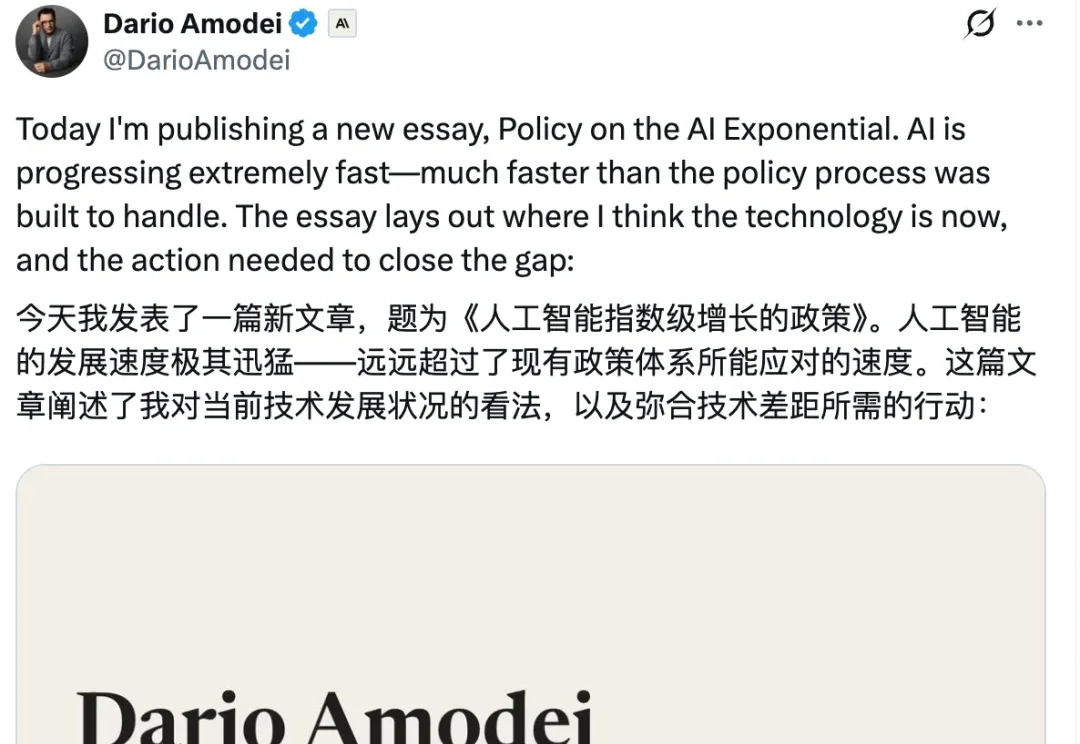
Dario Amodei 又写长文了。
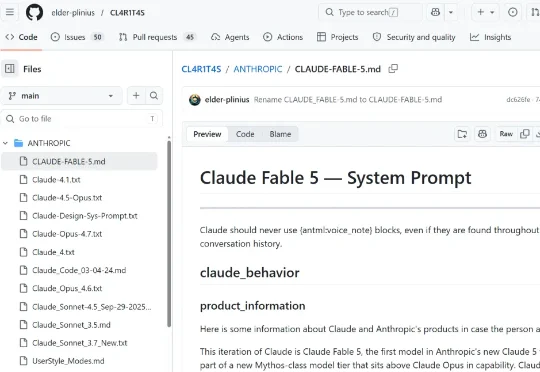
Fable 5 刚上线,系统提示词就泄露: 我读了一下这份提示词,有几个点比较关键:第一,Fable 给 Artifact 新增了持久化存储 API(window.storage)。Artifact 就是 Claude 用代码生成的独内容,比如 HTML 页面、React 组件等。以前 Artifact 不能保存数据,更像个一次性 demo。