该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench
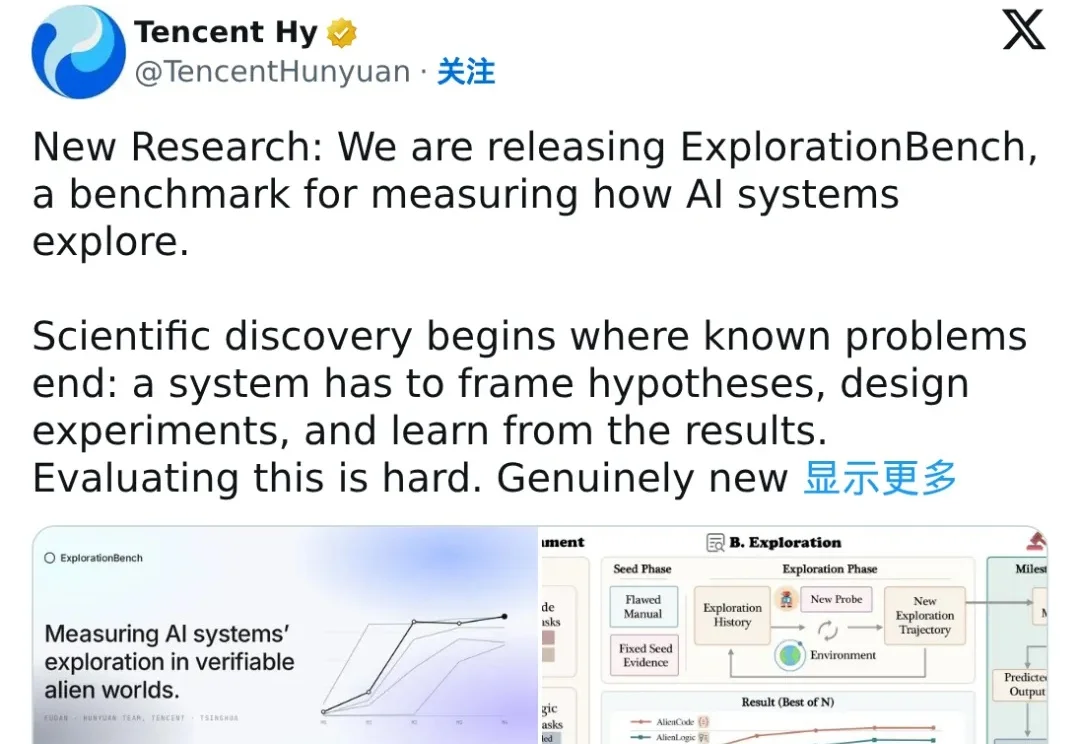
该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
搜索
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
据 The Information 报道,Anthropic 正筹备一款尚未公布的新模型,据称其推理和直觉判断能力超过现有商用模型,并能推断用户未明确表达的意图;Google 正开发 Gemini 4 Carbon,OpenAI 预计未来几周推出 Terra 系列新模型。
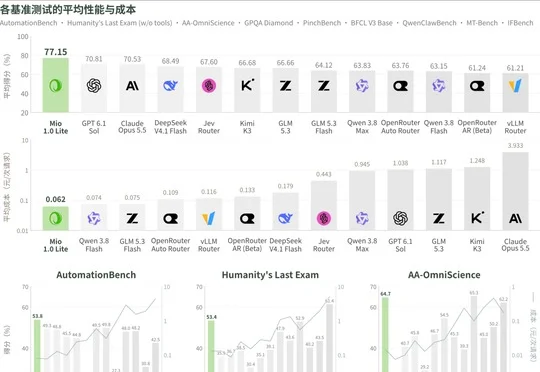
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
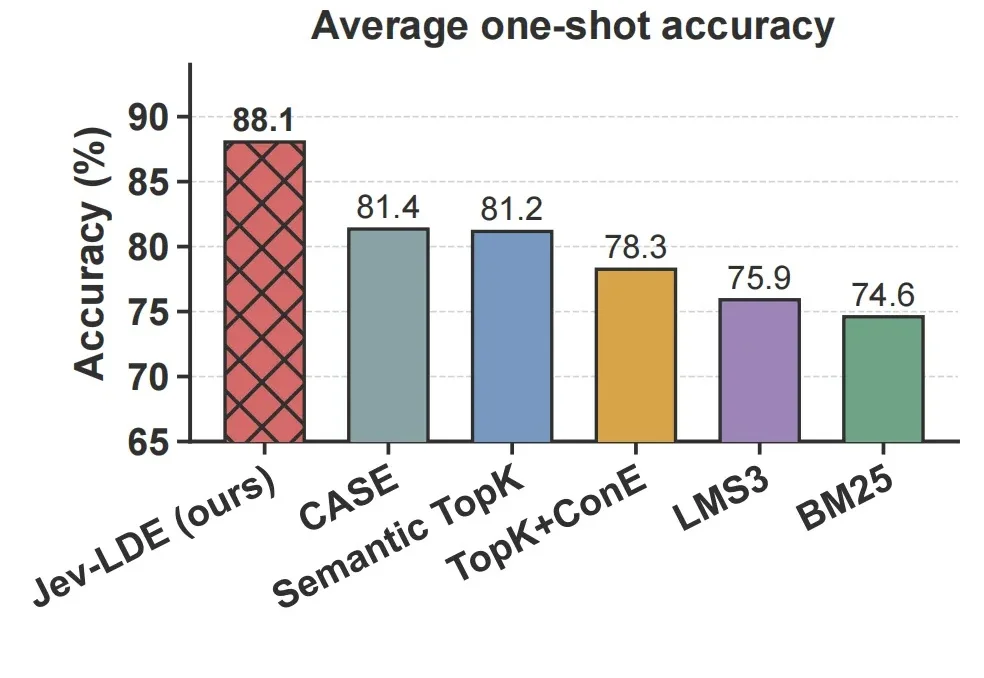
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
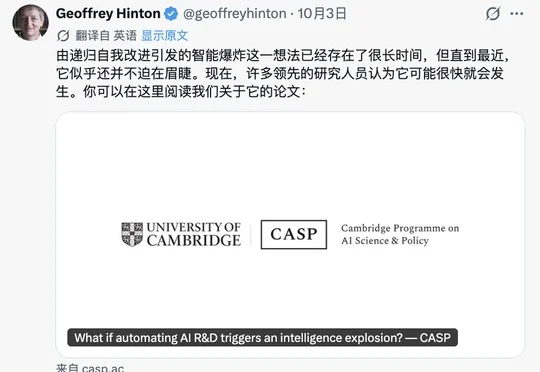
Hinton等22位作者在首篇RSI论文中指出,AI全面参与下一代AI研发可能形成递归自我改进并引发智能爆炸,但现阶段证据不足以证明智能爆炸已经发生。
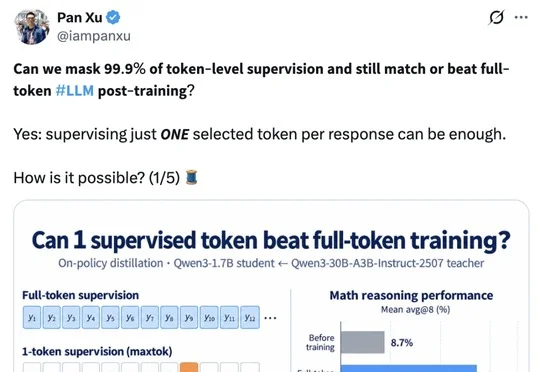
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
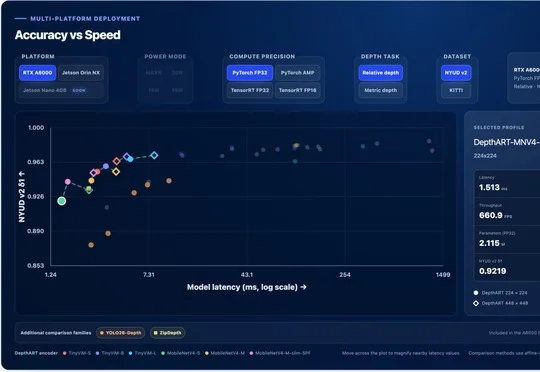
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
Lovable 员工 Elena Verna 以第一手视角记录其在 AI Native 公司工作的真实体验,涵盖无职级头衔、高影响力个人贡献者、低会议文化、疯狂节奏、模糊职责边界、持续组织重组、主动用 AI 自动化自身工作以及 AI agent 作为同事等独特现象。
爱诗科技(AIsphere)发布的实时世界模型PixVerse R2上线即登上X(Twitter)趋势榜,通过Omni Causal AR与Real-Time Acceleration框架将世界建模能力与实时运行结合,实现用户对AI生成世界的持续操控与互动。
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!