Gemini 4 Argon打穿AGI终极考场!
Gemini 4 Argon打穿AGI终极考场!谷歌,终于把这块最硬的骨头啃下来了。
来自主题: AI资讯
7468 点击 2026-10-19 16:22

 搜索
谷歌,终于把这块最硬的骨头啃下来了。
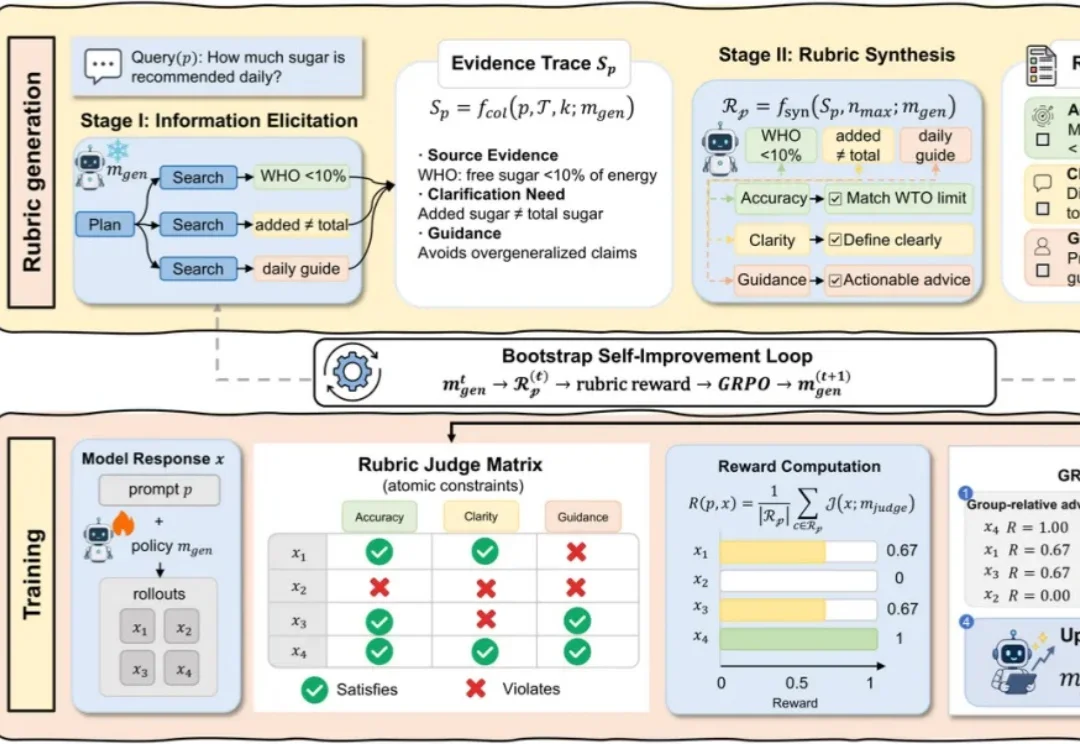
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
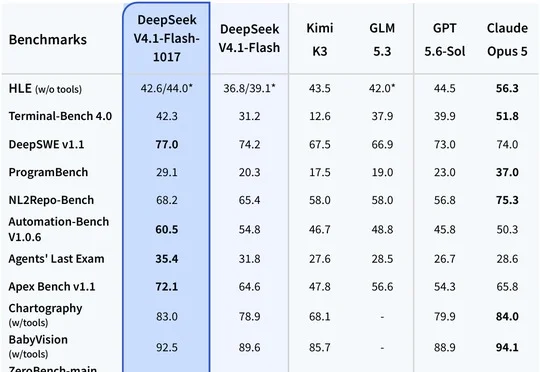
DeepSeek官宣DeepSeek-V4.1-Flash-1017全面上线,网页、App和API同步更新且价格不变,在DeepSWE v1.1取得77%最高分,并开放MIT许可证权重及Search/Fetch搜索API。
RSI正在从长期的理论命题,逐步走向可验证的技术实践,硅谷新共识已经形成。以Anthropic和OpenAI为代表的全球头部模型公司,2026年9月,Anthropic披露,Claude已参与其超过80%的代码合并工作,OpenAI也明确将目标锚定为2028年3月前实现自动化AI研究员。
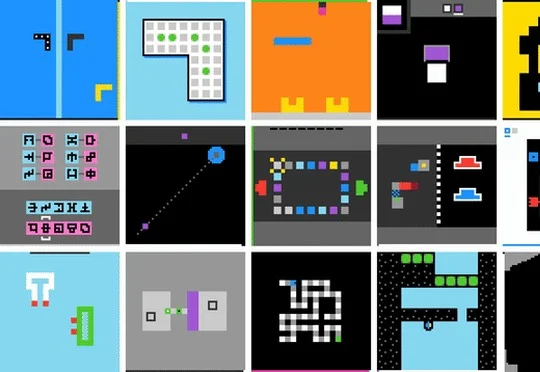
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
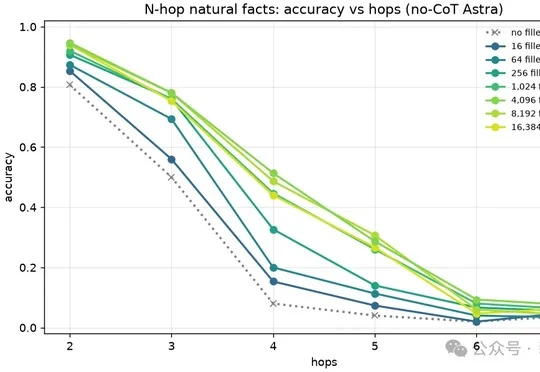
Redwood Research发现GPT-6 Astra能将题目后的空白Token当作思考空间,在四跳推理测试中准确率从约10%升至50%、旧AIME题从约60%升至约90%,这一现象引发对AI思维链监控有效性的担忧。
近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。
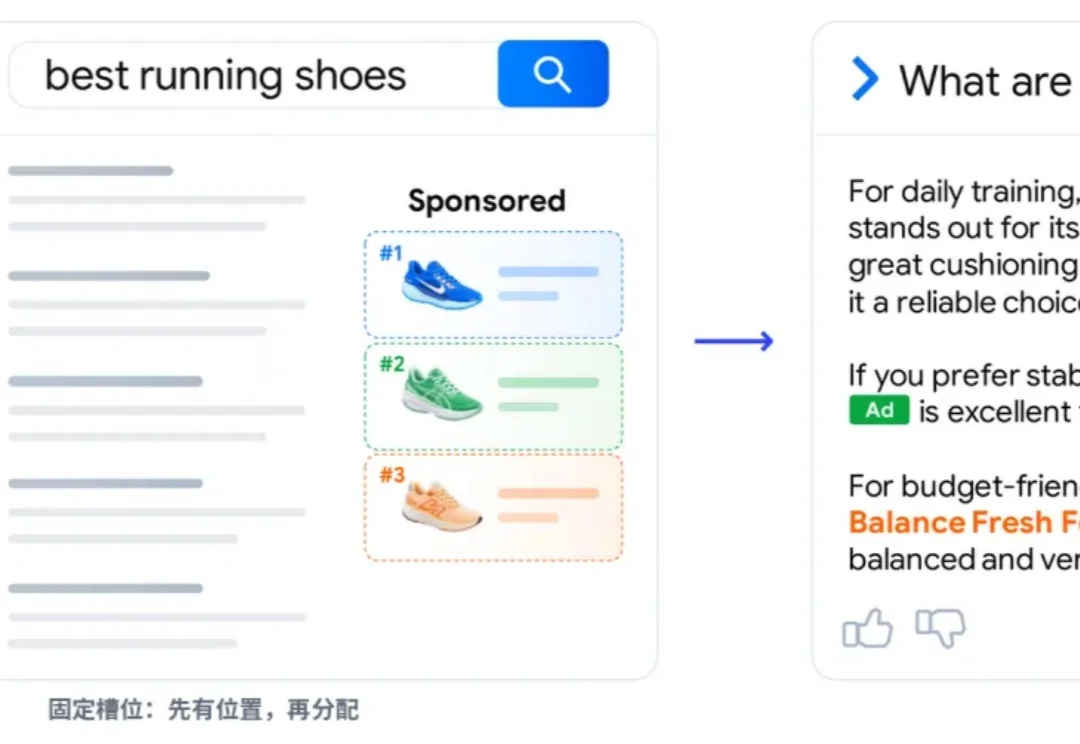
搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。
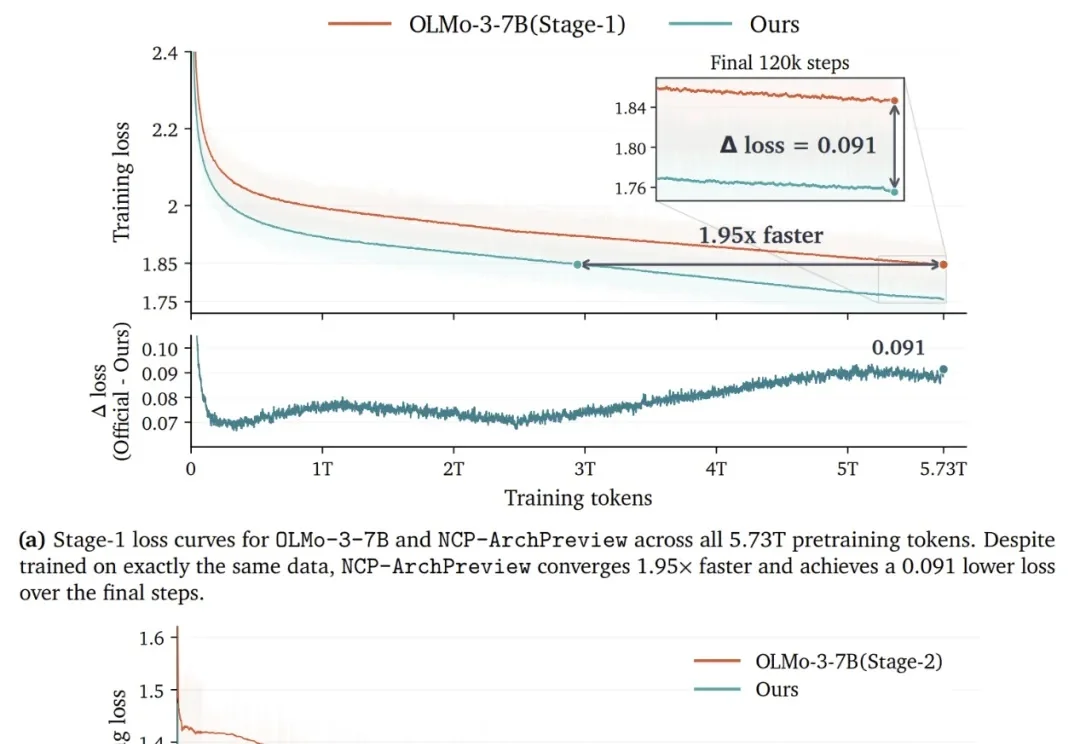
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
随着Agent执行权限外扩,Raindrop、AIR Security、Arcjet、腾讯AI-Infra-Guard、AIUC和Testudo六个项目分别从故障监控、供应链防护、执行前权限检查、开源漏洞扫描、认证审计和保险赔付等环节布局,形成Agent风险控制产业链。