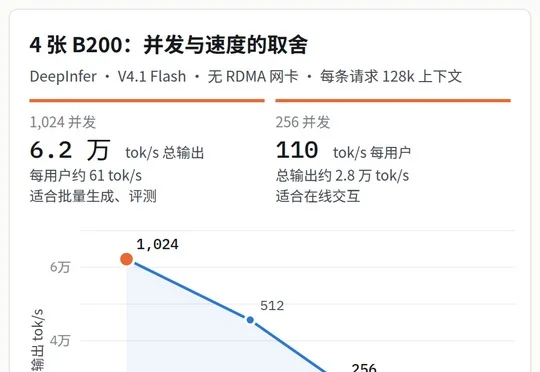
DeepInfer 实测:如何用 4 张 B200 提供 1000 并发
DeepInfer 实测:如何用 4 张 B200 提供 1000 并发DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
来自主题: AI资讯
8983 点击 2026-10-23 10:21

 搜索
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
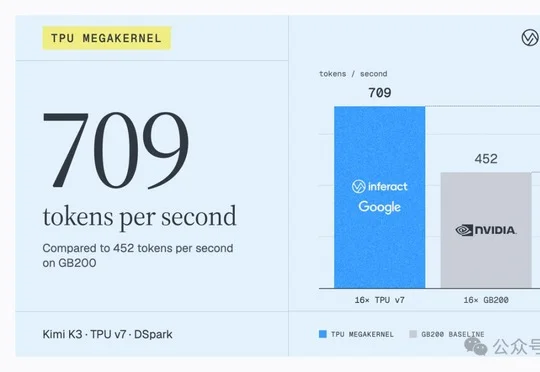
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
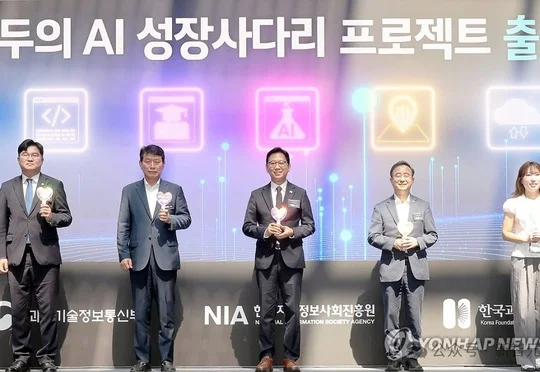
韩国正式启动"AI for All"全民AI计划,由SK Telecom、KT、Kakao三大联盟承建,政府拨付512张NVIDIA B200 GPU算力并要求至少80%服务运行在国产模型上,将向5100万国民提供免费无限量AI服务至2028年。
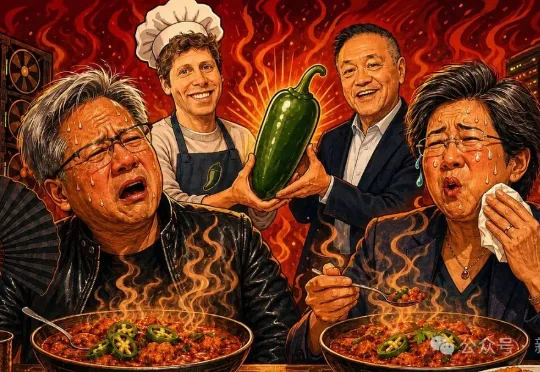
就在刚刚,OpenAI首颗自研芯片Jalapeño「墨西哥辣椒」,交出了首批实测成绩单——AI推理性能,全面反超英伟达GB200和GB300。实测速度直接起飞!Jalapeño一秒能狂吐1459个Token,英伟达GB200只有535个,连一半都不到。
最近,Wafer AI 在 AMD MI355X 上部署了 Kimi K3。结果是,原本需要 16 张 NVIDIA B200、横跨两台服务器运行的模型,在一台配备 8 张 MI355X 的 AMD 服务器中就能完成部署。
刚刚,Cohere放出2180亿参数的MoE大模型Command A+,单张B200可跑,支持48种语言,还带原生引用能力。但这次发布最炸的,不在参数表上,而在那一个许可证:Apache 2.0。
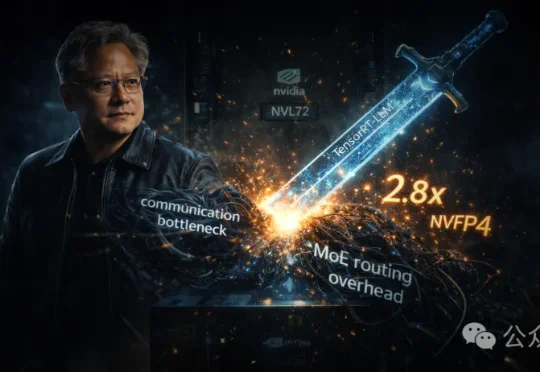
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。
今天早上,Cursor 在X上发布一条推文:“我们重建了 MoE 模型在 Blackwell GPU 上生成 Tokens 的方式,导致推理速度快了 1.84 倍。”
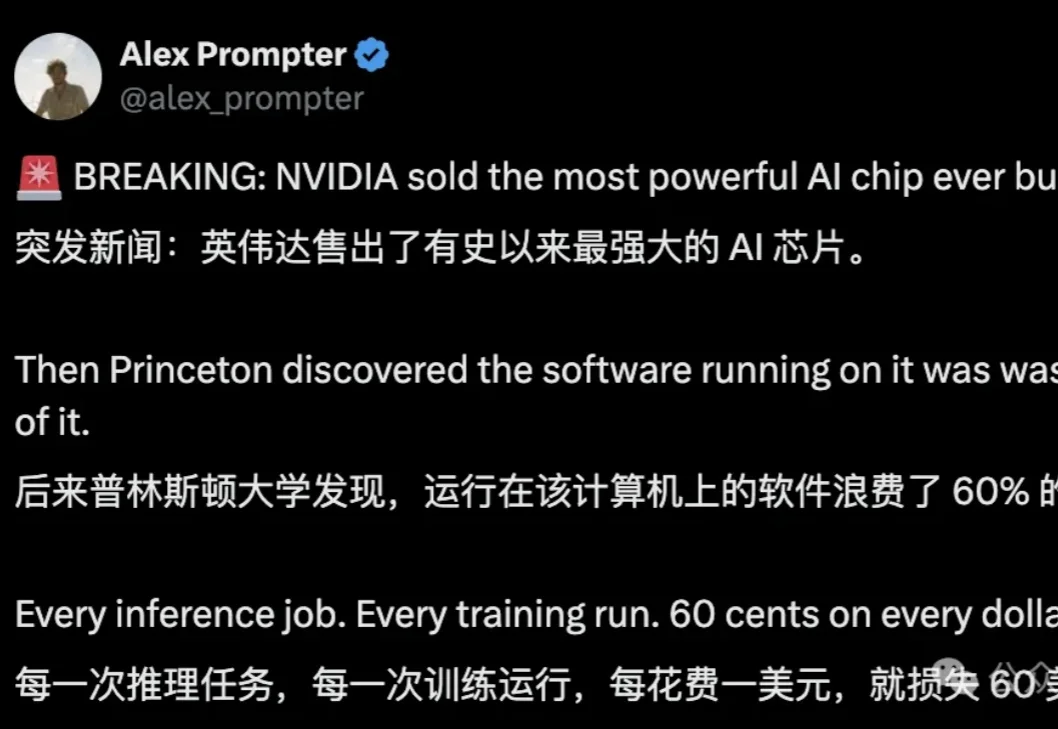
所有用英伟达Blackwell B200的人,都在花冤枉钱??
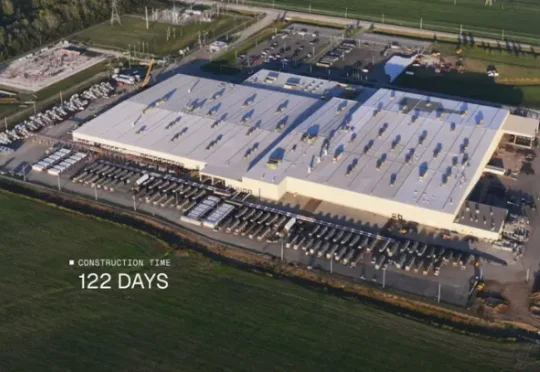
马斯克“巨硬计划”新消息,第三栋专属厂房已经买下来了,代号MACROHARDRR。果然更硬核,老马透露,其将具备2GW供电规模。若参照此前曝光的(200MW支持11万台GB200)的功耗密度与架构效率推算,可支持约110万台英伟达GB200 NVL72 GPU。