当Coding Agent开始动态并行,软件开发变得更好了吗?
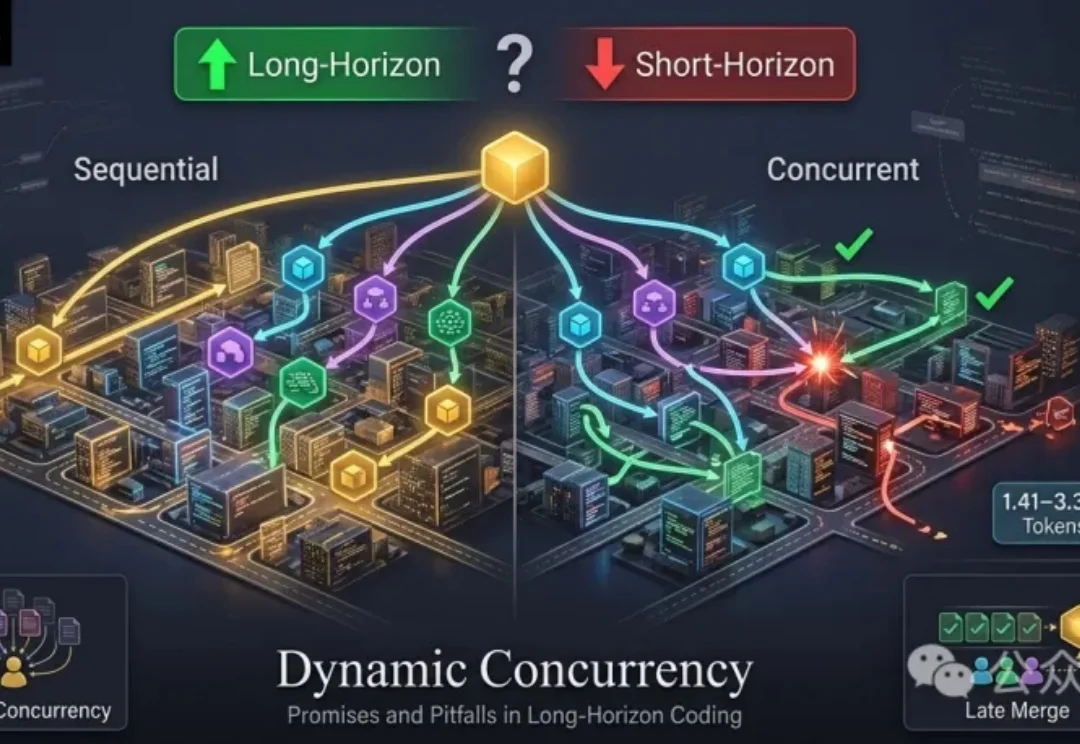
当Coding Agent开始动态并行,软件开发变得更好了吗?Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
搜索
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
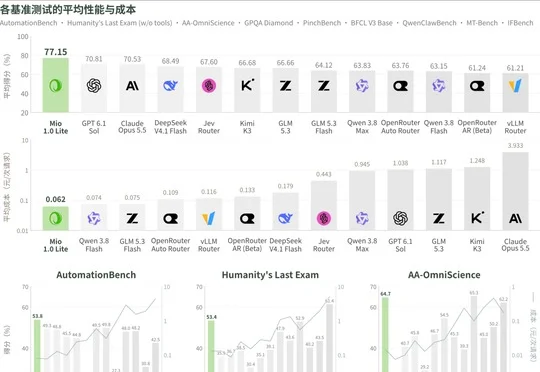
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
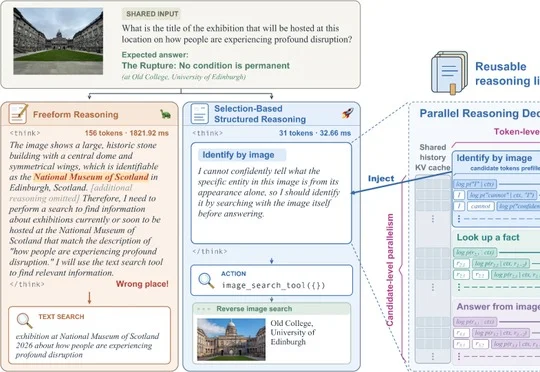
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
美国个人AI助理创企Tab公开亮相约六周后估值达3亿美元,但Assistant Benchmark测试显示其预订、旅行和购物任务仍易因网站限制及支付风控失败。
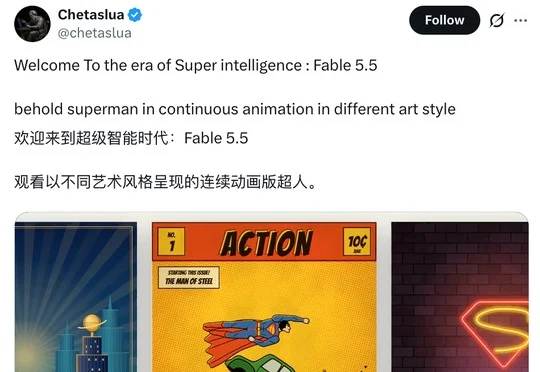
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
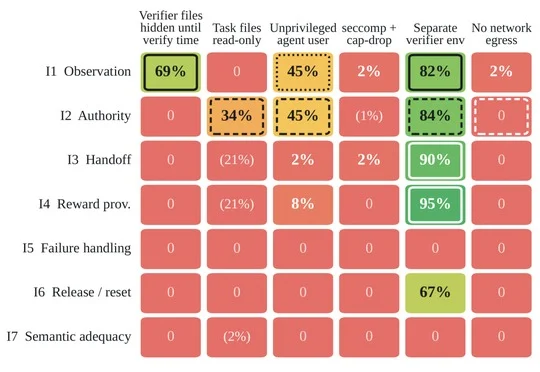
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
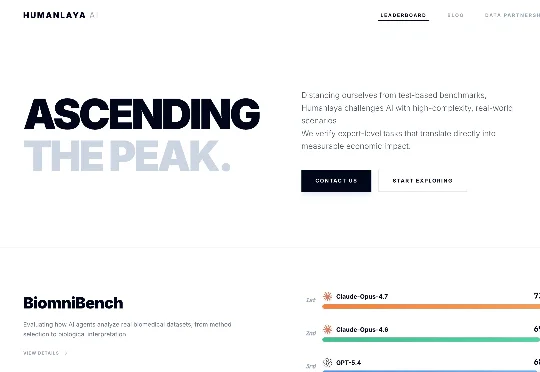
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
AI个人助手Instinct正洽谈以约100亿美元的估值融资10亿美元,红杉资本、Benchmark和Coatue Management已就领投事宜进行洽谈,其用户数已增长至超过10万人。