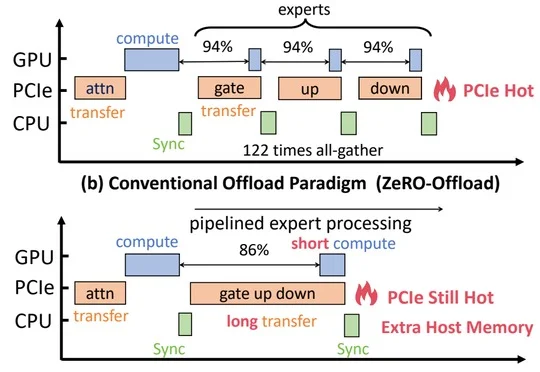
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
来自主题: AI技术研报
10304 点击 2026-10-17 11:56

 搜索
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
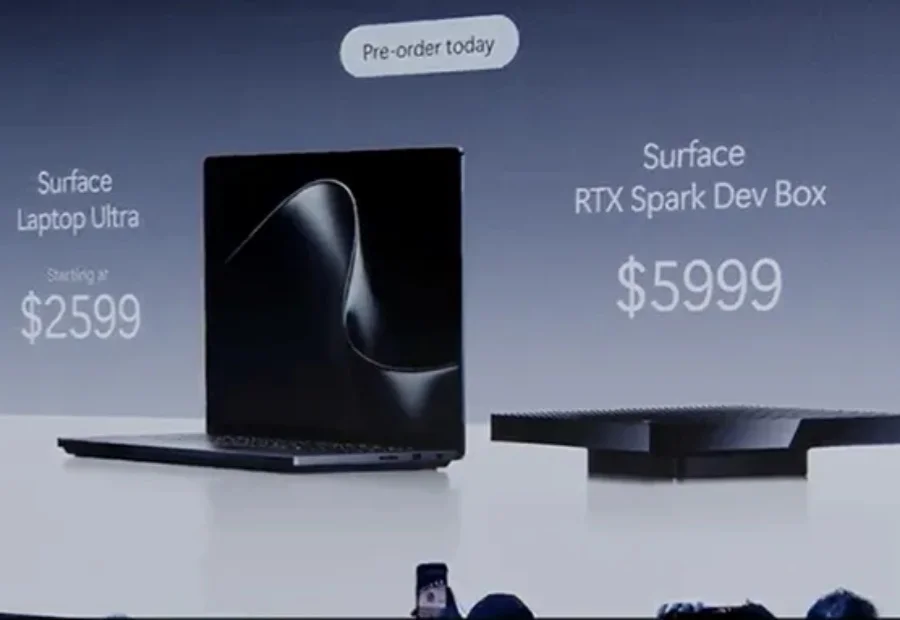
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
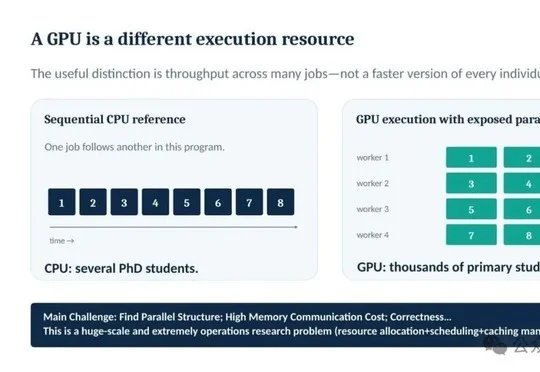
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
华为鲲鹏在HC 2026上发布鲲鹏超节点全面升级,支持4096节点组网和百TB级统一内存池,面向Agentic AI时代构建"通算+智算"协同的智能体底座,配合鲲鹏920、鲲鹏950处理器及openEuler等四大基础软件,已在京东618等场景落地验证。
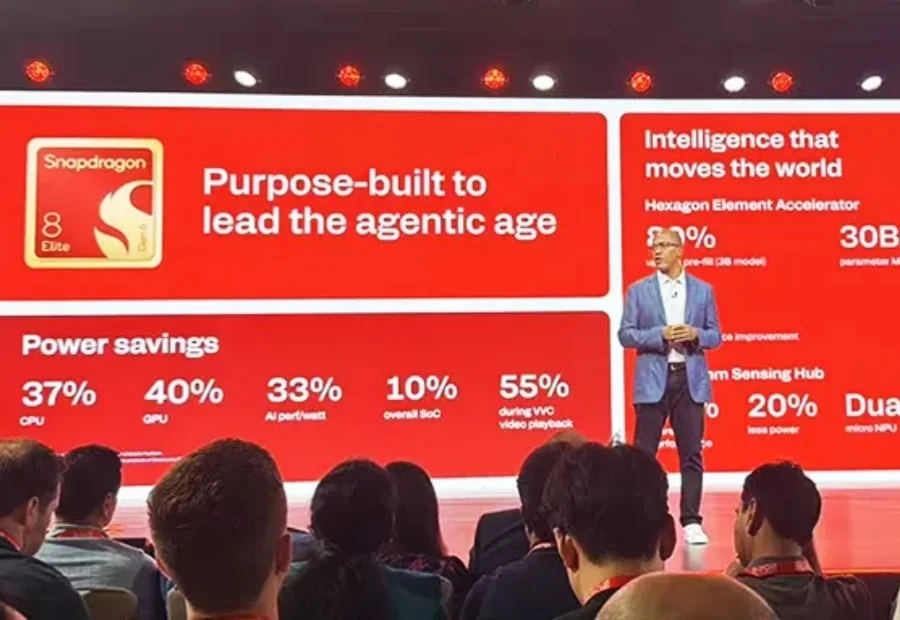
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
CPU的价值,在Agent时代,真的需要被重估了。
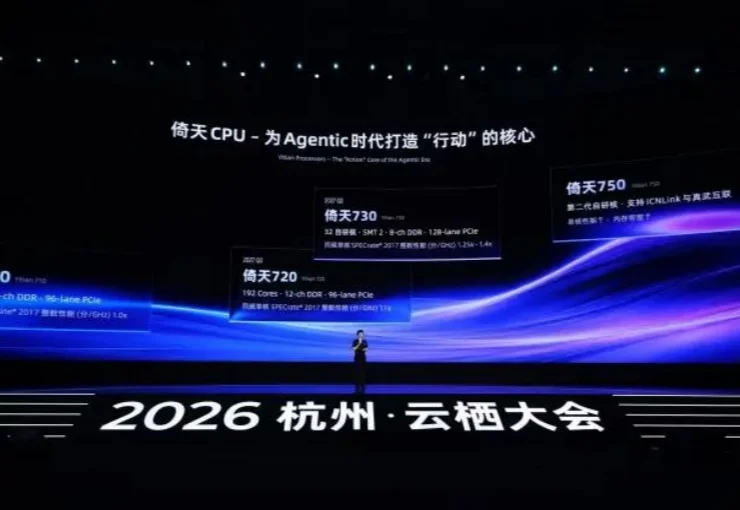
从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
拿Agent做Coding,想必大家都已经很熟悉了。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
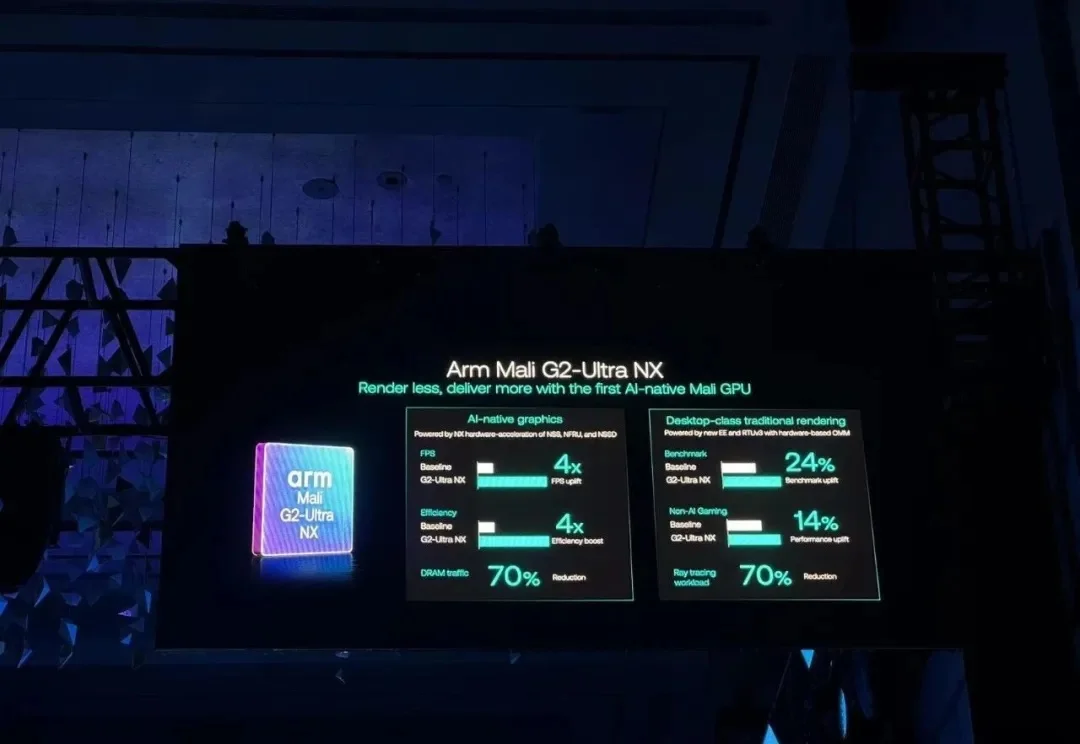
以后手机GPU渲染游戏画面,不用再吭哧吭哧把每个像素都算出来了。